显卡的秘密:为什么你的游戏画面能流畅到飞起?🎮
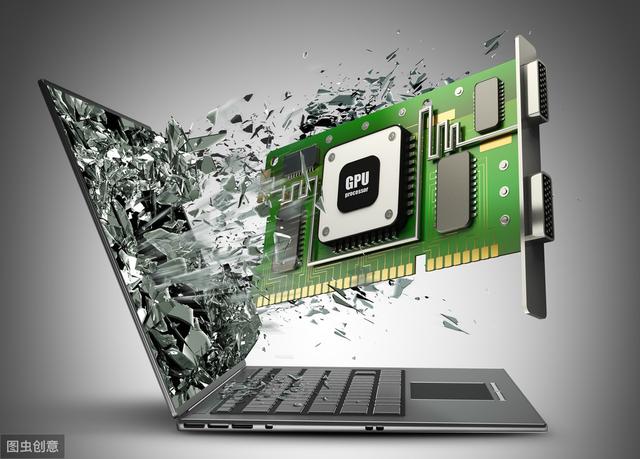
你有没有想过,当你沉浸在《赛博朋克2077》的霓虹夜景中,或者和队友在《绝地求生》里刚枪时,是谁在背后默默支撑着这一切?没错,就是那块躺在你机箱里的显卡。但你真的了解它吗?今天,我们就来扒一扒GPU那些不为人知的秘密,看看它到底是怎么做到让游戏画面流畅如丝滑的。
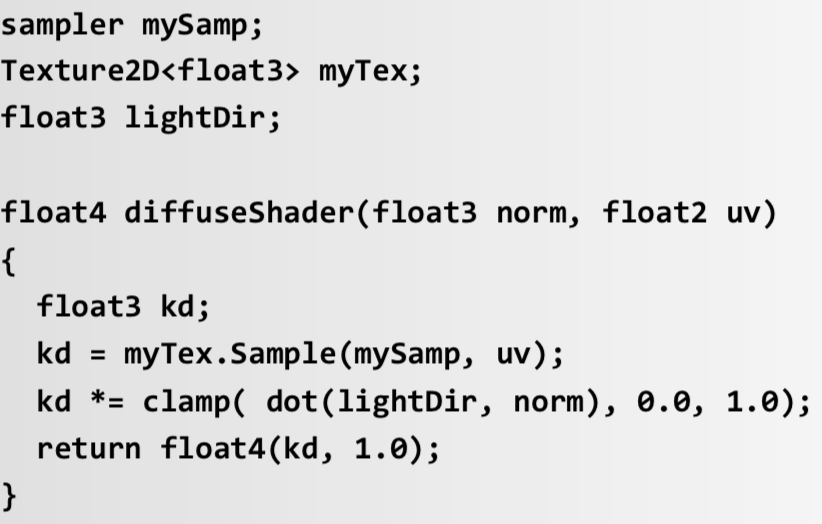
从一个小小shader说起
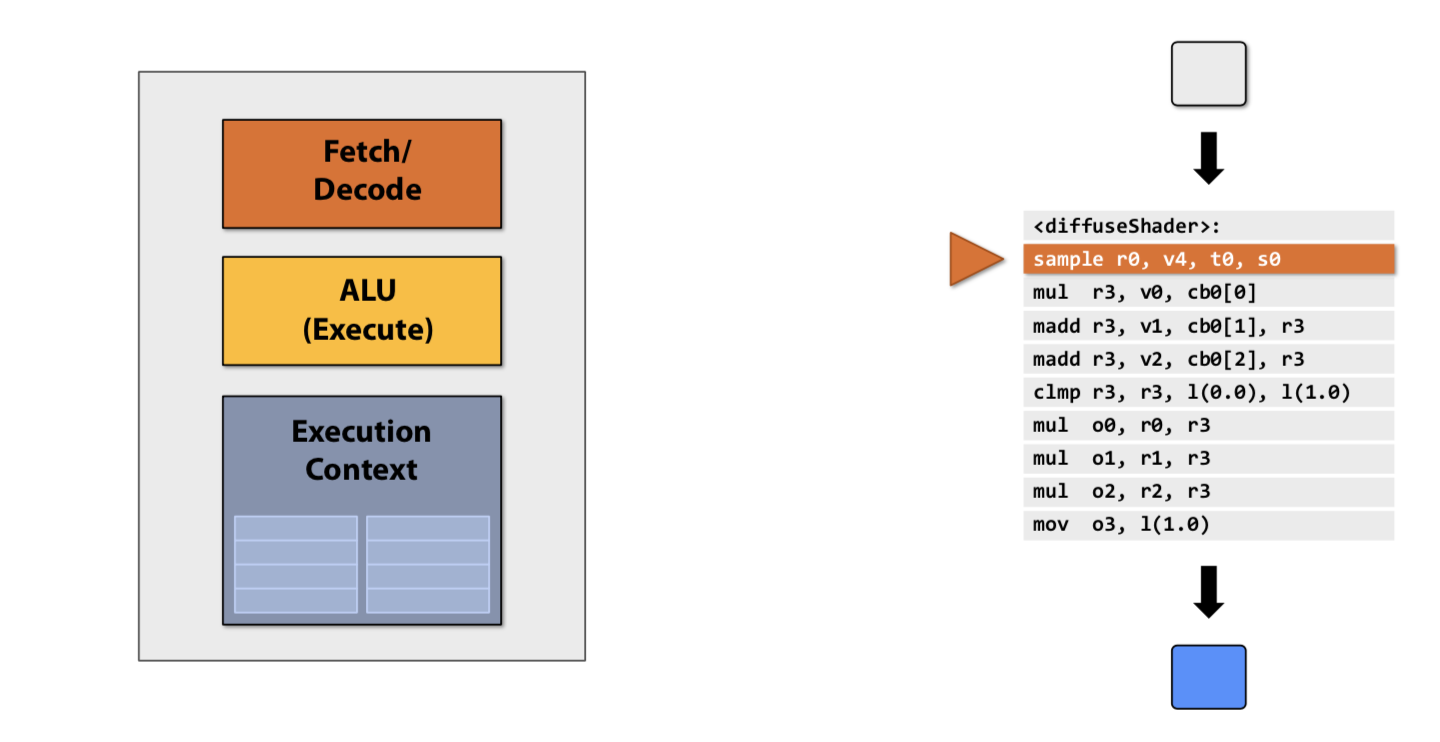
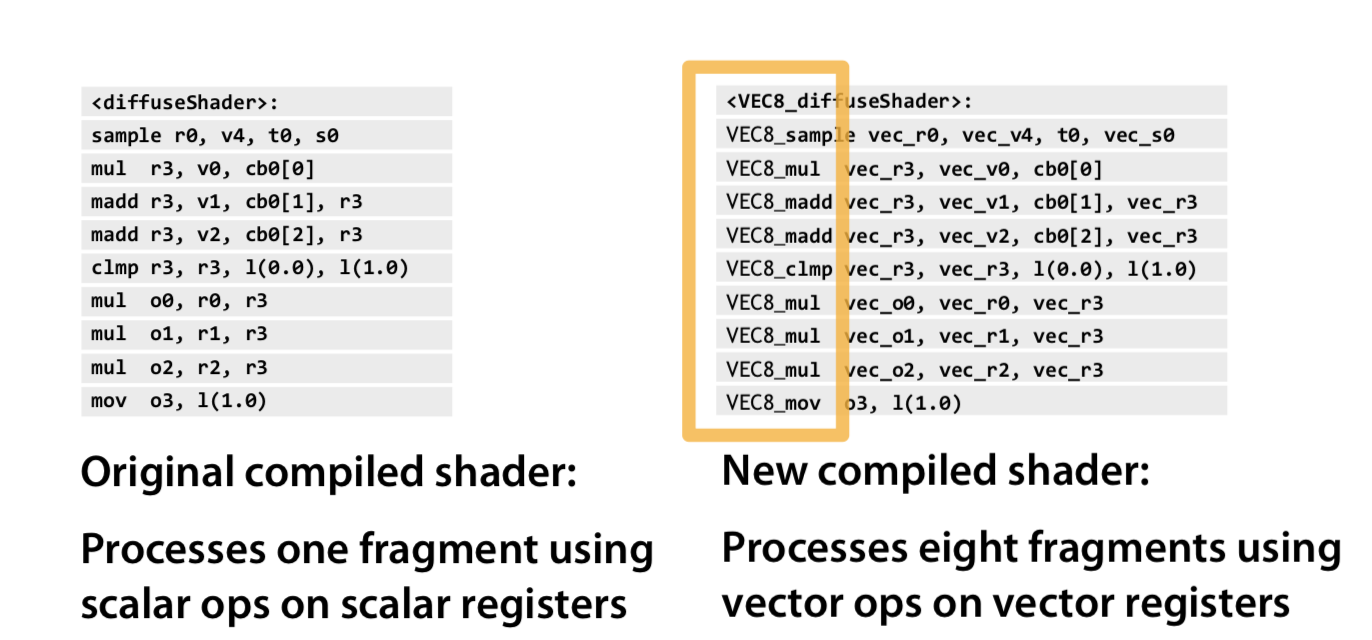
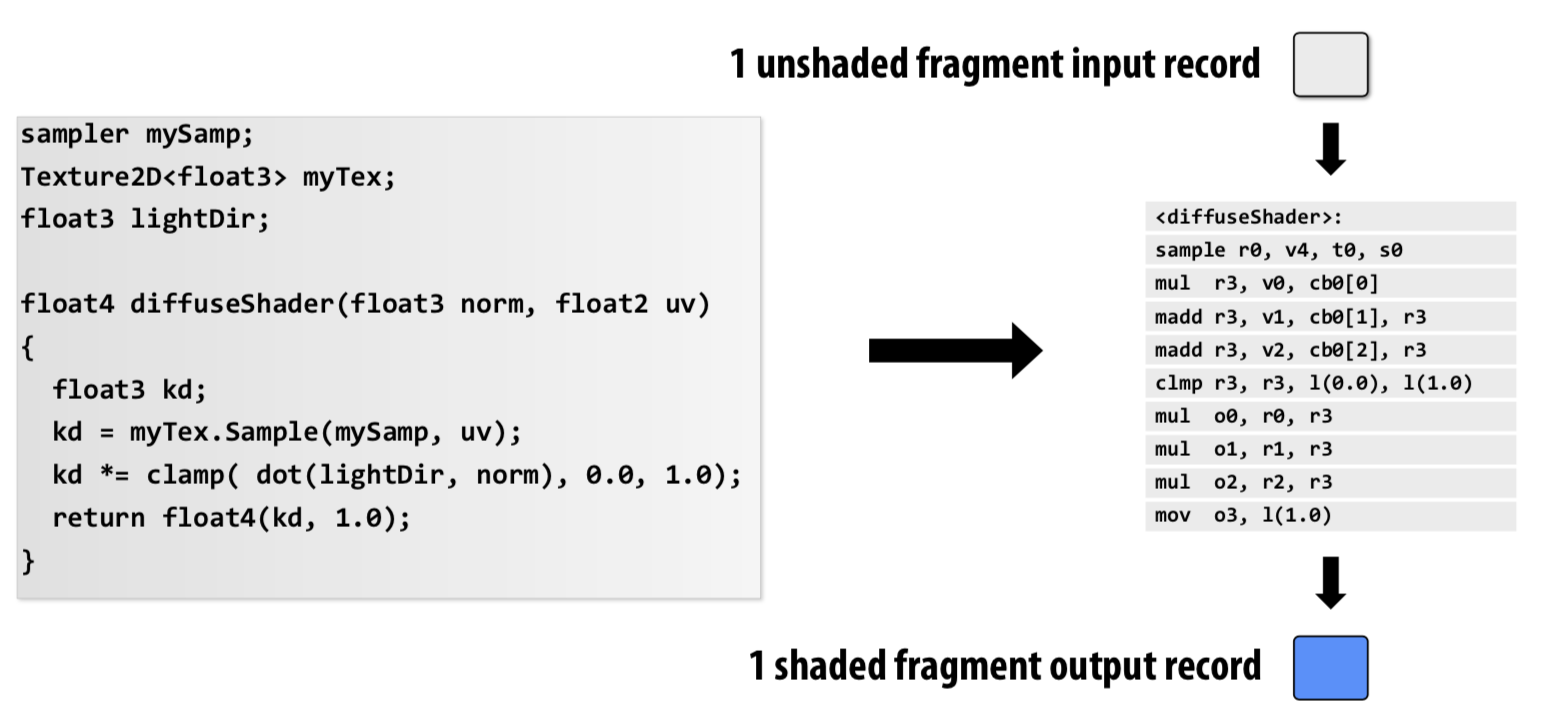
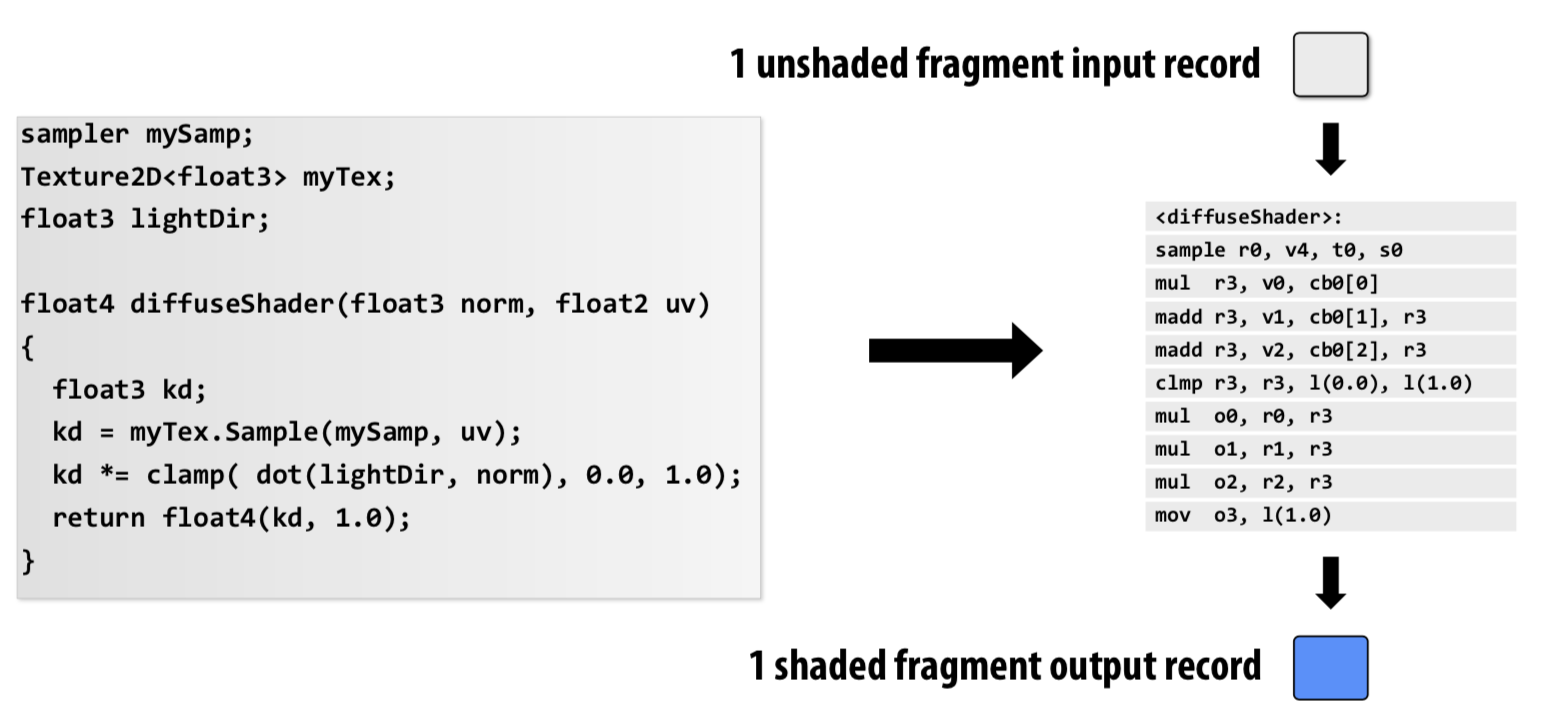
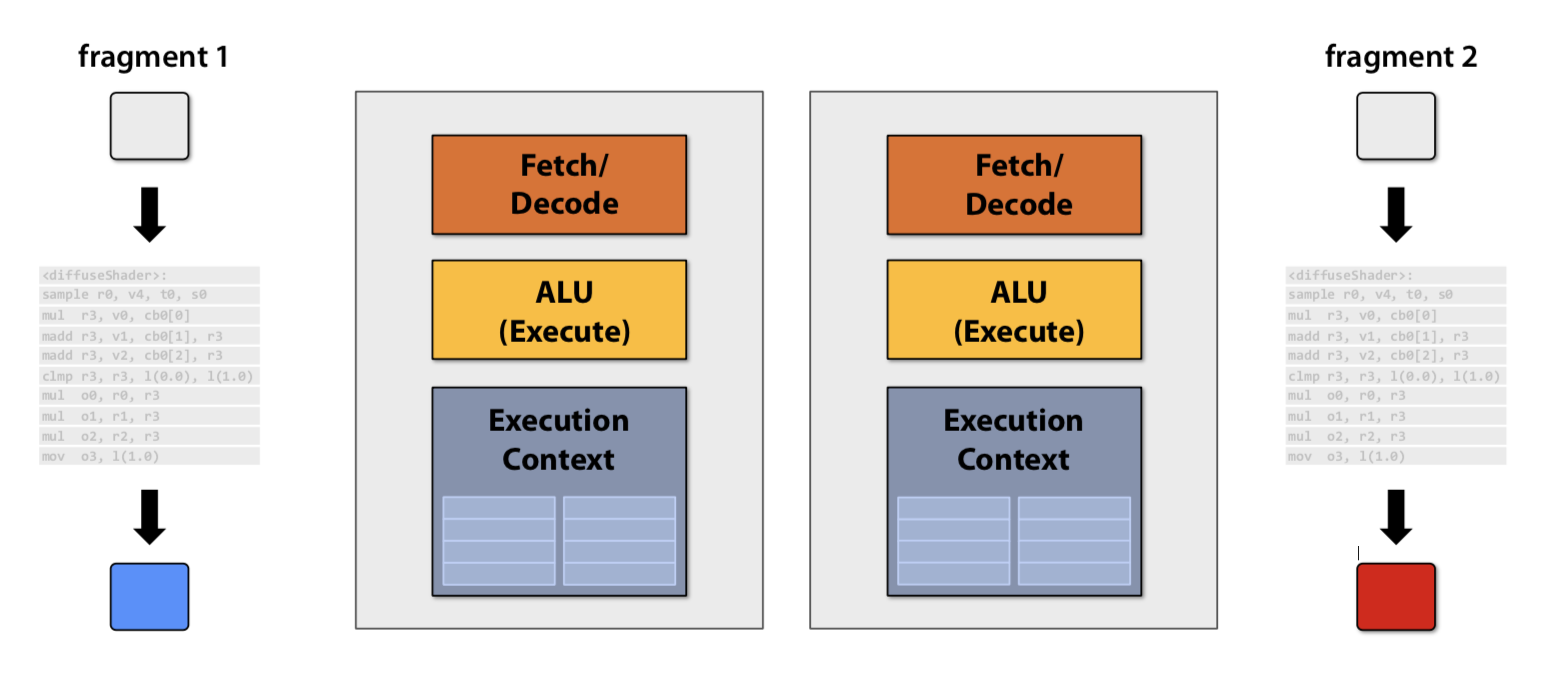
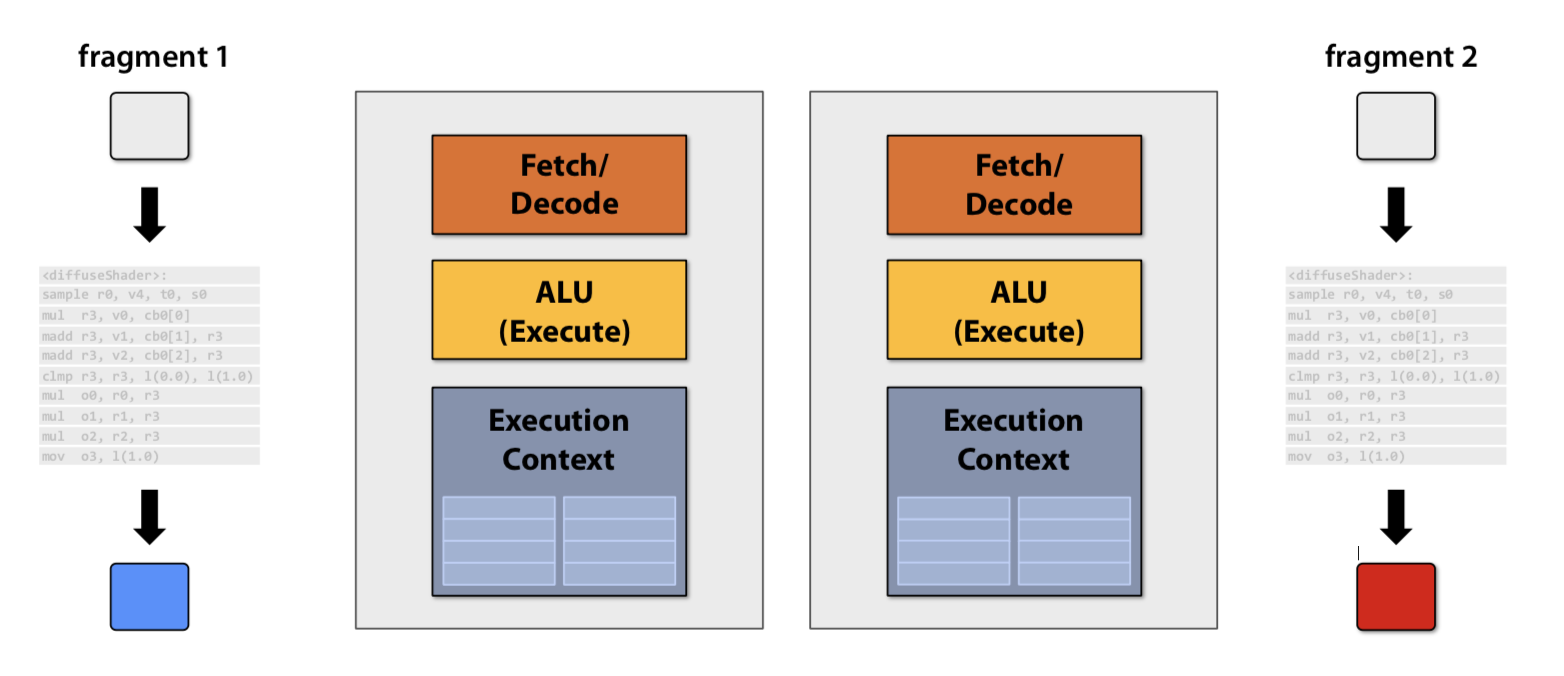
想象一下,你正在玩一个画面精美的3A大作,屏幕上每一个像素都在实时计算光影效果。这些看似简单的画面,背后其实是无数个被称为”shader”的小程序在同时工作。每个shader就像一个小工人,负责计算一个像素的颜色和亮度。
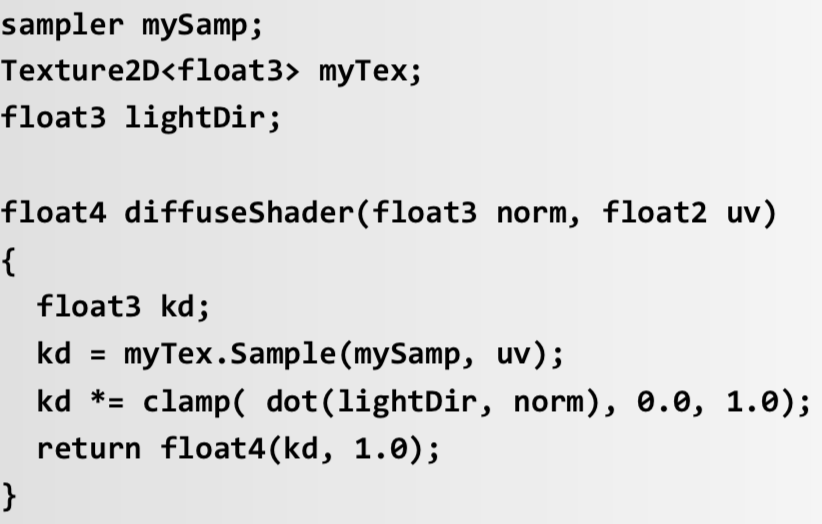
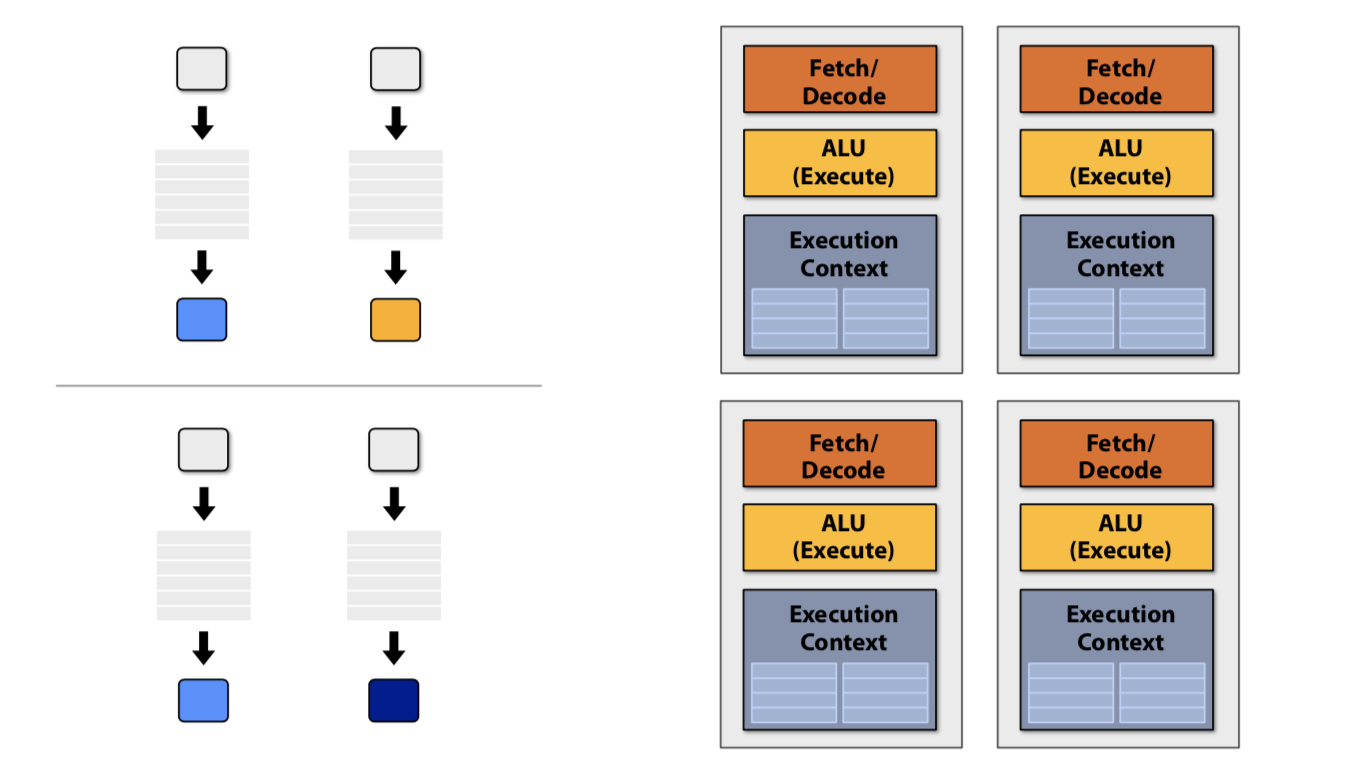
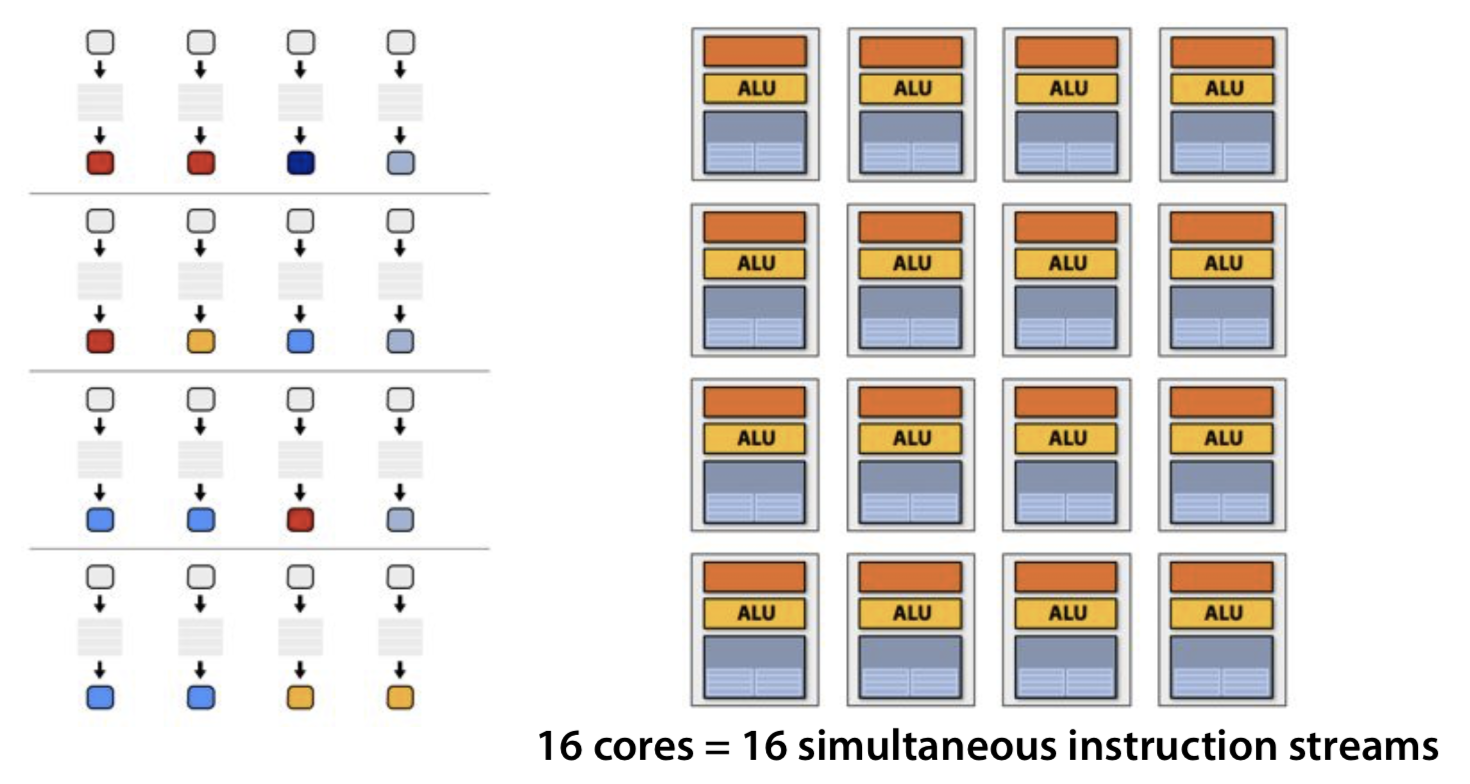
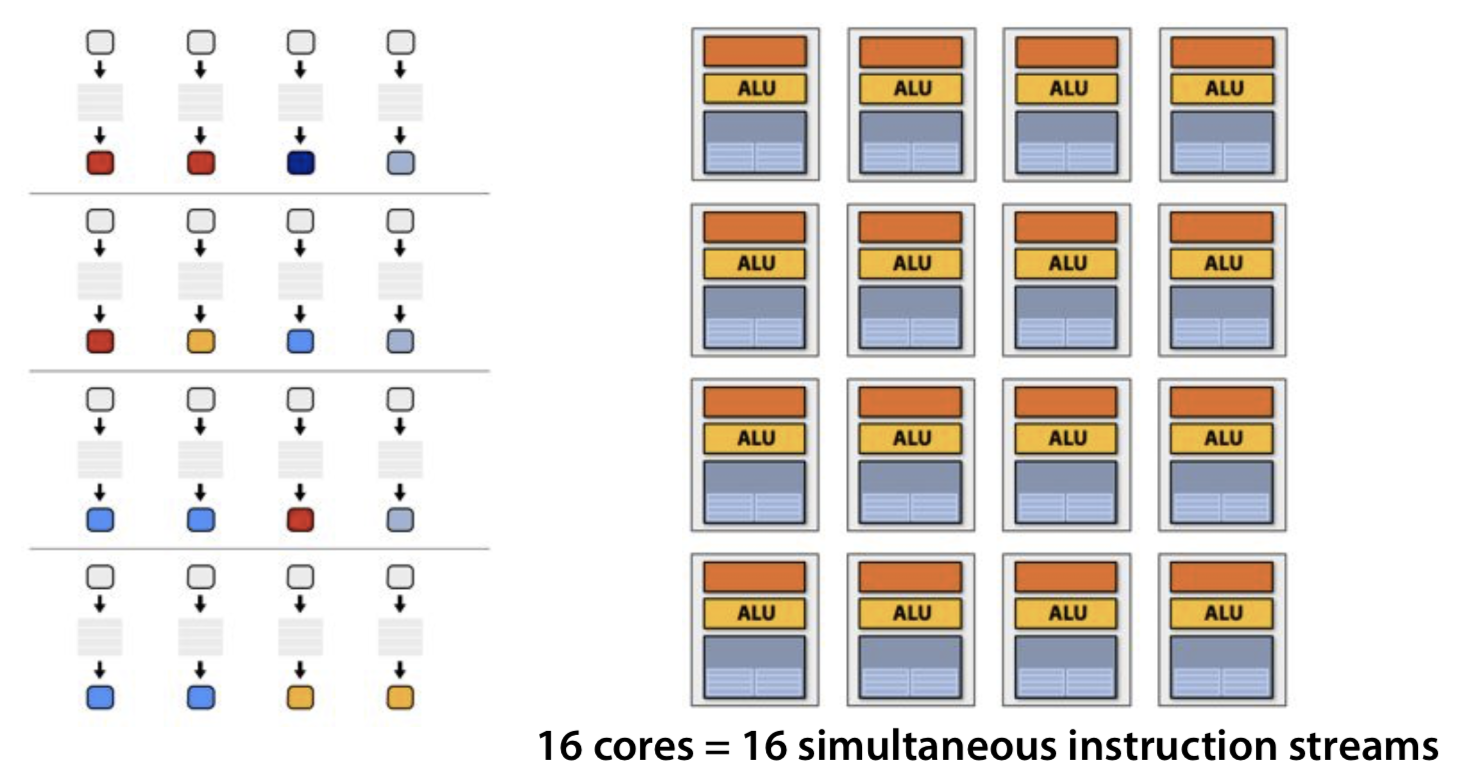
有趣的是,这些shader虽然各自独立工作,但它们执行的代码却是一模一样的。这就好比一个工厂里,所有工人都拿着同一本操作手册在工作。这种设计理念,让GPU工程师们灵光一现:既然大家都在做同样的事,为什么不共用一套指令呢?
GPU vs CPU:完全不同的设计哲学
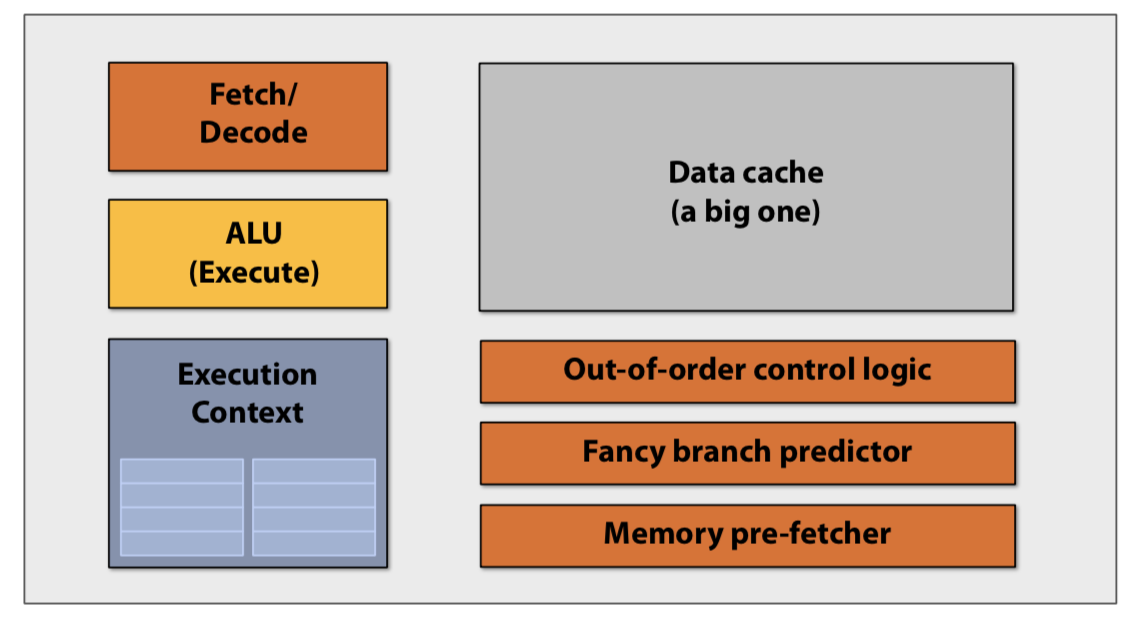
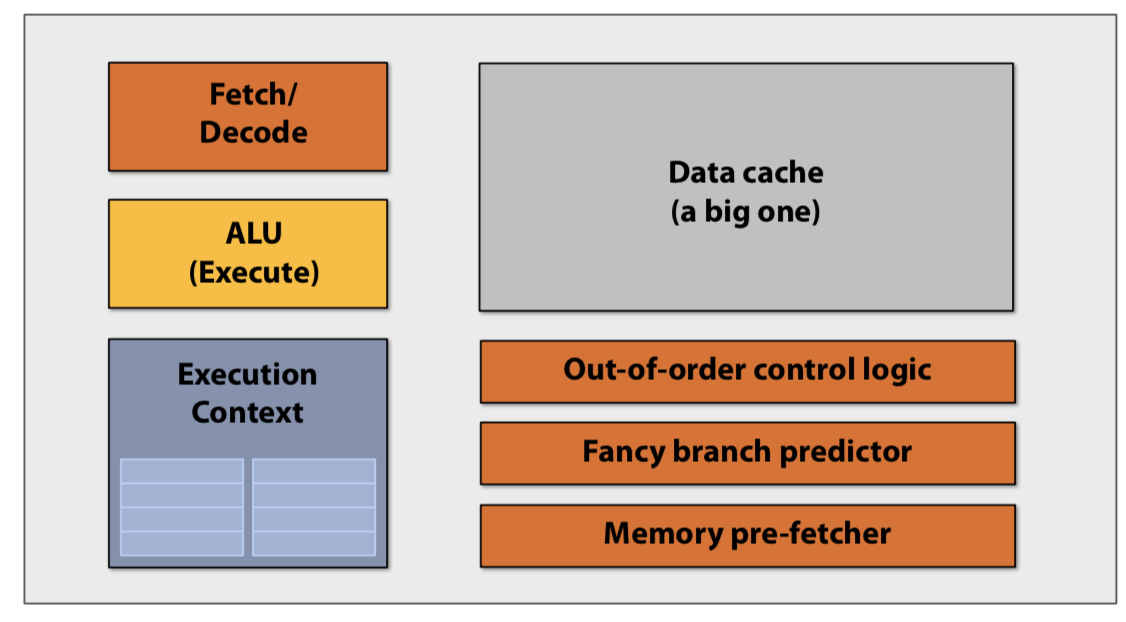
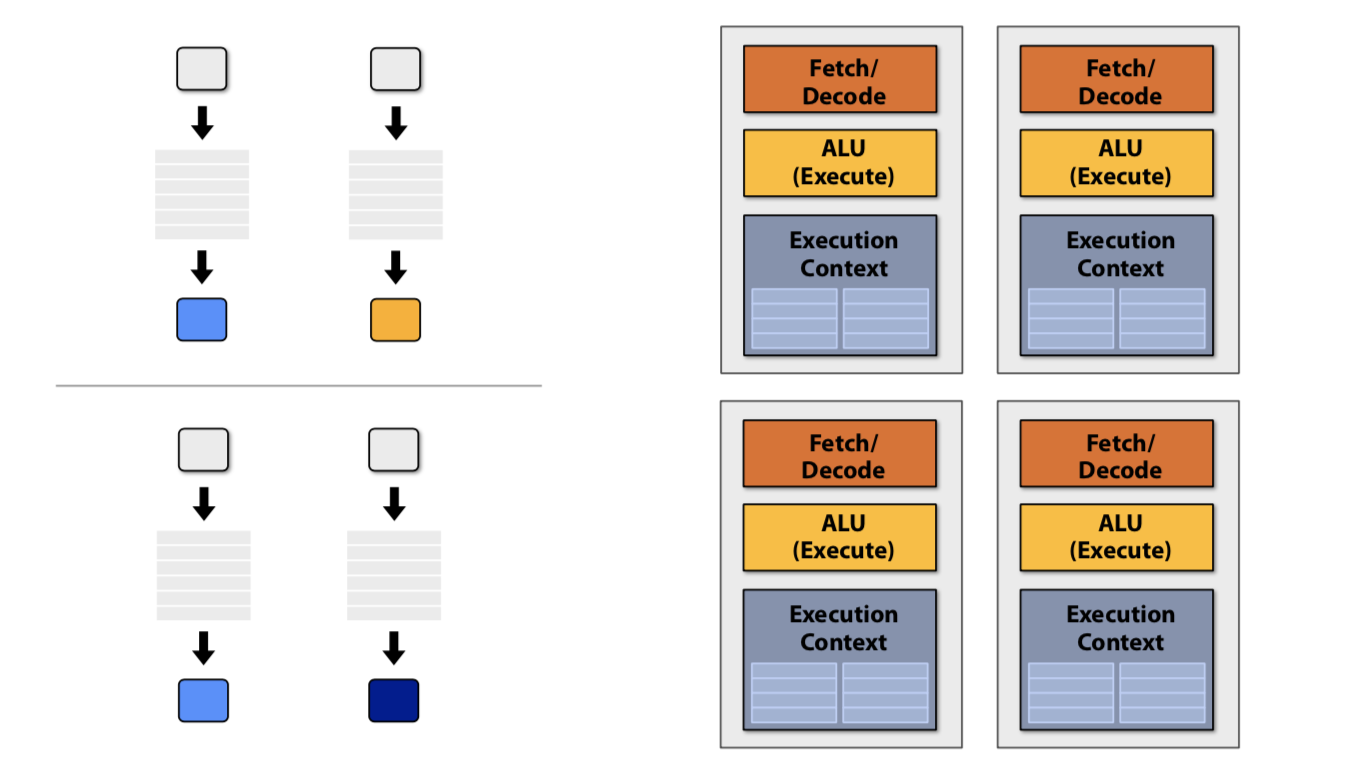
如果你把CPU和GPU放在一起对比,会发现它们就像两个性格迥异的双胞胎。CPU是个”全能型选手”,它要处理各种复杂的任务,所以配备了强大的分支预测、乱序执行和内存预取功能,还有大块的缓存来加速数据访问。
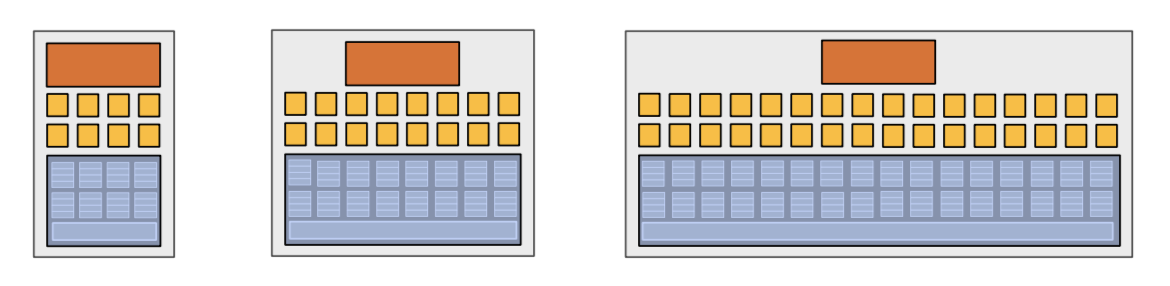
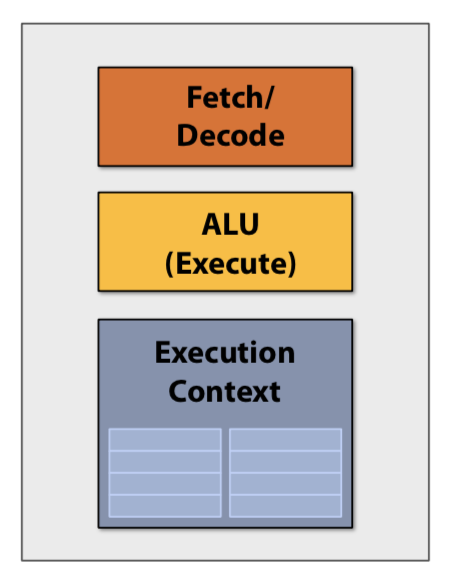
而GPU则是个”专才”,它只需要专注于图形计算这一件事。所以GPU核心把这些”花里胡哨”的功能都砍掉了,换来的是在同样面积下塞进更多的计算核心。
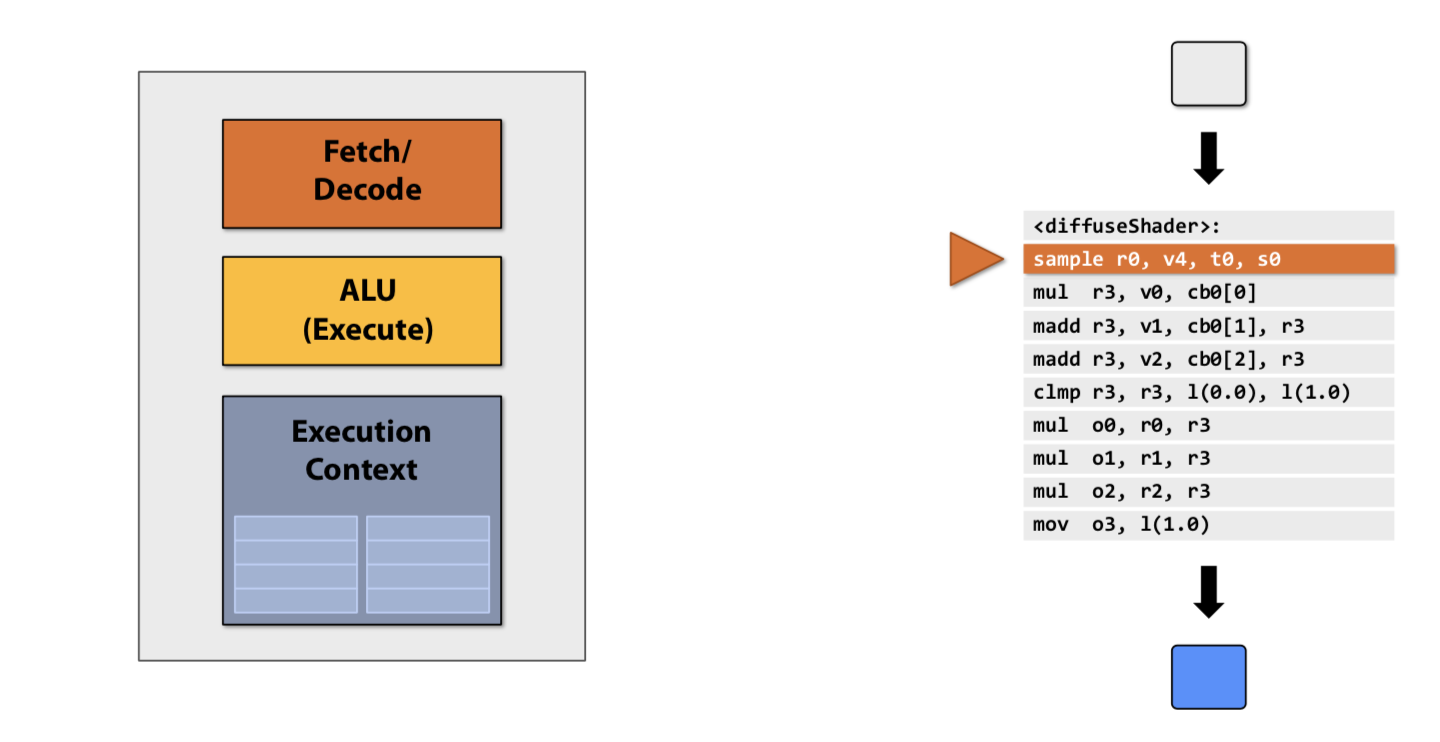
这就好比CPU是那种什么都会一点的”通才”,而GPU则是专注于某一领域的”专家团队”。当面对海量并行计算时,GPU的优势就体现出来了。
SIMD:GPU的独门绝技
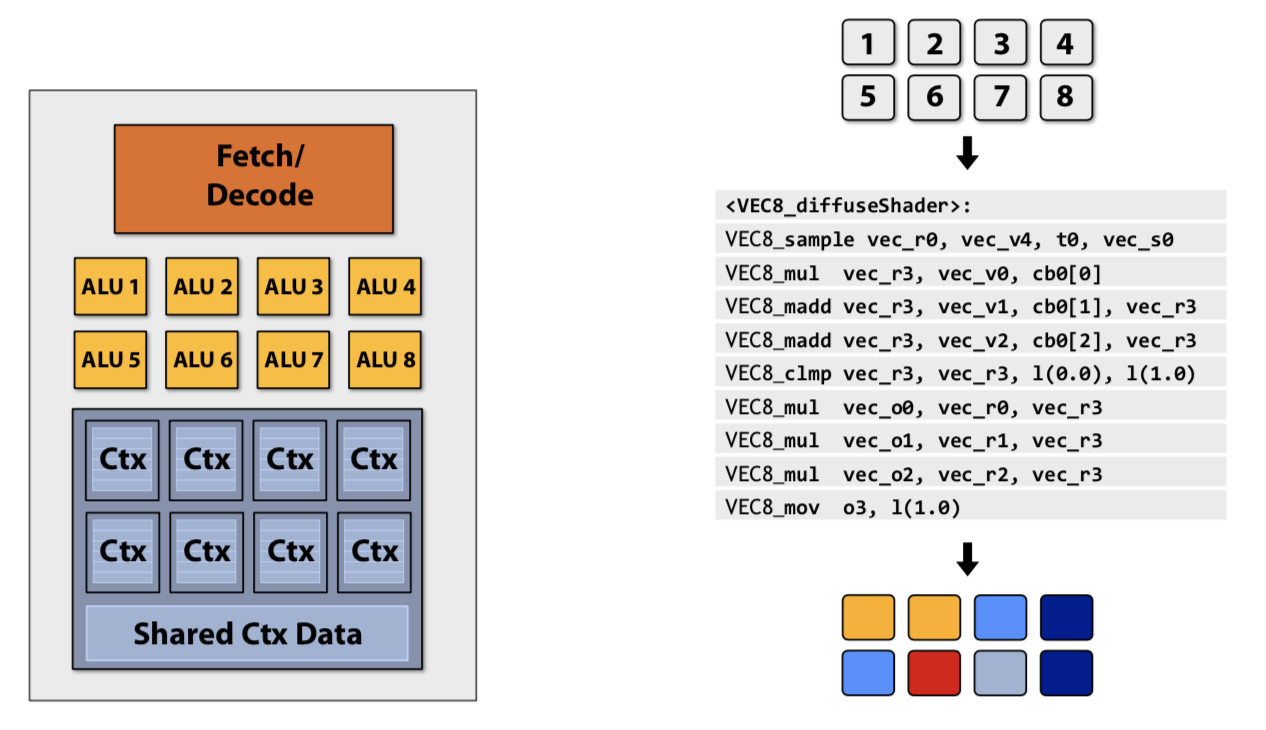
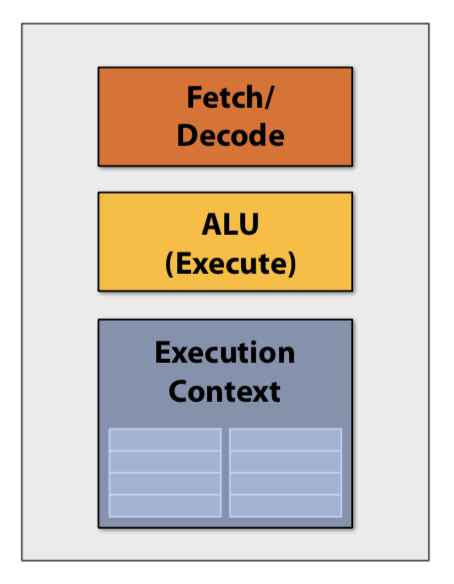
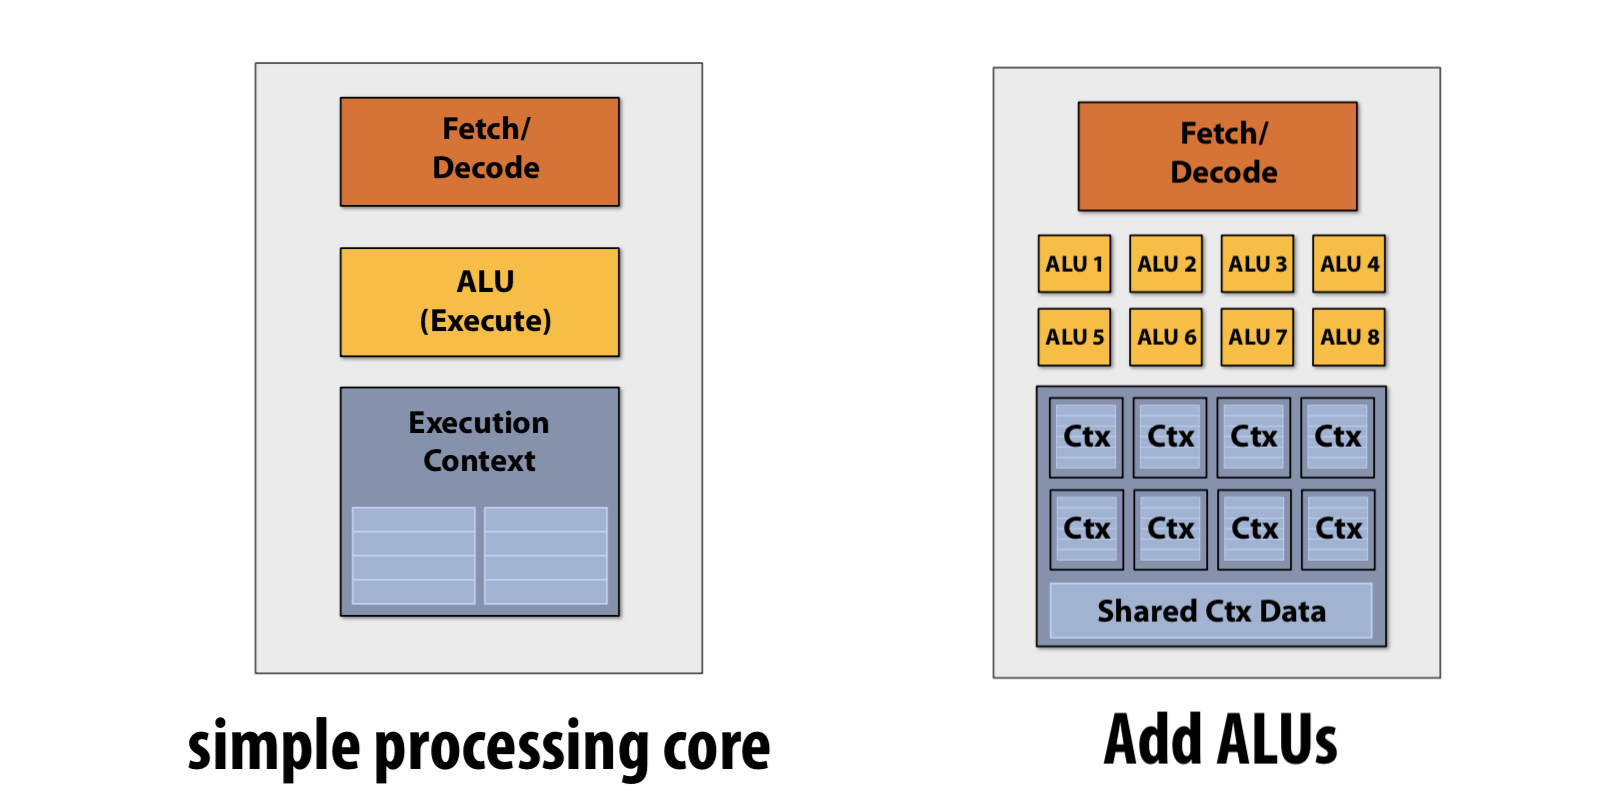
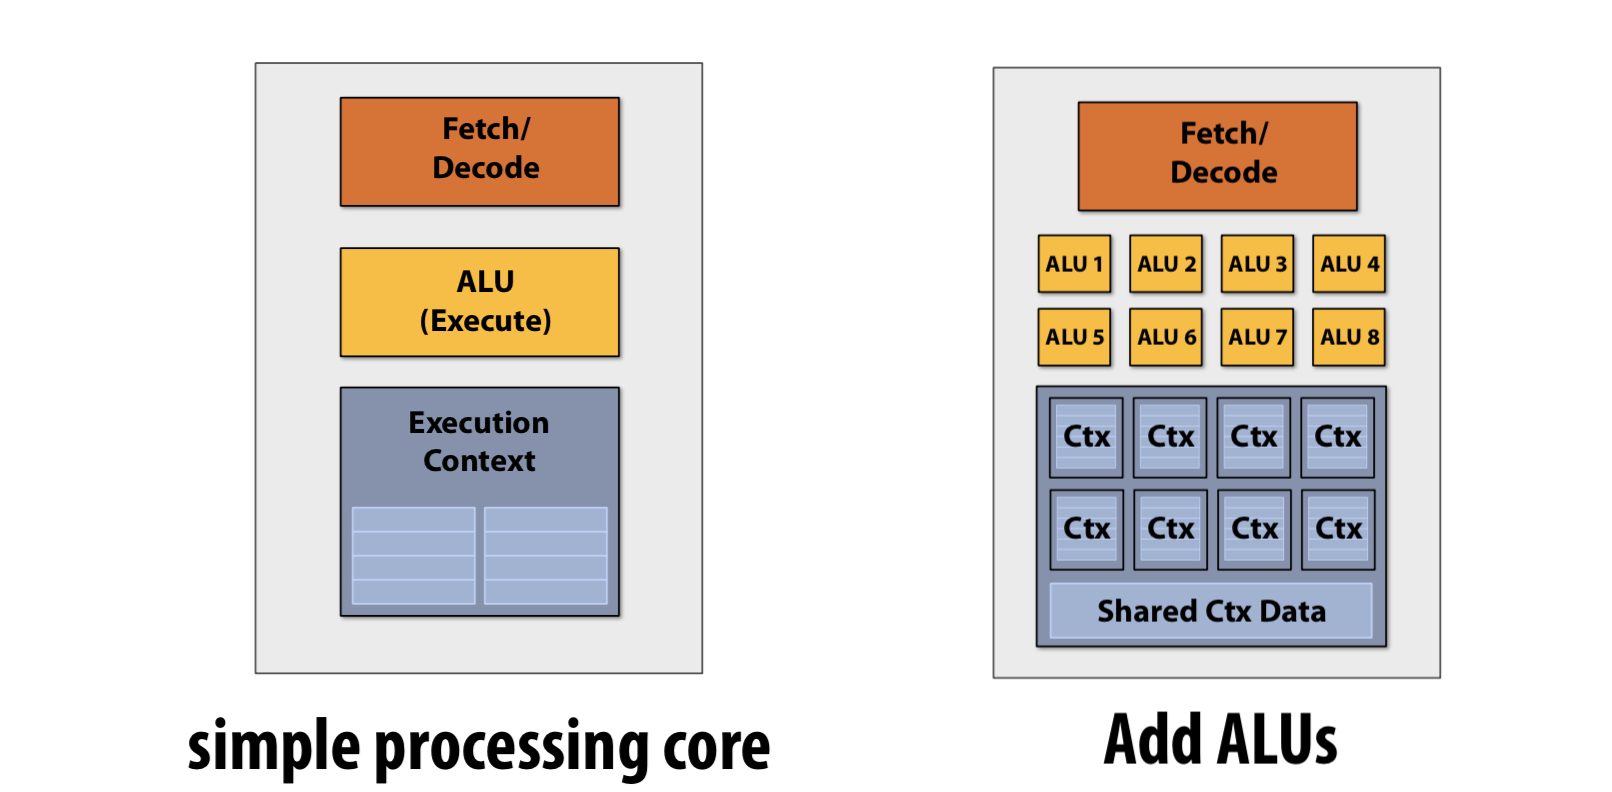
还记得我们前面提到的”共用指令”吗?这就是GPU最核心的技术之一——SIMD(单指令多数据)。简单来说,就是一条指令同时控制多个计算单元。
想象一下,你是一个指挥家,面前有32个钢琴家。你只需要挥动指挥棒,32个人就会同时开始演奏。这就是SIMD的精髓——用一条指令驱动多个ALU(算术逻辑单元)同时工作。
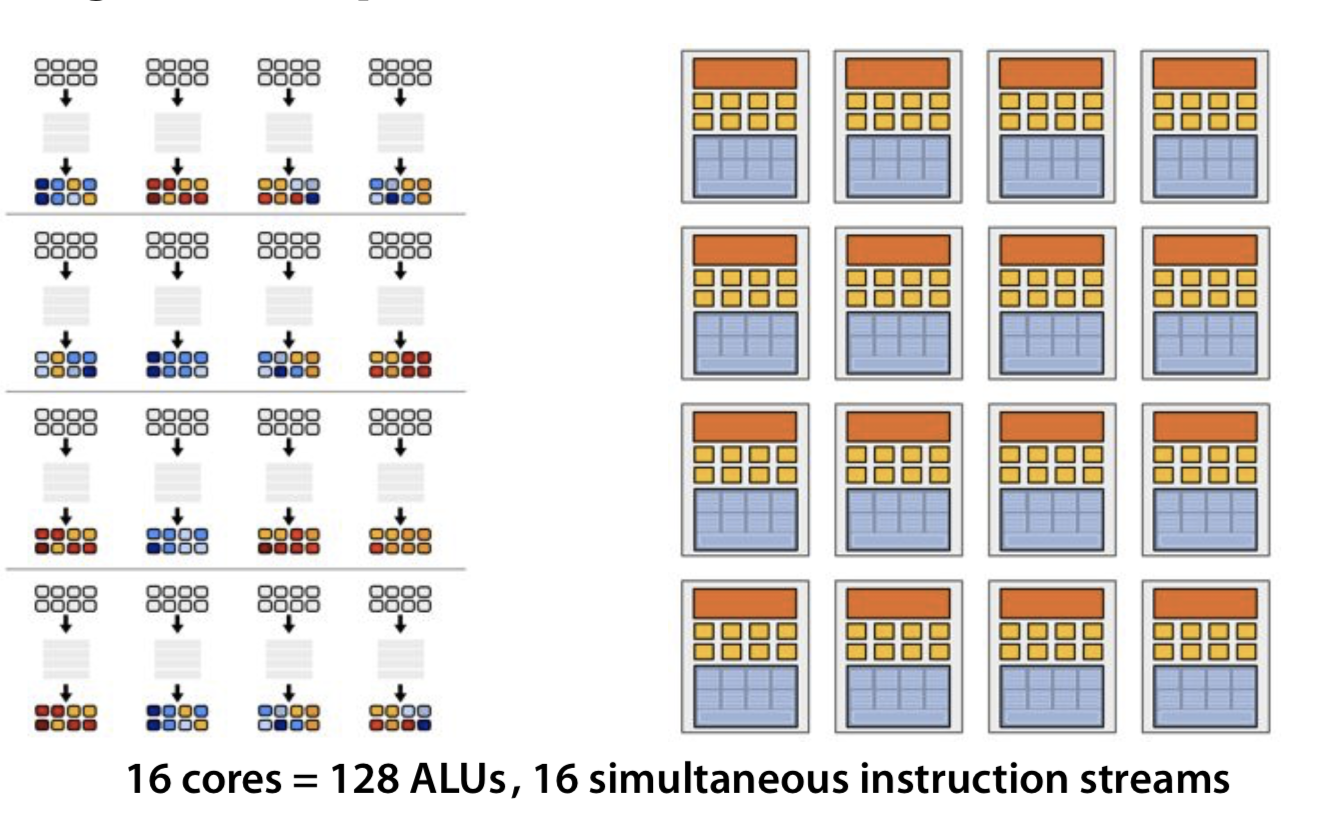
在现代GPU中,一般16到64个ALU共享一个指令流。这意味着,GPU可以在一个时钟周期内完成大量计算,这也是为什么GPU能在游戏画面渲染上如此高效的原因。
分支语句:GPU的”阿喀琉斯之踵”
不过,GPU也有它的弱点。还记得我们说过GPU砍掉了分支预测功能吗?这就导致它在处理条件语句时效率大打折扣。
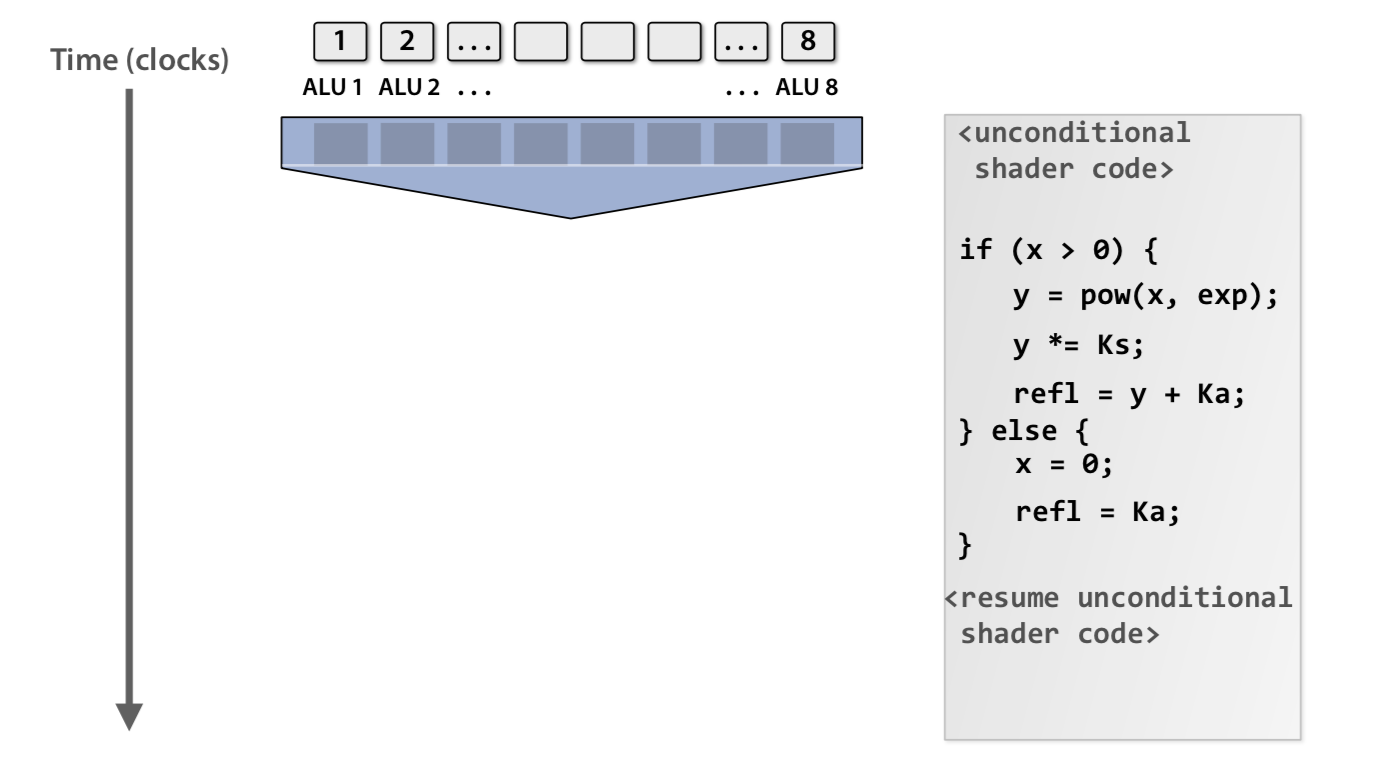
当GPU遇到if-else这样的分支语句时,它会把不同分支分配给不同的ALU执行,然后丢弃无效的结果。这意味着,最坏情况下,分支语句的性能可能只有无分支语句的1/8!所以,游戏开发者们在编写shader时都会尽量避免使用分支语句,这也是为什么我们经常听到”分支语句会严重影响游戏性能”的说法。
Stalls:GPU如何应对延迟
在GPU的世界里,最让人头疼的问题之一就是内存访问延迟。当GPU需要从显存中读取纹理数据时,可能需要等待100到1000个时钟周期。这在CPU看来简直是不可接受的。
但GPU有自己独特的解决方案:它不再依赖大缓存,而是通过多Context切换来隐藏延迟。简单来说,当一个任务在等待数据时,GPU会立刻切换到另一个任务继续计算。这就像你在等外卖的时候,顺便把衣服洗了,等外卖到了再回来吃。
这种设计让GPU能够始终保持高利用率,即使面对高延迟的内存访问,也能让计算单元忙个不停。
实例解析:GTX 480的惊人算力
说了这么多理论,让我们来看看一个具体的例子。NVIDIA的GTX 480显卡,它拥有15组SM(Streaming Multiprocessor),每组SM包含32个CUDA核心。
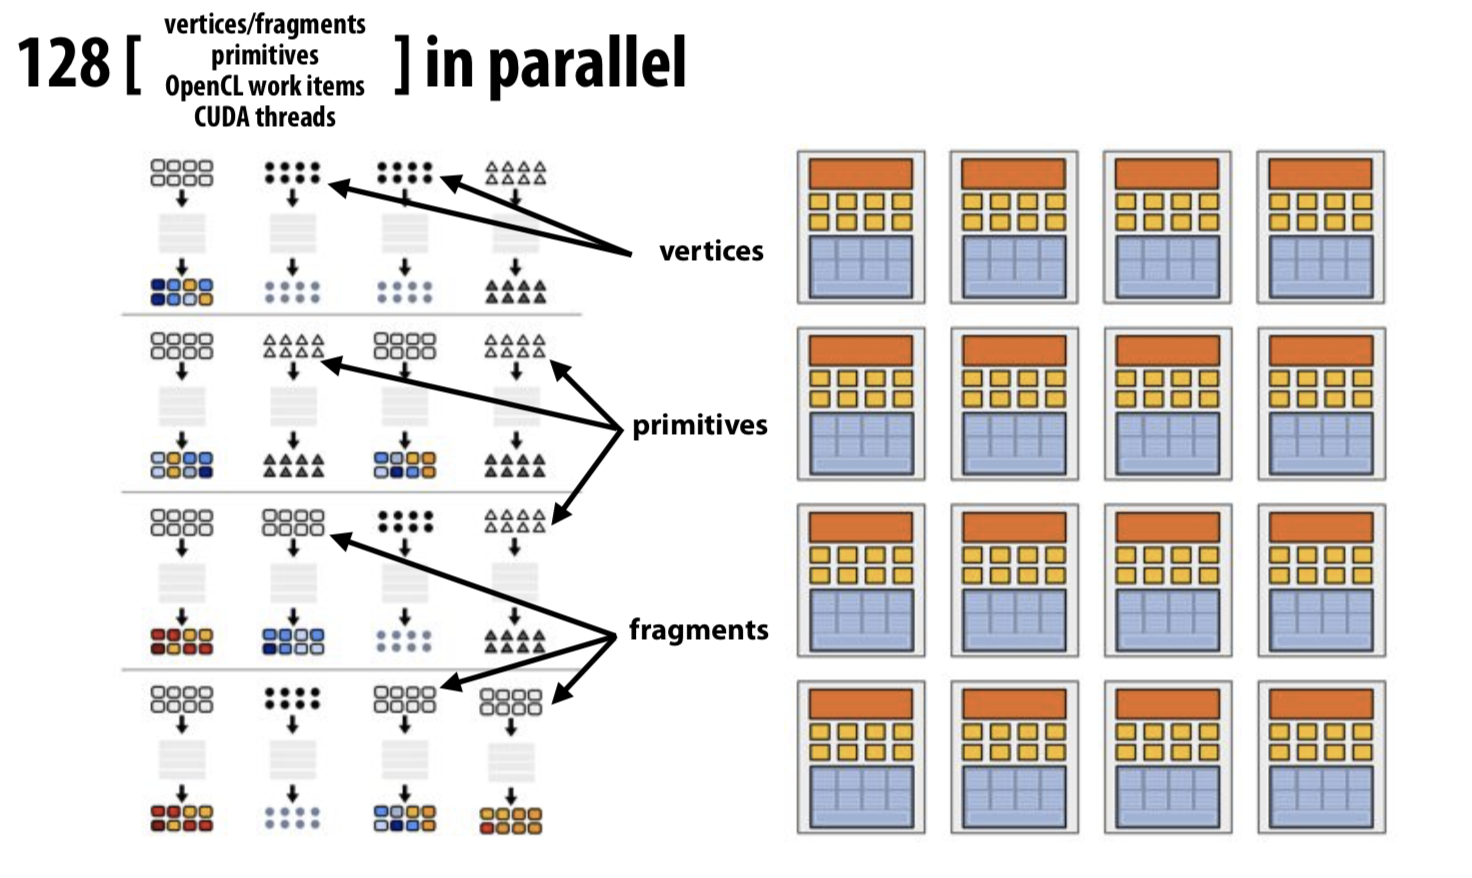
每组SM有48组Context,这意味着它可以同时管理48个线程组。算下来,GTX 480可以同时执行多达23,040个CUDA线程!这个数字是不是很惊人?
这就像你同时雇佣了23040个工人,他们都在各自的岗位上忙碌着,互不干扰。这就是GPU并行计算的魅力所在。
结语
通过这篇文章,我们深入了解了GPU的工作原理。从SIMD到Context切换,从分支处理到延迟隐藏,每一个设计都体现了工程师们的智慧。虽然我们讨论的是DX10/OpenGL 3.x时代的显卡架构,但这些基本概念在现代GPU中依然适用。
下次当你打开游戏,看到流畅的画面时,不妨想想背后这些默默工作的”小工人们”。它们用最朴素的方式,为我们带来了最震撼的视觉体验。而这,就是GPU的魅力所在。
选购建议:如果你是一个游戏爱好者,建议选择拥有更多CUDA核心和更高频率的显卡;如果你主要做视频剪辑或3D渲染,那么显存容量和带宽可能更重要。预算方面,入门级显卡(2000-3000元)已经能流畅运行主流游戏,中高端显卡(4000-6000元)则能带来更好的游戏体验,而旗舰级显卡(8000元以上)则是追求极致性能玩家的选择。
产品图集