别再写提示词了!Claude Opus 5实测:一句话就能让它自己找bug,GPT-5.6输在哪?
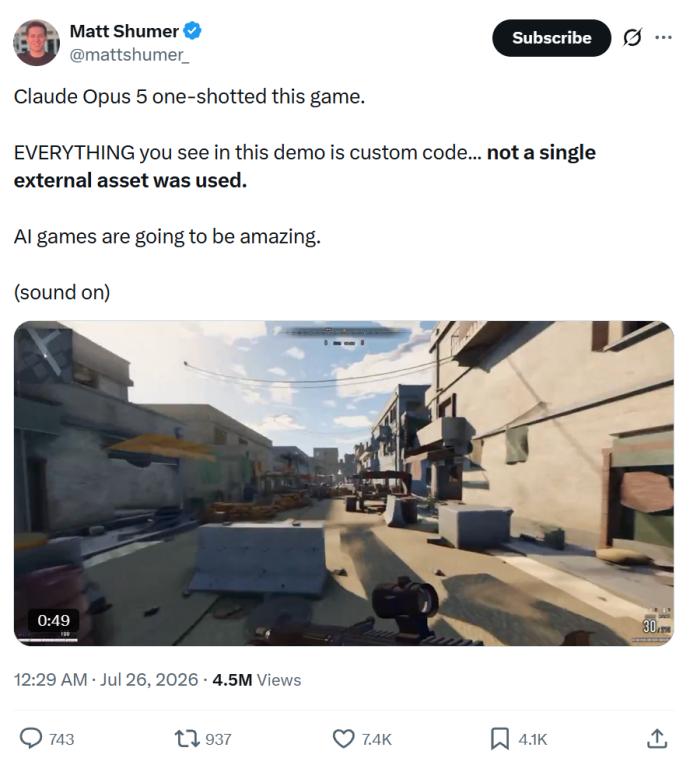
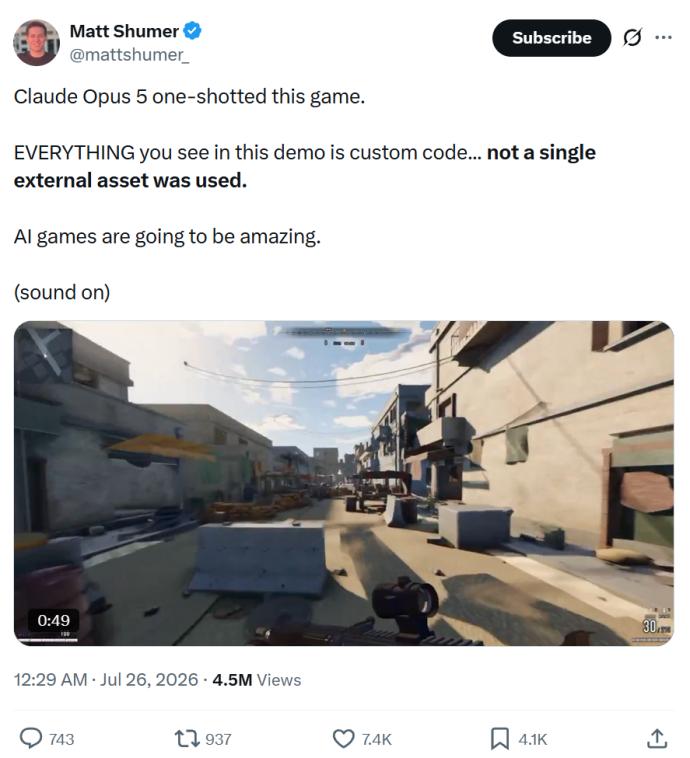
你有没有过这种经历?为了让人工智能帮你干活,得先花半小时写“提示词”,像伺候甲方一样小心翼翼——把需求拆得稀碎、把边界条件列得清清楚楚,生怕它理解错。但最近,AI圈一个播放量超400万的视频,直接颠覆了我的认知:有人只给Claude Opus 5写了三段话,它就用Three.js从零写出了5.5万行代码的3D射击游戏,11个子系统,没有一个外部素材。更夸张的是,Anthropic工程师透露,他们砍掉了Claude Code系统提示词里80%的内容,模型反而更强了。
这意味着什么?提示词工程这门手艺,可能真的要消失了。 但光听官方吹牛没用,我决定亲自上手,用最“恶意”的方式考考它——故意不告诉它代码有bug,看它能不能自己挖出来。作为对照组,我拉上了GPT-5.6 Sol。
一个购物车,六个坑,外加一个隐藏BOSS
我准备了一个叫“buggy-shopping-cart”的项目,功能很简单:加商品、用优惠券、算运费、出总价。但我在里面埋了六个bug,每一个都能让用户账单算错。我的提示词只有一句话:“项目名是buggy-shopping-cart,我应该如何优化呢?”——我故意不说有bug,就想看它能不能自己发现问题。
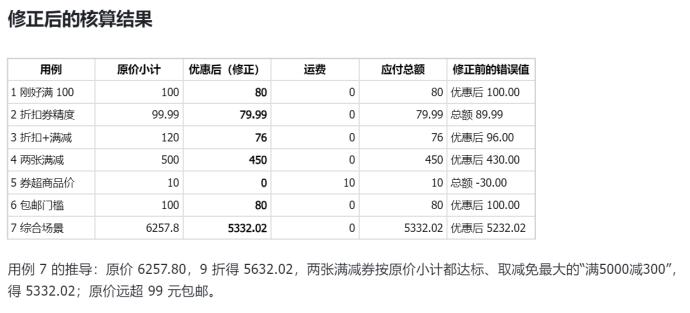
这六个bug有多阴险?比如满100减20的券,代码写的是“大于100才减”,但需求是“达到100就减”——一个大于号和大于等于号的区别,用户买刚好100块的东西,优惠就没了。再比如,优惠完没有下限保护,10块钱的商品用50块的券,算出来总价是负30,用户买东西反而倒赚。最绝的是,有两个bug会互相掩盖:满减券没生效导致价格停在100块,刚好过了99块包邮线;一旦你修好满减bug,价格降到80,但包邮判断还看优惠后价格,用户就要被多收15块运费——测试还显示“通过”,因为bug抵消了。
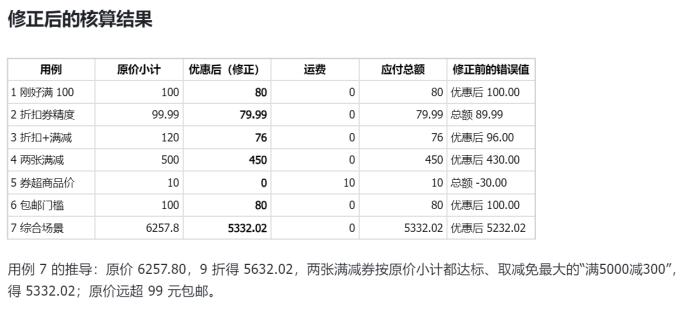
结果,GPT-5.6和Opus 5都把这6个bug全找出来了,一个没漏。 光论“找bug”能力,两边打平。但找完bug之后的表现,差距就出来了。
差距不在“找”,而在“想”
Opus 5多挖出来一个bug——它指出运费计算里有个浮点精度坑:多件商品重量加起来可能出现3.0000000000000004这种值,然后math.ceil会把它往上取整,多收用户5块钱运费。GPT-5.6虽然也提到“金额不应该用float”,但只停留在价格计算上,没发现运费里这个更隐蔽的精度问题。
但最大的区别在于分析方式。GPT-5.6是逐条修bug,第一条、第二条、第三条……每个说清楚位置和修法,很清晰,像一份规范的bug报告。而Opus 5完全不一样——它先自己完整跑了一遍,然后把自己代入成产品经理来给我分析问题。它不只是改bug,还会多想几步:还有没有隐藏的?修的时候会不会出问题?这些bug为什么会出现?以后怎么避免?
比如在“金额口径”这个问题上,GPT-5.6会把满减门槛用错价、包邮用错价当成两个独立的bug。但Opus 5会告诉我说:代码里根本就没区分原价和优惠价这两个口径——这不是两个bug,这是一个系统性的设计缺陷。它会从根上告诉你,问题出在哪,而不是头痛医头脚痛医脚。
禁掉所有工具后,差距更明显了
第二道题更狠:我给它一个任务,但把它能用到的工具全禁了,看它还能不能完成。结果Opus 5在没有任何外部工具的情况下,依然能通过逻辑推理和代码分析给出完整方案。它不需要调用搜索、不需要运行代码,纯靠“想”就能把问题拆解清楚。而GPT-5.6在工具被禁后,明显更依赖结构化输出,分析深度和自主性都打了折扣。
我的真实感受:提示词工程,真的可以扔了
说实话,这次测试让我有点恍惚。以前用AI,你得把需求拆成“步骤一、步骤二、步骤三”,像教小孩一样。但Opus 5给我的感觉是——你只需要告诉它“做什么”,它自己会想“怎么做”。它甚至会主动发现你没说的问题,然后以产品经理的视角给你建议:“这个逻辑有隐患,建议重构。”
如果你是个开发者,或者经常需要处理复杂逻辑的职场人,Claude Opus 5绝对值得一试。它适合那些“懒得写详细提示词”的人,也适合那些“自己都没想清楚问题”的人——因为它会帮你把问题想清楚。预算方面,Opus 5的API定价比GPT-5.6略高,但考虑到它省下的提示词调试时间,我觉得性价比反而更高。
当然,如果你需要的是规范化的bug报告、结构化的输出,GPT-5.6依然很优秀。但如果你想要一个能替你思考的AI搭档,而不是一个“你说什么它做什么”的工具——那Opus 5,可能是目前最接近“真·智能”的那个。