2.8万亿参数的K3模型来了!Kimi这次真的把海外巨头“卷”哭了?
朋友们,不知道你们有没有这种感觉:最近AI圈好像有点“安静”了。各家大模型除了在价格上卷生卷死,好像很久没有那种让人眼前一亮的“硬核突破”了。直到我看到了Kimi新发布的K3模型——2.8万亿参数,全球最大!这数字一出来,我整个人都清醒了。这哪是“挤牙膏”,这分明是直接扔了一颗“技术核弹”出来啊!💥
说实话,一开始我以为又是营销号在“沸腾”。但当我看到马斯克都在评论区用“Impressive”来评价,甚至第二天就暗示自家下一代模型要“对标”Kimi时,我才意识到,这次K3可能真的有点东西。今天咱不聊那些晦涩难懂的论文,就用大白话聊聊,这个K3凭啥能“封神”,它到底牛在哪?
不只是“大”,更是“聪明”得离谱 🧠
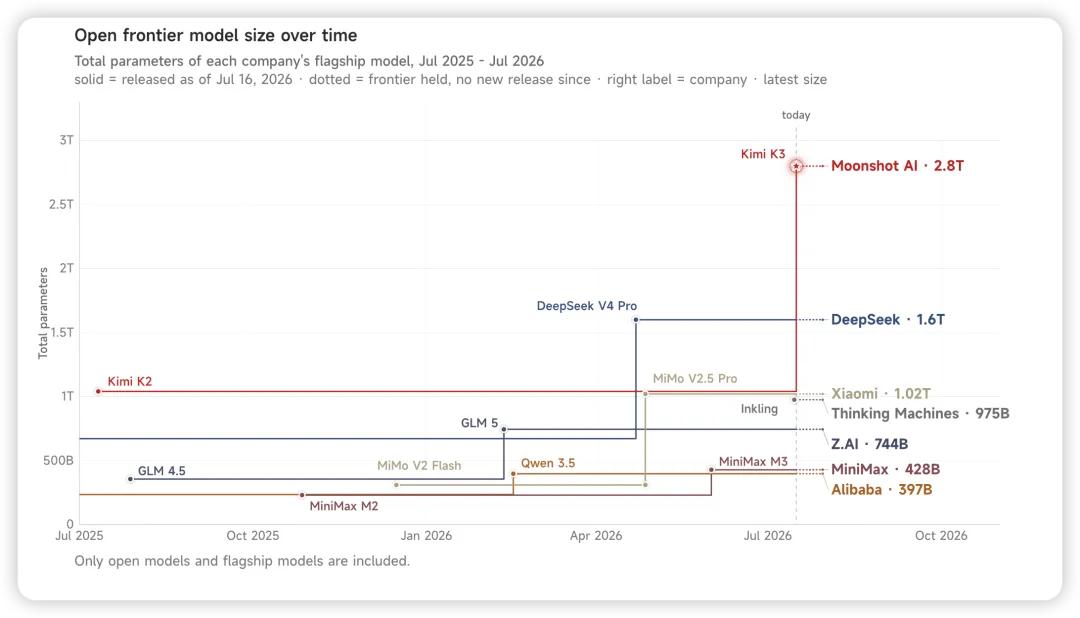
很多人一听“2.8万亿参数”可能没概念。你可以把它想象成一个超级大脑,脑容量是别人的好几倍。但参数大不代表聪明,关键看“激活率”。K3用了MoE架构,稀疏激活率做到了1.79%(16/896),这就好比一个图书馆虽然藏书千万,但你查资料时只精准调用最相关的16本书,又快又准,还省电!
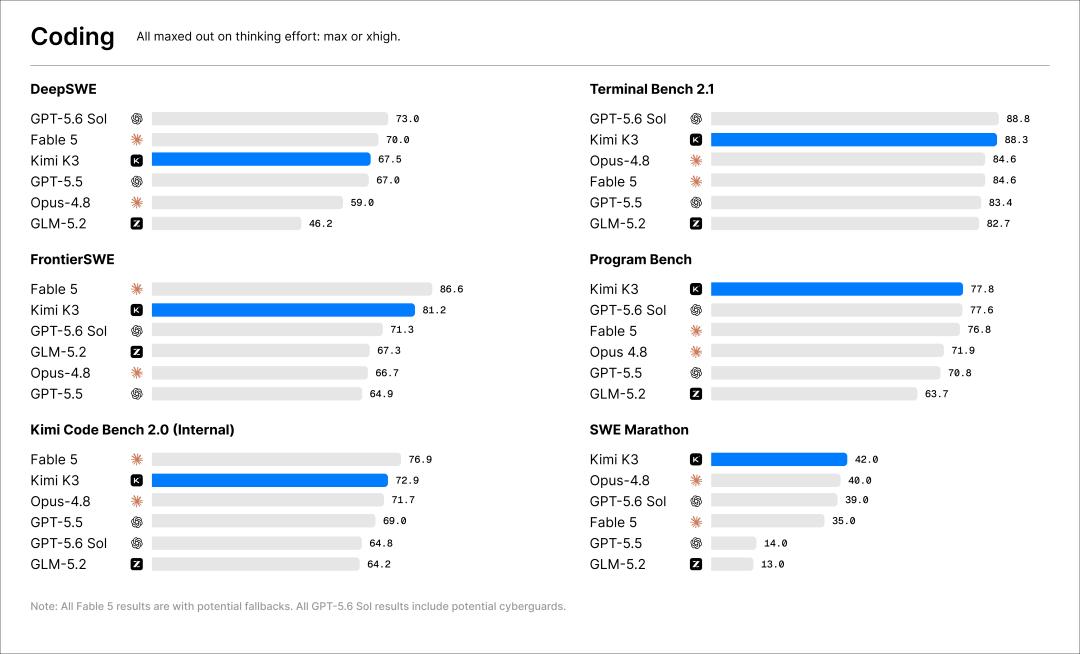
这带来的直接好处就是:推理能力极强。在OmniDocBench测试里拿了91.1分,比Claude Fable 5还高。这意味着什么?意味着你让它帮你分析一份复杂的财报、梳理一个长篇的学术文献,它能像一位顶尖分析师一样,抓住核心逻辑,而不是给你东拼西凑一堆废话。
程序员狂喜:写代码,K3是认真的 👨💻
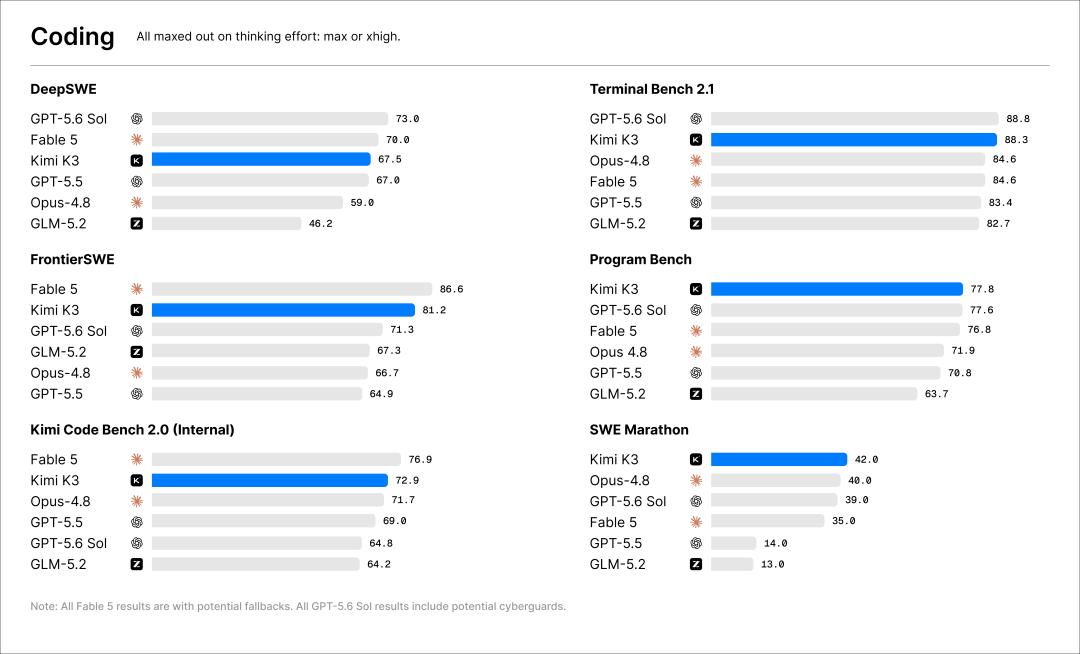
作为一个经常需要和代码打交道的数码博主,我最关心的就是它的编程能力。K3在Arena前端开发榜上直接登顶,拿了1677分,把一众海外闭源模型都压在身下。

我试着让它写一个复杂的交互式网页组件,它不仅能准确理解需求,生成的代码结构清晰、注释到位,甚至还能考虑到边缘情况。那种感觉就像身边突然多了一个经验丰富的高级工程师,帮你把关每一个细节。而且它支持100万Token上下文,意味着你可以把整个项目的核心代码都丢给它,让它帮你做全局优化,这种“长周期编程”能力,简直是生产力神器!
性价比之王?价格只有海外巨头的一半 💰

说到大家最关心的价格,K3单任务成本约0.94美元,比GPT-5.6 Sol的1.04美元便宜一点,但只有Claude Opus 4.8(1.80美元)的一半左右。这就很“香”了。更关键的是,因为它的算力效率极高,相比上一代K2整体训练效率提升了约2.5倍,这意味着同样的钱,它能干更多的活,而且干得更好。

我的真实体验:从“能用”到“好用”的跨越 ✨
我用K3跑了一个我平时觉得特别头疼的任务:让它基于一堆零散的市场数据,生成一份带图表分析的报告。以前用其他模型,经常需要我反复“调教”,输出的内容也经常有“AI味”。但K3给我的感觉是,它真的“读懂”了我的需求,不仅数据整理得井井有条,还能给出一些我没想到的洞察角度。这种体验上的跃升,是参数堆砌不出来的,背后是扎实的技术积累。
谁适合入手K3?我的建议是…… 🤔
如果你是:
- 程序员/开发者:尤其是做前端、全栈开发的,K3的代码生成和长上下文理解能力能帮你节省大量时间,绝对是“摸鱼神器”。
- 科研人员/分析师:需要处理大量文献、数据,进行复杂推理的场景,K3能成为你的“第二大脑”。
- 重度AI工具使用者:如果你日常离不开AI辅助写作、总结,K3的高质量输出能让你告别“人工智障”的尴尬。
预算方面:K3的API定价和GPT-5.6 Sol差不多,但考虑到它更强的推理能力,性价比其实更高。如果你是个人开发者,可以先从免费额度或小额充值开始体验;如果是企业用户,它的B端价格虽然有所上涨,但考虑到效率提升,这笔投入是值得的。
尾巴:中国AI的“硬核”突围 🚀
从DeepSeek到Kimi,我们看到了中国AI公司另一种生存方式——不靠低价补贴,而是靠硬核技术实力去争夺话语权。K3的发布,不仅是参数上的胜利,更是对“基础模型能力见顶”论调的有力回击。它证明了,只要沉下心来搞研究,我们同样能做出世界级的模型。
如果你也想体验一下这个“全球最大”的模型到底有多聪明,不妨去Kimi官网试试看。相信我,它会给你带来惊喜。咱们下期评测见!👋
产品图集