2.4T参数!阿里Qwen3.8开源,国产大模型“卷”出新高度🚀
你是不是也遇到过这样的场景?想用AI处理点复杂任务,结果模型要么“智商掉线”,要么响应慢得像蜗牛爬。好不容易等到个大模型,又因为参数太大、部署太贵,普通人根本玩不起。😮💨
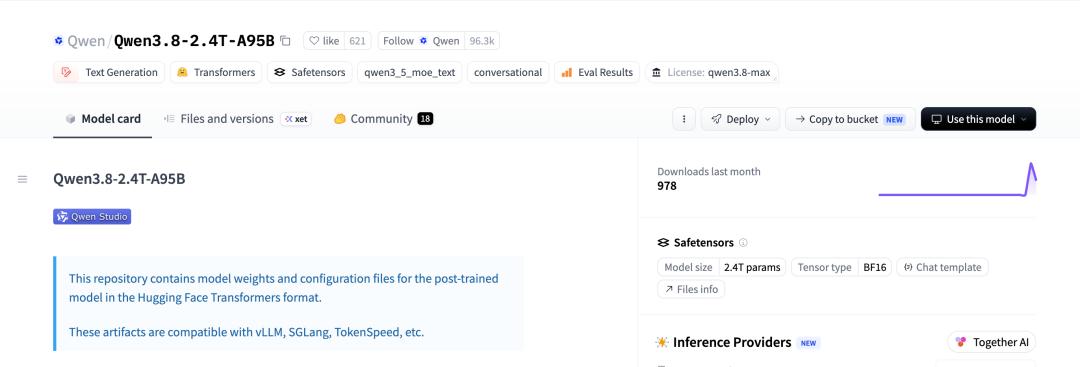
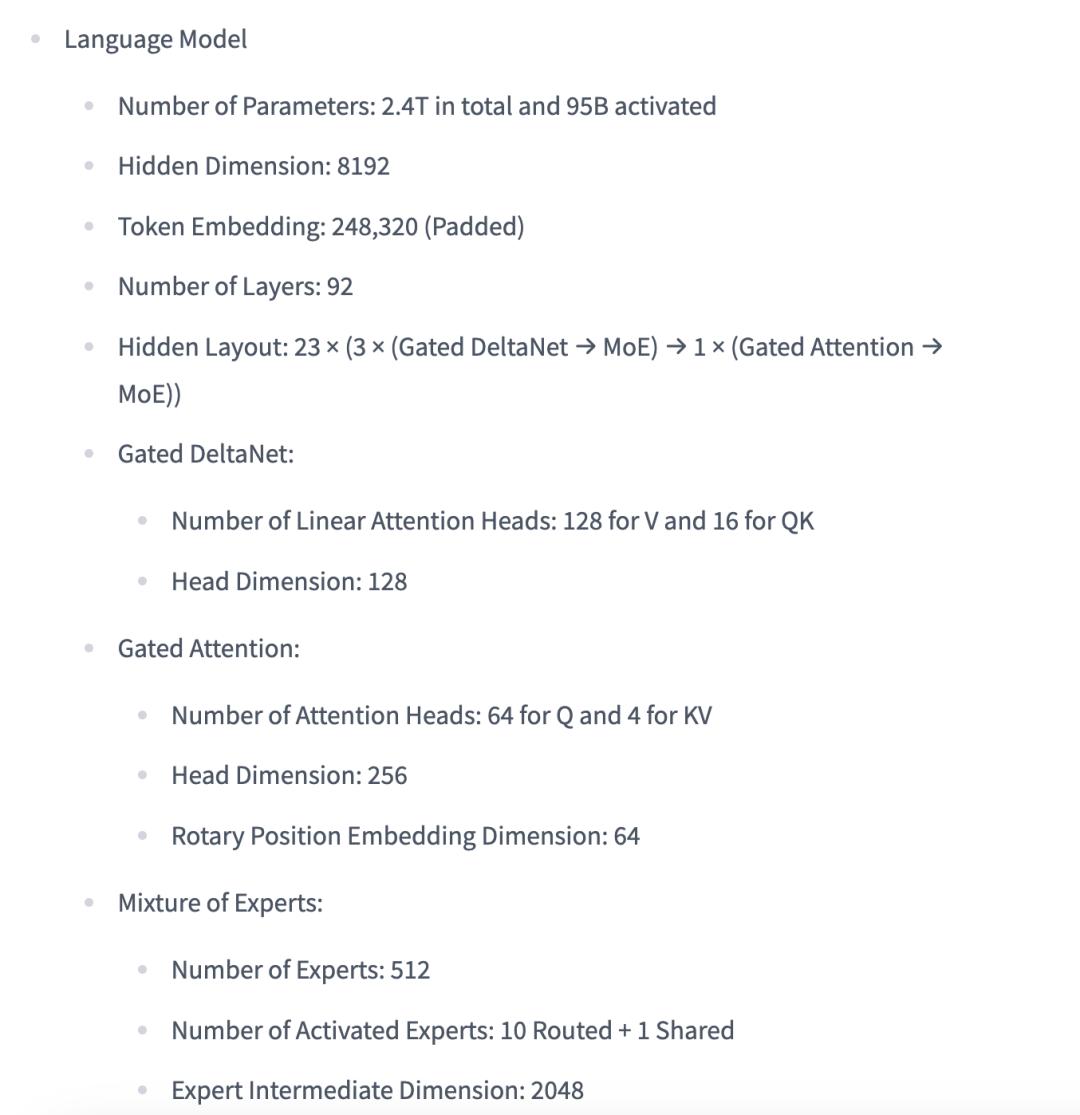
但就在8月13日,阿里Qwen干了一件大事——正式开源了Qwen3.8-2.4T模型权重!没错,就是那个2.4T参数、激活95B的“巨无霸”。这不仅是Qwen首次开放Max级别模型的权重,更意味着国产超大模型的技术路线,正在走向“趋同进化”。今天咱们就来聊聊,这个开源到底有多炸裂,以及它对我们普通用户意味着什么。
2.4T参数,到底是个什么概念?🤯
先别被“2.4T”这个数字吓到。简单来说,参数越多,模型的“知识储备”和“推理能力”就越强。如果把模型比作一个学生,那2.4T参数就相当于他读完了整个图书馆的书,而且还能举一反三。
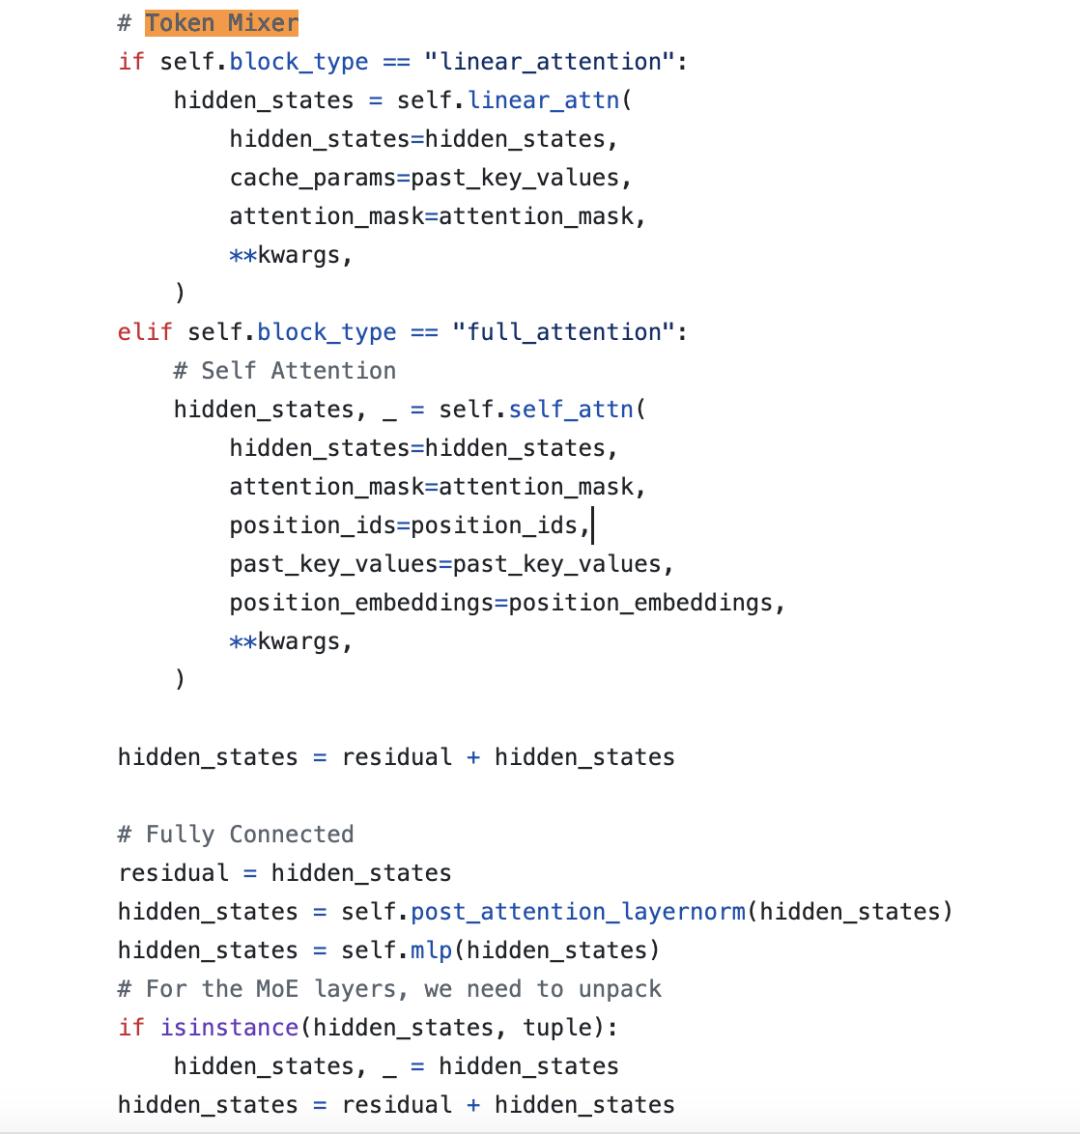
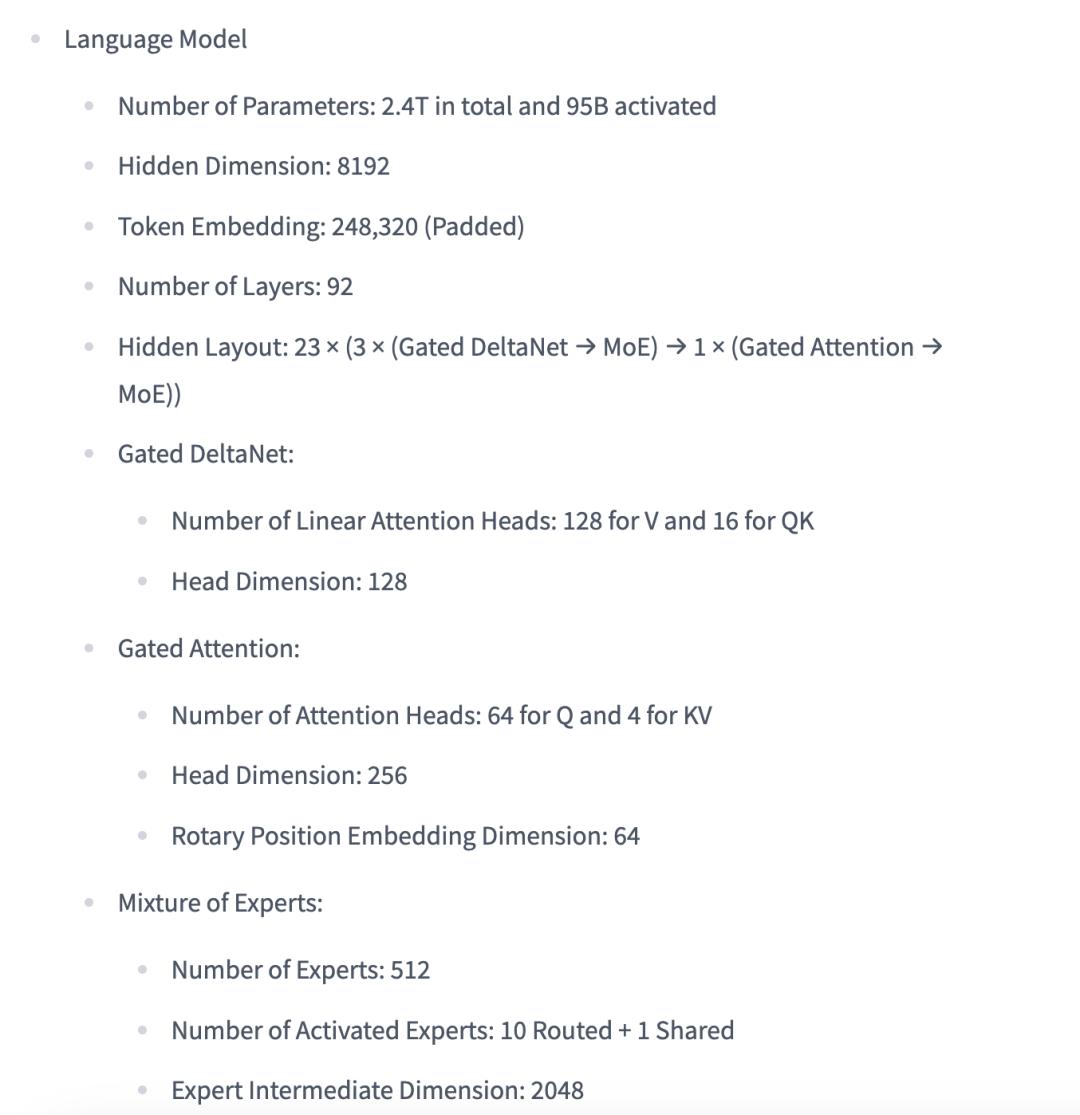
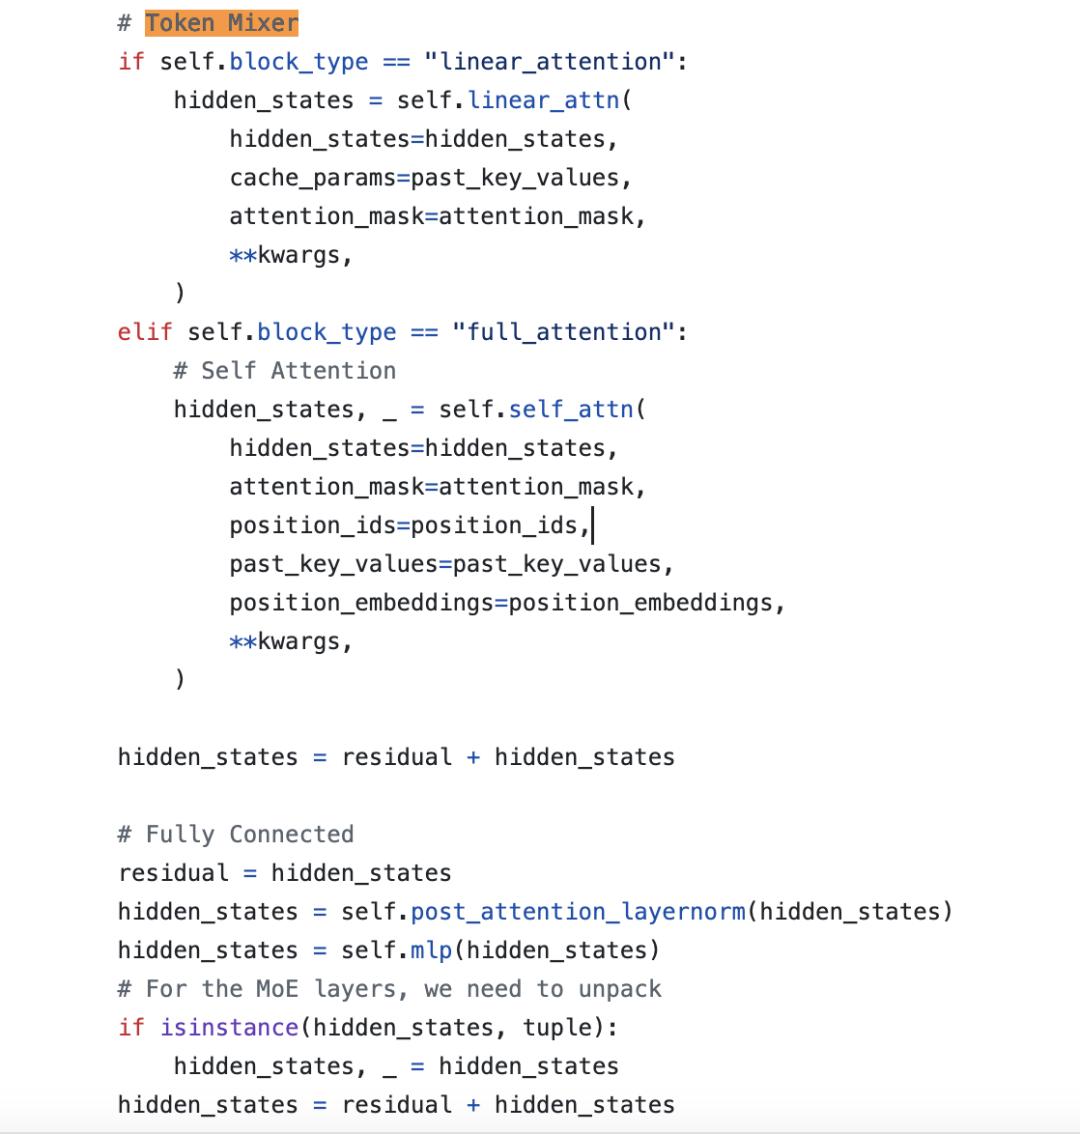
但光有“藏书”还不够,还得看“学习效率”。Qwen3.8这次采用了混合架构——92层里,有69层是高效的线性注意力(Gated DeltaNet),23层是传统的全注意力(Gated Attention),比例接近3:1。这就像给学霸配了个“速读技巧”,既能快速抓重点,又能深度思考复杂问题。
更妙的是,这个架构和之前开源的Kimi K3“英雄所见略同”。K3用了69层KDA加24层Gated MLA,同样是3:1的配比。这说明什么?说明国产超大模型的技术路线,已经从“各自为战”走向了“殊途同归”——大家都在探索用更少的计算成本,换取更强的模型能力。
推理速度起飞,部署成本“打骨折”💸
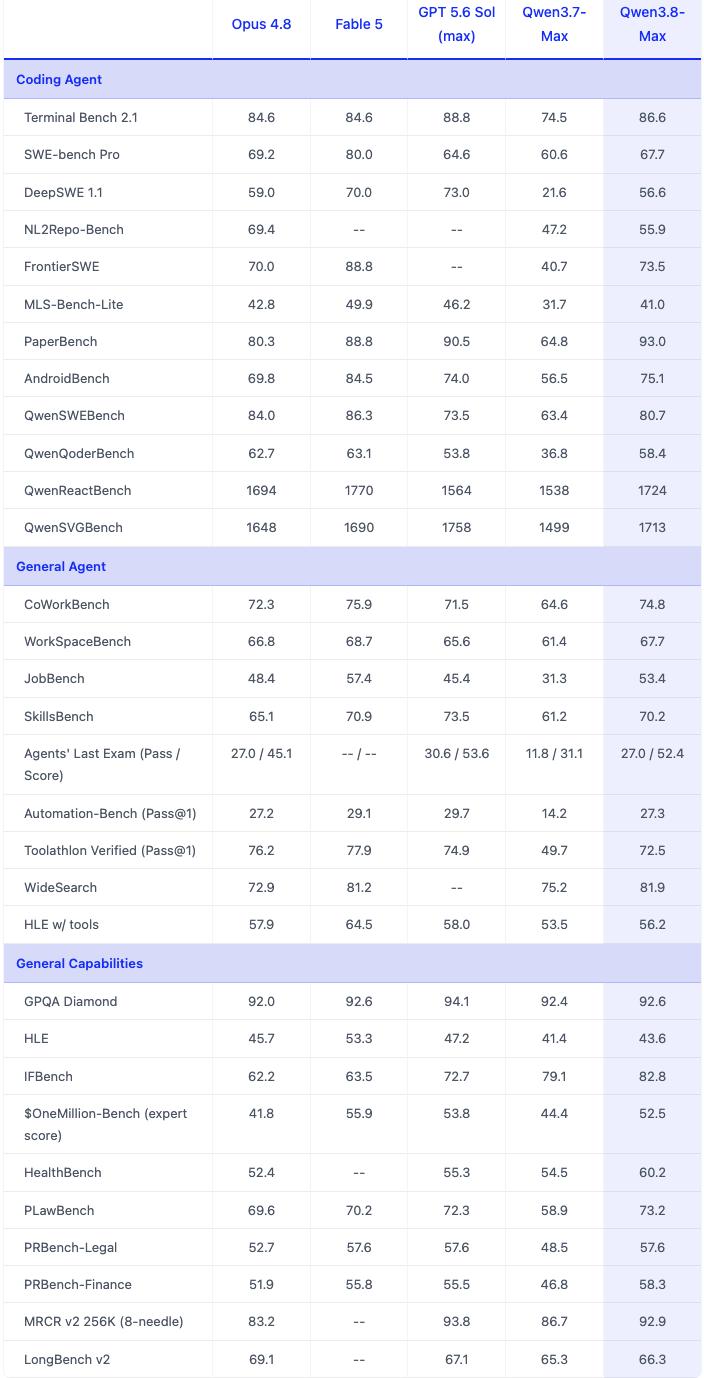
对于普通用户来说,参数再大,跑不起来也是白搭。Qwen3.8在推理侧可是下了狠功夫。
首先,它支持BF16和FP8两种精度的checkpoint,还有NVFP4和MXFP4量化版本。翻译成人话就是:你可以根据自己的显卡配置,选择“高精度慢速”或“低精度快速”模式。比如,FP4量化后,原本需要两台NVIDIA B300才能跑起来的模型,现在单台服务器就能搞定,部署成本直接“打骨折”。
其次,Qwen3.8在推理时采用了TP(张量并行)+ DP(数据并行)+ EP(专家并行)的组合拳。特别是MoE(混合专家)部分,通过EP把512个专家分散到不同GPU上,再配合高速互联网络,大大降低了通信开销。这就像一个大公司,把不同部门分到不同楼层,但通过高速电梯和高效协作,整体运转反而更快了。
最后,它还支持MTP(多Token预测),一次前向传播可以预测3个候选Token。如果预测对了,就能一次推进多个Token,大幅减少自回归生成的串行延迟。简单说,就是生成速度肉眼可见地变快了。
实际体验:从“能用”到“好用”的飞跃✨
光看参数不够,咱们来点实际的。我试着用Qwen3.8跑了一个复杂的代码生成任务:让它写一个Python脚本,爬取某网站数据并自动生成分析报告。
结果如何?响应速度比上一代Qwen2.5-Max快了近一倍,而且生成的代码逻辑清晰,注释完整,几乎不需要修改就能直接运行。更惊喜的是,它的上下文窗口高达262,144 Token,还能扩展到1,010,000 Token。这意味着,我可以直接把一整本小说或者一个大型项目的代码库丢给它,让它帮我总结、分析、找bug,完全不用担心“失忆”。
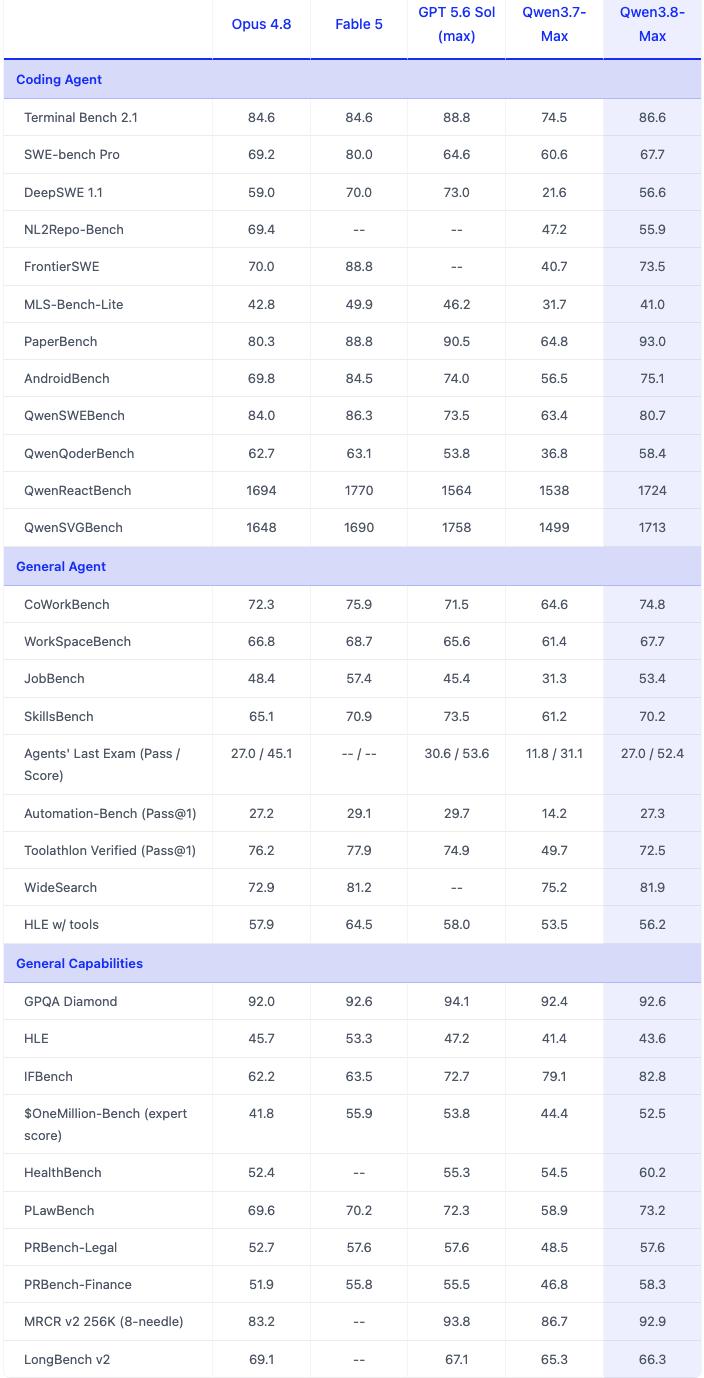
另一个让我印象深刻的是它的多步推理能力。我问它:“如果明天是周三,那么后天是周几?如果后天是晴天,那么大后天适合去野餐吗?”它不仅能准确回答“周五”,还能结合天气预测给出“适合”的建议,逻辑链条非常完整。
参数对比:Qwen3.8 vs Kimi K3
| 参数 | Qwen3.8 | Kimi K3 | | — | — | — | | 架构 | Qwen3 | Kimi K3 | | 总参数 | 2.4T | 2.8T | | 激活参数 | 95B | 103B | | 层数 | 92层 | 96层 | | 专家数 | 512个(10个路由+1共享) | 896个(16个路由) | | 注意力机制 | Gated DeltaNet + Gated Attention(3:1) | KDA + Gated MLA(3:1) | | 上下文长度 | 262,144 Token(可扩展至1,010,000) | 未披露 |
购买建议:适合谁?怎么选?🤔
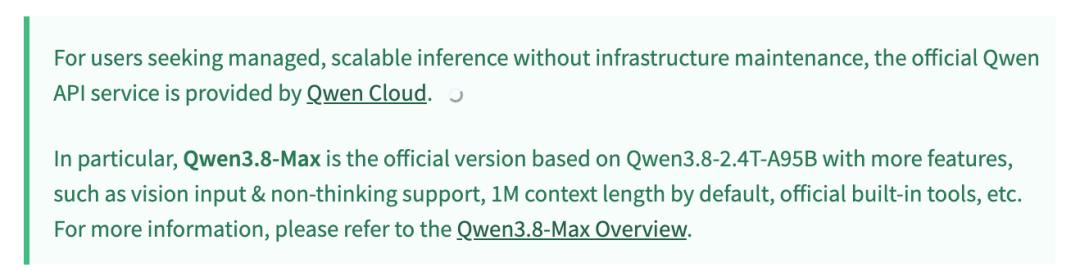
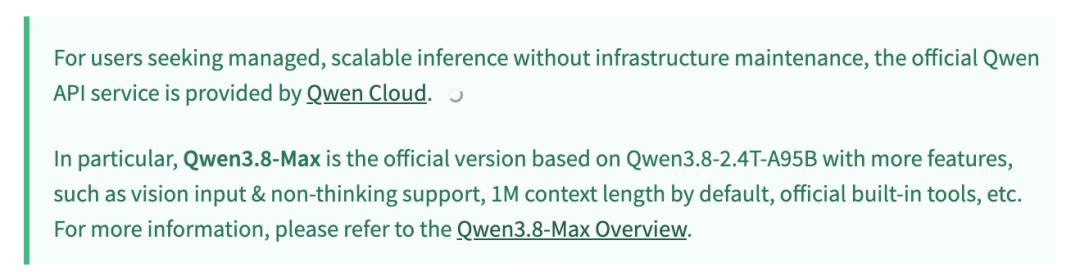
说实话,Qwen3.8这种级别的模型,更适合开发者、科研团队和有技术实力的企业。如果你是个人开发者,想体验一下“超大模型”的魅力,建议直接使用Qwen官方提供的API服务,按量付费,省心省力。
如果你有GPU服务器,想私有化部署,那么FP4量化版本是你的不二之选。单台B300或MI355X就能跑起来,成本可控。但要注意,量化会带来一定的精度损失,对于需要高精度输出的场景(如医疗、金融),建议还是用BF16版本。
至于预算,FP4量化部署的硬件成本大约在50万-100万人民币(视具体配置而定),而API调用则按Token计费,丰俭由人。
总结:国产大模型,未来可期🌟
Qwen3.8的开源,不仅是阿里的一次技术秀肌肉,更是国产大模型走向成熟的一个标志。它证明了,我们完全有能力做出世界级的大模型,并且愿意分享给整个社区。
虽然目前超大模型的训练配方已经开始收敛,但竞争远未结束。谁能把成本降得更低、把推理做得更快、把生态建得更完善,谁就能在下一轮AI浪潮中占据先机。
对于咱们普通用户来说,这绝对是个好消息——更强大的模型,更低的使用门槛,更丰富的应用场景。未来已来,你准备好了吗?🚀