通用大模型也能搞科研?哈佛团队用PG-LLM给AI“摸底考”,结果出乎意料!
还记得第一次和ChatGPT聊天时那种“这AI怕不是成精了”的震撼吗?🤯 写诗、画画、编代码样样精通,感觉它就是个无所不知的“六边形战士”。但问题来了:在蛋白质工程这种知识壁垒极高的硬核科研领域,这些通用大模型还能像在文科艺术圈里那样“大杀四方”吗?它们能帮科学家筛选出更优的蛋白突变吗?
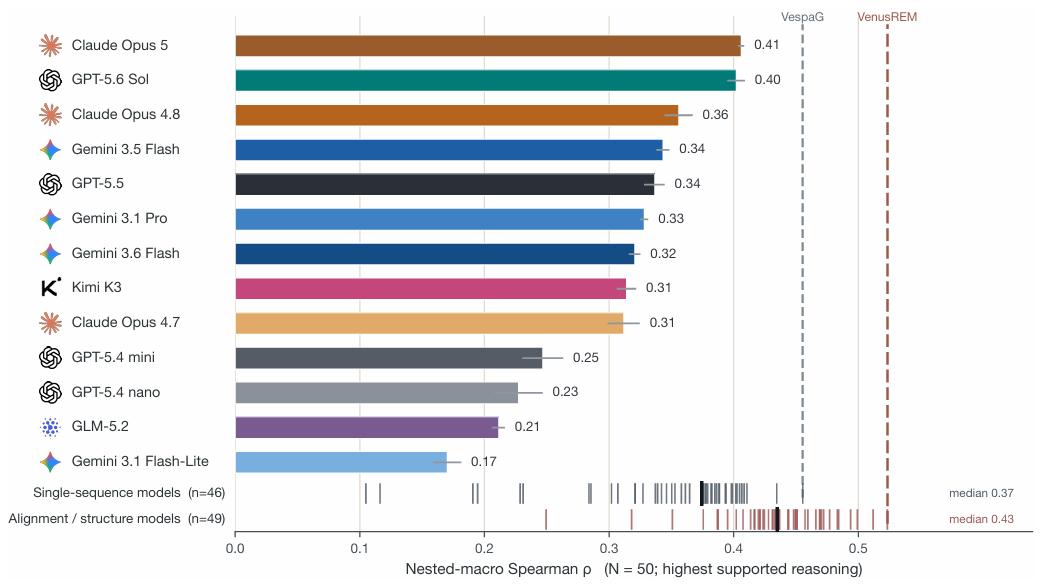
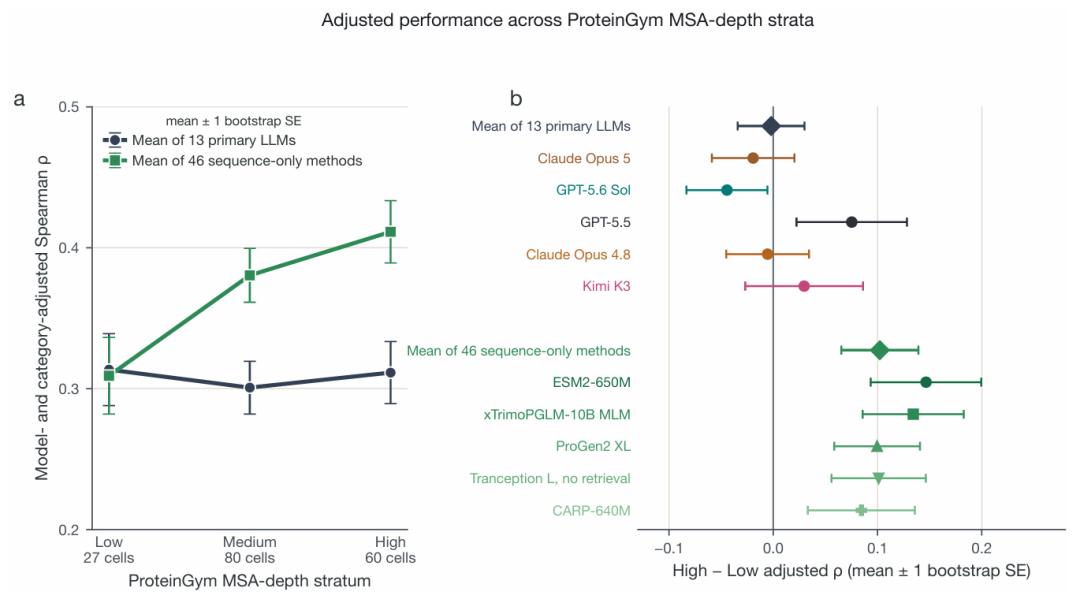
最近,哈佛大学和Capable的研究团队就干了件“搞事情”的事——他们搞了个叫 PG-LLM 的标准化评测基准,给13款主流通用大模型和95种专业蛋白质预测工具来了一场“同台竞技”的摸底考试。结果一出,整个生物信息学圈子都炸了锅:通用大模型在蛋白突变排序上的能力,居然已经超过了半数成熟的专业工具! 🔬
一场“公平”的AI比武大会
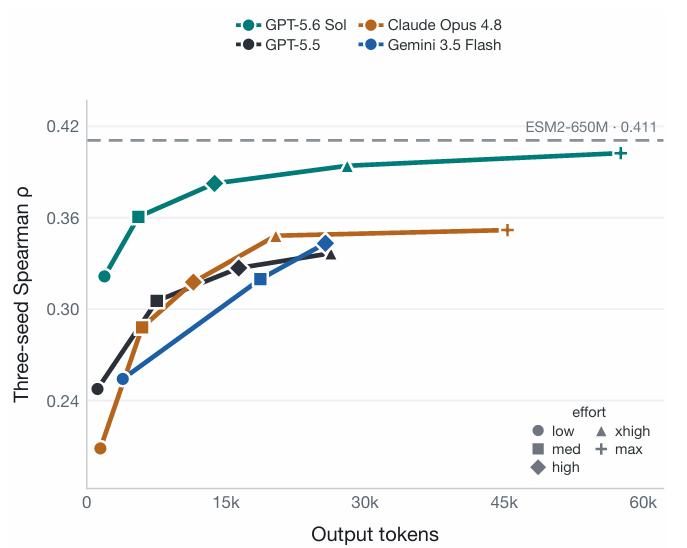
这场“比武”可不是随便玩玩。PG-LLM基准测试依托的是蛋白质突变预测领域的“黄金标准”数据集——ProteinGym v1.3,覆盖了186种蛋白质、217组实验数据,含金量十足。
为了确保公平,研究团队设计了非常严谨的测试流程:每次只给模型输入蛋白序列和实验方案描述,全程不提供任何多序列对比(MSA)或蛋白质三维结构信息,强制让AI“裸考”自主排序。而且为了防止“蒙对”,每个测试都设置了3套独立候选集,取平均分,想作弊?门都没有!
通用大模型:科研界的“跨界黑马”
测试结果真的让人眼前一亮!在零样本条件下,通用大模型展现出了惊人的“直觉”。虽然它们没有经过专门的蛋白质工程训练,但凭借强大的语言理解能力和逻辑推理能力,它们能够理解“突变后功能更好”这种抽象概念,并给出合理的排序。
这就像让一个精通多门语言的文学大师去读一篇晦涩的文言文,他可能不懂具体的生物化学公式,但能通过上下文语境和逻辑关联,判断出文章的大致走向。这种“跨界迁移能力”,正是通用大模型最迷人的地方。
专业模型依然能打,但“融合”才是未来?
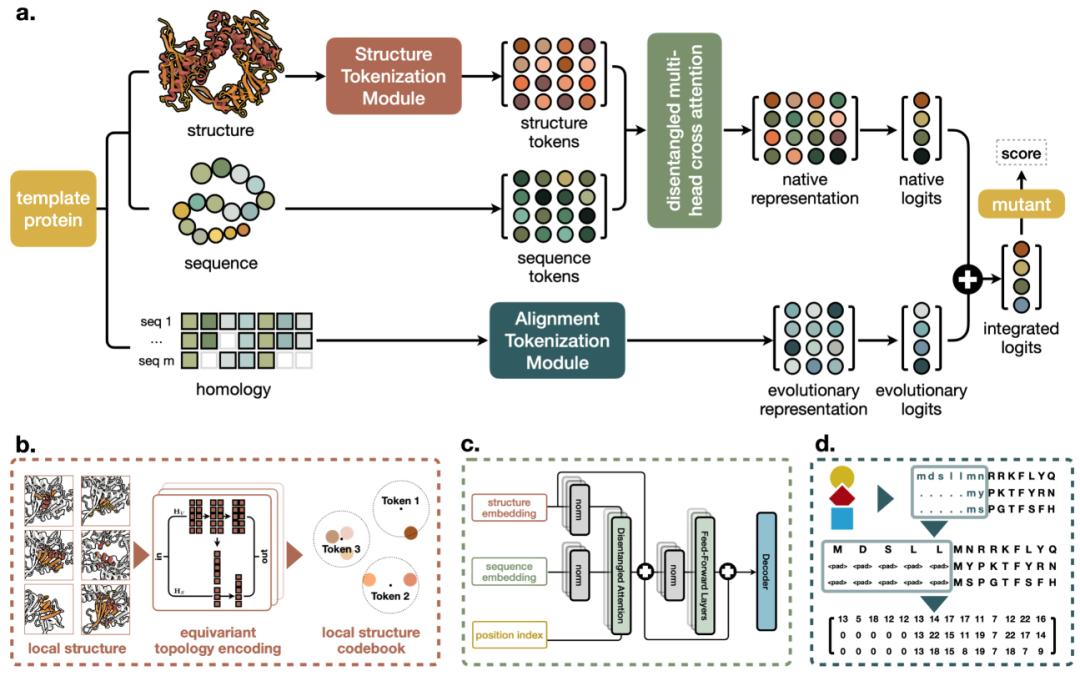
当然,95种专业蛋白质预测工具也不是吃素的。在特定任务上,它们的表现依然稳健,尤其是在处理大量序列数据时,效率优势明显。但PG-LLM基准测试的意义在于,它清晰地划定了两类模型的性能边界。
研究团队还发现,两类模型的“思考方式”存在本质差异。专业模型依赖进化信息和物理化学原理,而通用大模型则更侧重于语义理解。这为未来的融合方案提供了绝佳思路——让专业模型提供精准的“硬核数据”,让通用大模型负责“宏观推理”,两者结合,或许能碰撞出更耀眼的火花!
科研人员的新“外挂”?
对于从事蛋白质工程、药物研发的科研人员来说,这绝对是个好消息。通用大模型不仅易于使用(不需要复杂的生物信息学背景),而且能提供全新的视角。虽然目前还不能完全替代专业工具,但作为辅助筛选的“外挂”,绝对值得一试。
购买建议与展望
适合人群:
- 生物信息学研究者、结构生物学家、合成生物学从业者
- 对AI+科学交叉领域感兴趣的开发者
- 需要快速筛选蛋白突变方案的企业研发部门
“预算”参考:
- 通用大模型API调用成本相对较低,适合预算有限的研究组
- 专业预测工具(如AlphaFold系列)需要一定算力支持,投入较高
- 建议科研团队采用“通用大模型初筛 + 专业模型精修”的组合策略,性价比最高
PG-LLM基准的提出,不仅是一次技术测评,更是对AI在科学发现中角色的一次深刻思考。它告诉我们,通用大模型的价值远不止于聊天和写诗,它们正在成为科研工作者的“超级外脑”。未来,随着模型能力的不断进化,AI辅助科学发现的门槛将进一步降低,更多“不可能”将变成“可能”!🚀