
视频生成大模型卷疯了!从“图能动”到“直接出片”,国产AI迎来生产力革命🎬
还记得两年前,我们刷到AI生成的视频,要么是人物手指乱飞,要么是走路走着走着就“换头”的惊悚场面吗?当时大家的心态大多是“图一乐”。但如果你现在还这么想,那可就大错特错了!
2026年的今天,国产视频生成大模型已经悄悄完成了一场“变形记”。它们不再满足于让一张图片“动起来”,而是直接奔着“进组拍戏”去了。从字节跳动的Seedance到快手可灵,从阿里万相到生数Vidu,一场关于“视频生产力”的终极对决,已经白热化。
今天,咱们不聊晦涩的代码,就用大白话聊聊:这场AI视频大乱斗,到底给我们普通人和创作者带来了什么硬核福利?
告别“一眼假”,AI终于学会了“物理常识”🧠
以前用AI生成视频,最让人抓狂的是什么?是“薛定谔的物理定律”。杯子掉地上可能穿模,汽车转弯可能漂移,最离谱的是主角转个身,脸就变成了另一个人。
但现在,头部模型主攻的“主体一致性”和“可控性”,直接解决了这个痛点。你可以上传几张参考图,给AI立下“军令状”:这个角色必须长这样,衣服不能换,场景不能变!无论是Vidu的多图约束,还是万相的多模态输入,都在把AI从“盲盒生成器”改造成“听话的摄影机”。
这意味着什么?意味着你不再需要为了一个满意的镜头,熬夜“抽卡”几百次。AI终于从“艺术创作”向“工业流水线”迈出了一大步。
音画一体+工作流整合:一个人就是一支军队💪
如果说画面进步是“术”,那么“音画同步”和“工作流整合”就是“道”的飞跃。
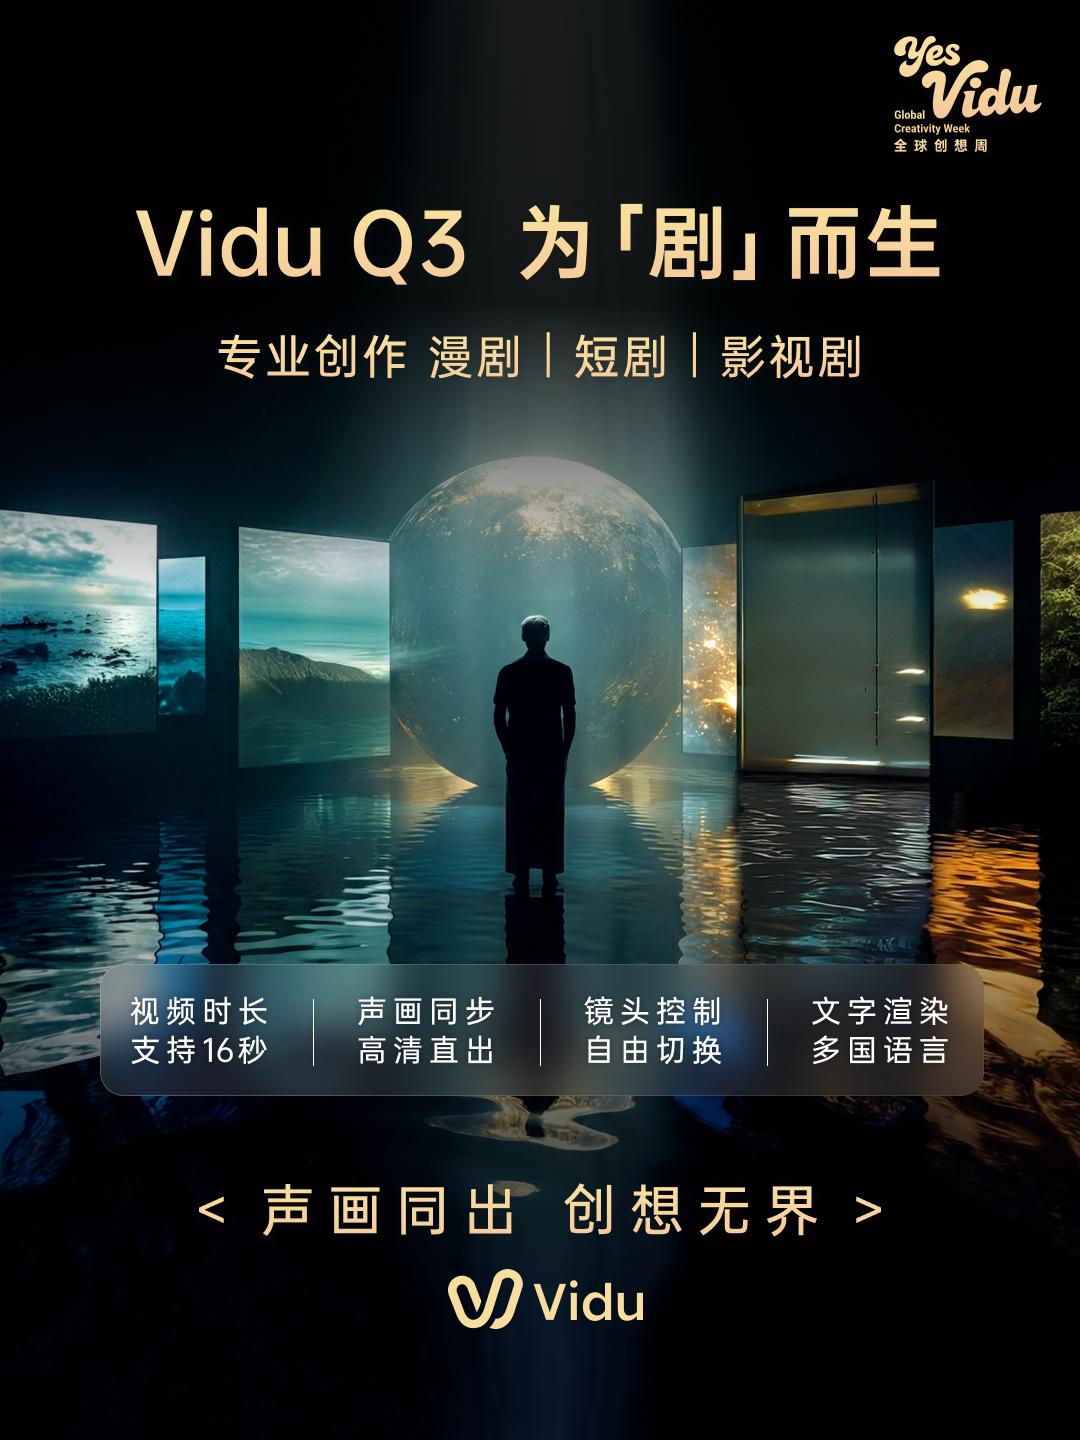
还记得以前做视频的噩梦吗?画面生成后,还要去别的地方找配音、配BGM、对口型,光是剪辑软件的时间轴就能把人逼疯。现在,像可灵3.0和Vidu Q3这些“卷王”,已经支持原生音频生成了!
你只需要输入一段文字,AI不仅能生成画面,还能同步生成对白、音效甚至背景音乐!更绝的是,现在的模型支持“自然语言修改”。你不需要重新生成整段视频,只需要说一句“把主角的红色外套换成蓝色”,或者“把最后一个镜头拉长5秒”,AI就能精准执行。
这种从“生成”到“生产”的转变,让短视频创作者、广告导演甚至游戏CG制作者,真正实现了“一个人就是一支军队”。
生态对决:谁能让“小白”也能轻松出大片?🚀
现在判断一个AI模型好不好用,不能只看它的“炫技”视频有多酷,更要看“结果下限”——普通人连续用十次,能有几次拿到能直接用的素材?
在这方面,背靠抖音的字节跳动和拥有快手的可灵,优势太明显了。它们不是在做“孤立的技术”,而是在做“内容生态的延伸”。
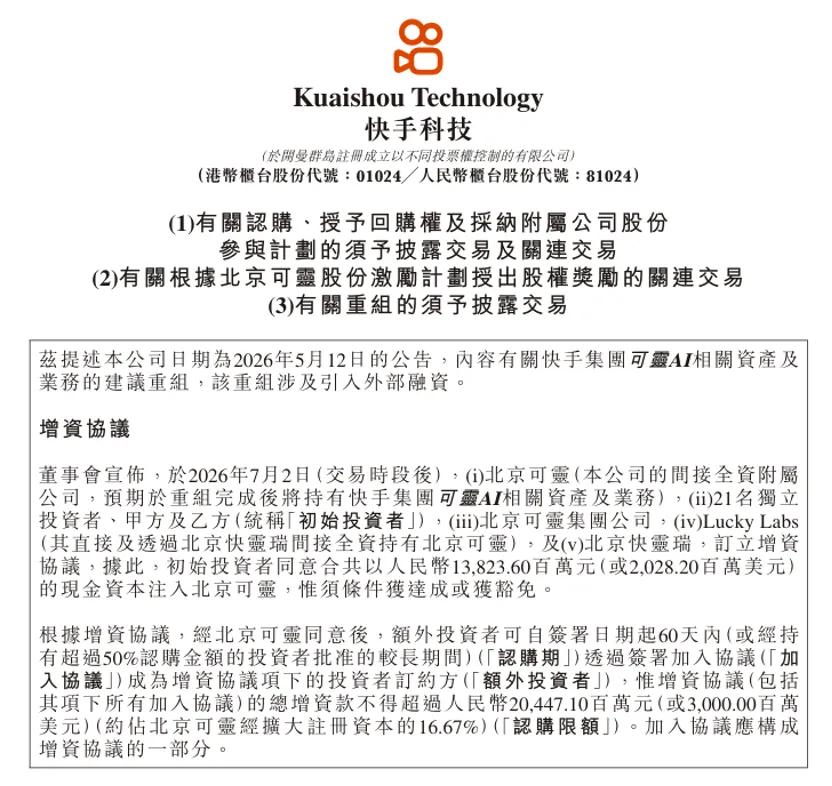
比如快手可灵,它已经跑通了商业化闭环。据报道,可灵AI在2025年Q4收入达到3.4亿元人民币,单月收入突破2000万美元!这说明什么?说明真的有大量用户愿意为它付费,因为它能实实在在帮创作者赚钱。
而字节跳动则更狠,它把模型、即梦、剪映、CapCut全部打通。对于普通用户来说,我根本不用管底层是啥模型,我只需要在剪映里点几下,就能把AI生成的素材直接剪辑发布到抖音。这种“傻瓜式”的操作闭环,才是真正的护城河。
我的真实体验:效率提升了不止一个档次📈
作为一个经常需要产出视频内容的数码博主,我最近深度体验了这些新模型。最直观的感受是:“返工率”大幅下降。
以前用AI做视频,10次生成里能挑出1个能用的就不错了。现在,随着首尾帧控制和动作迁移技术的成熟,我可以精确控制镜头运动。比如我输入“镜头从远景缓缓推近,主角转身微笑”,AI能精准理解“推近”和“转身”的运镜逻辑,生成的素材基本不需要大改。
更惊喜的是,现在的模型对中文语境的理解已经非常本土化。你说“赛博朋克风格的重庆火锅店”,它不会给你生成一个纽约街景,而是真的能拿捏住那种“魔幻8D城市”的烟火气。
购买建议与总结:现在入手,正当时!💡
那么,面对这些五花八门的模型,我们该怎么选?
如果你是短视频创作者或广告从业者: 预算充足直接上可灵AI或字节Seedance的会员。它们的工作流整合度最高,且商业化变现路径最成熟。特别是可灵,对于做信息流广告的团队来说,单月2000万美元的收入数据背后,是无数商家真金白银的认可。预算区间: 月费约几百元,但换来的是一天出100条素材的效率,性价比极高。
如果你是影视爱好者或独立制片人: 可以关注Vidu和阿里万相。它们在主体一致性和多模态控制上做得非常出色,适合需要精细控制角色和场景的叙事类内容。预算区间: 按量付费,适合项目制使用。
最后总结一句话: 2026年的AI视频,已经不是“玩具”,而是实打实的“生产力工具”。它正在像当年的智能手机一样,重构整个视频产业的内容生产链路。如果你还在观望,不妨花几十块钱充个会员试试水。相信我,当你第一次用自然语言“指挥”AI完成一条音画俱佳的视频时,那种掌控感,绝对会让你上瘾!🚀
产品图集