
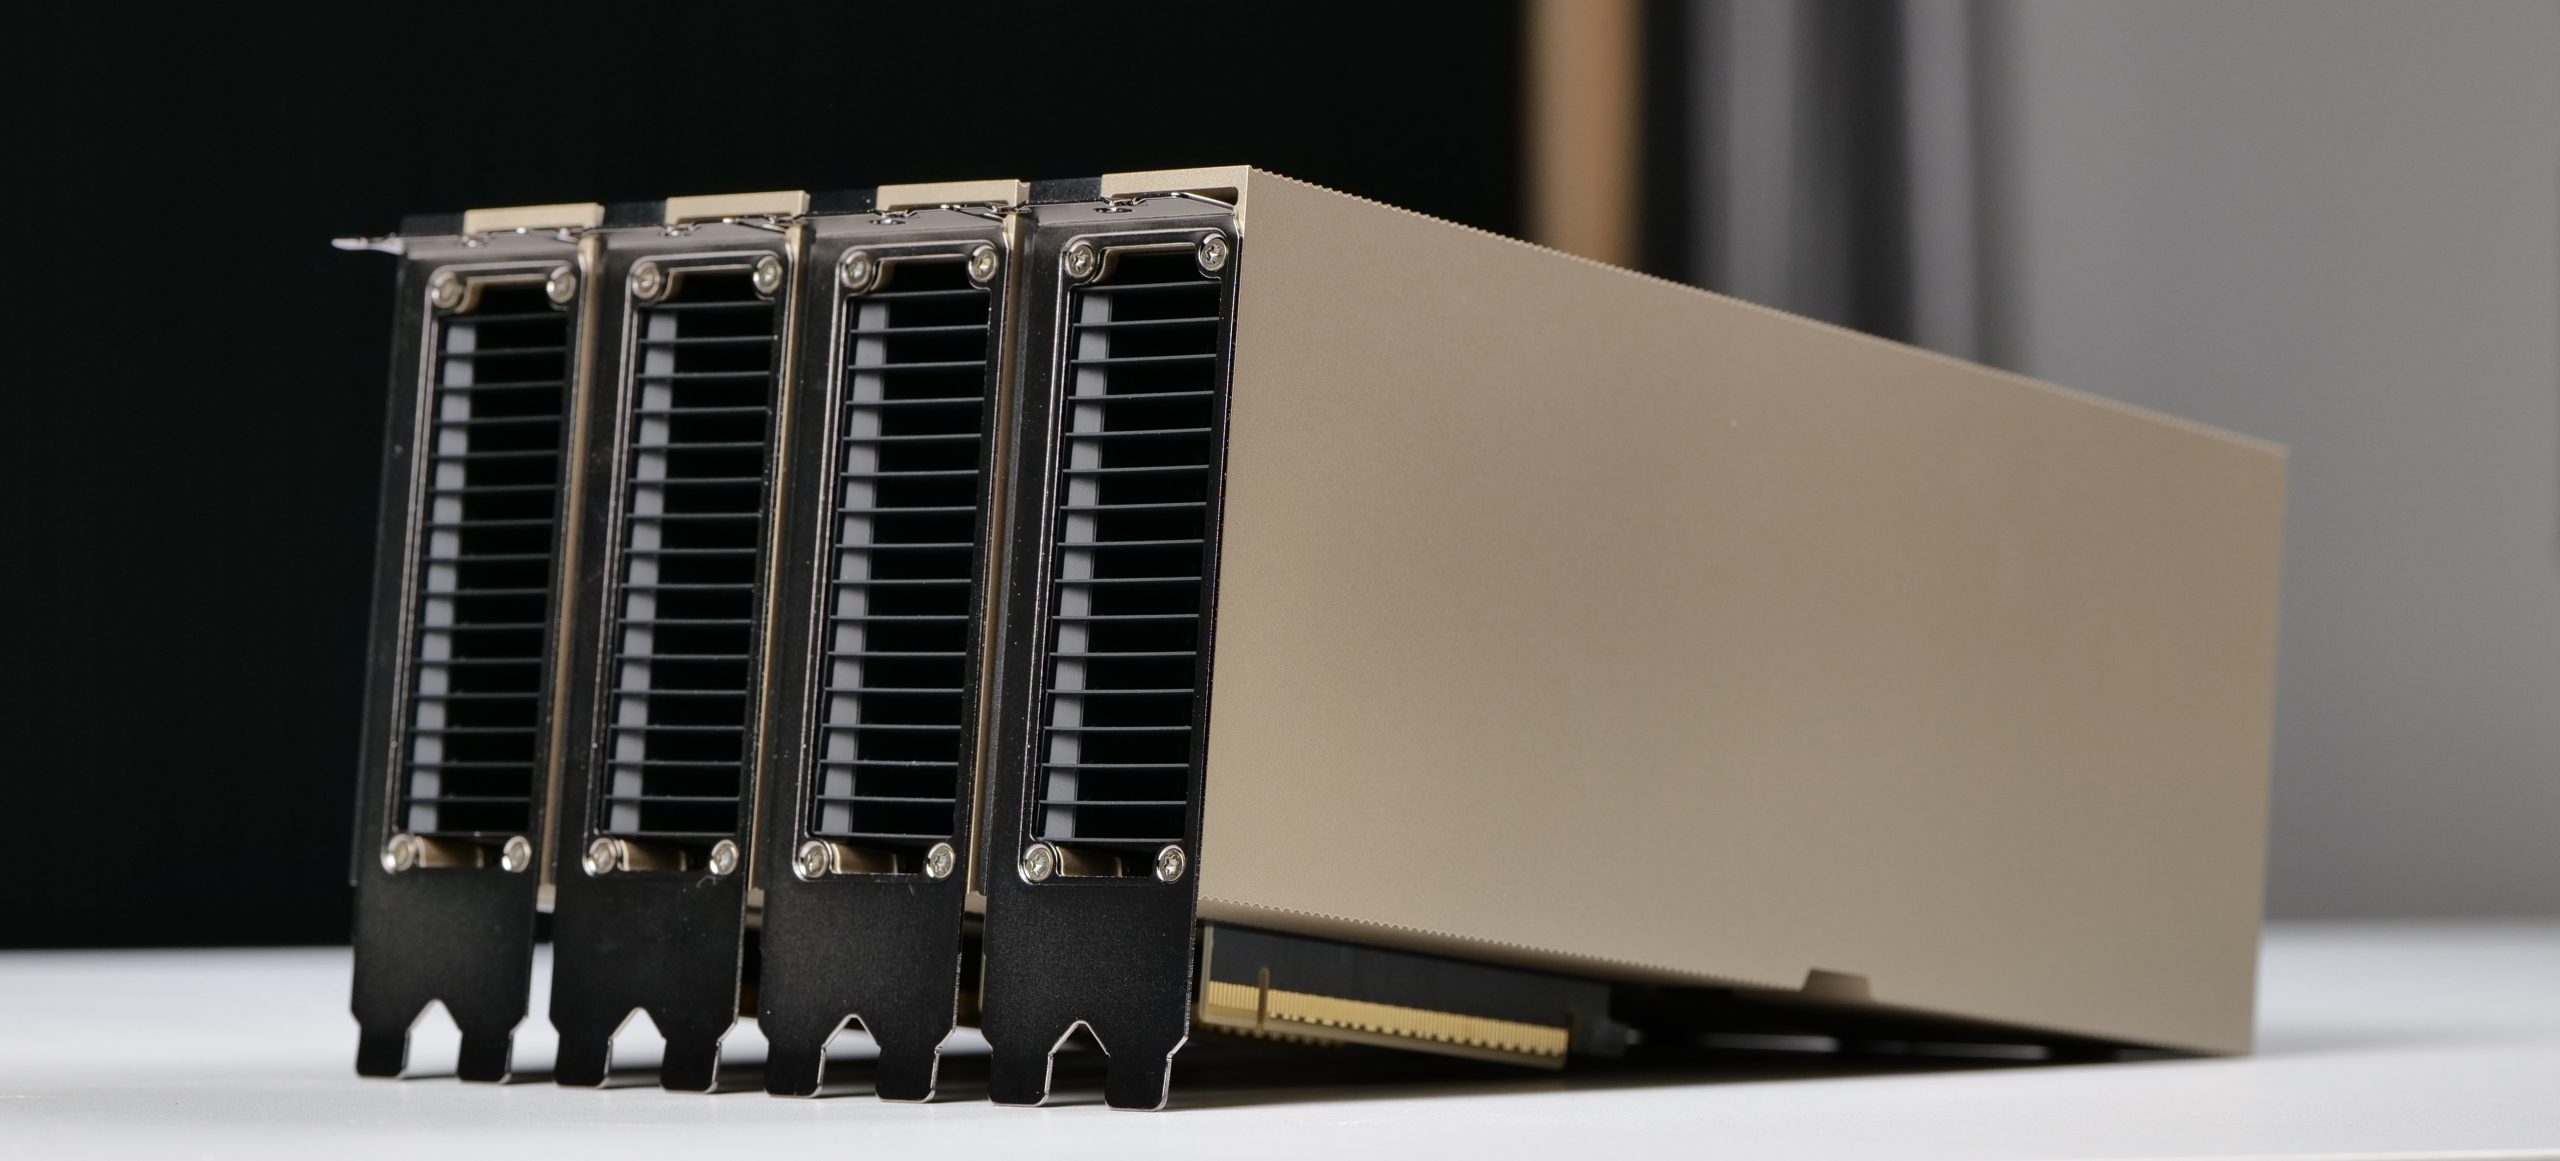
四卡H100塞进个人工作站?这波操作直接把大模型部署天花板捅穿了!🚀
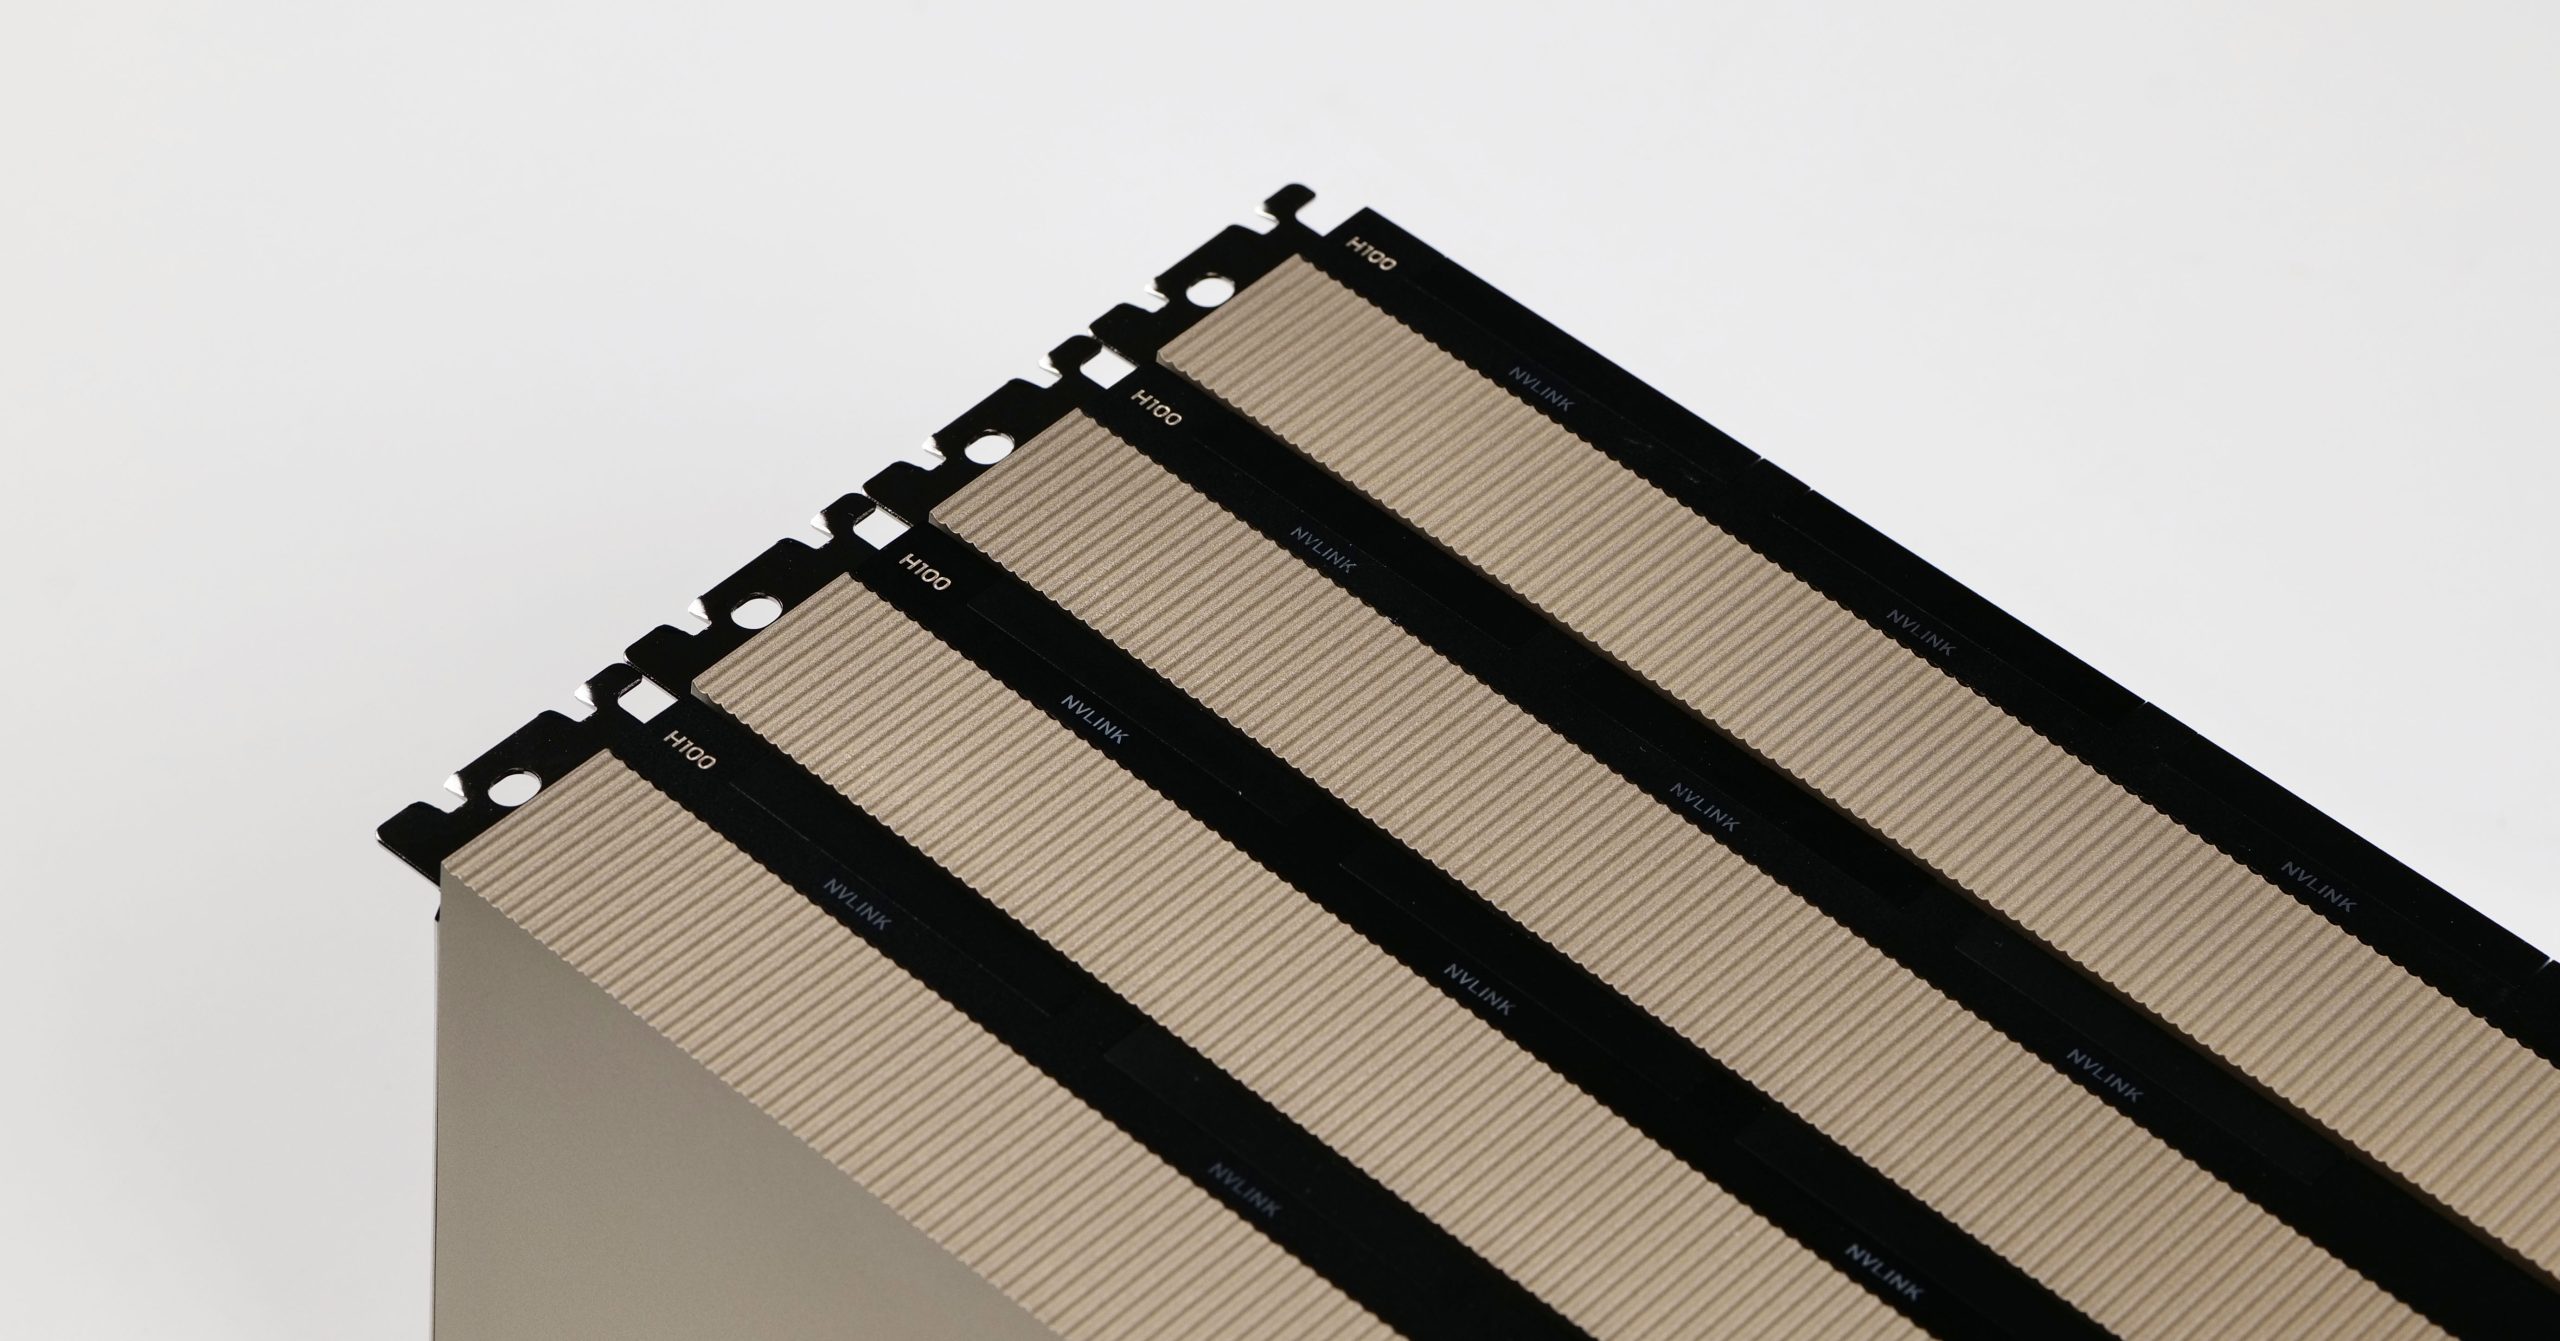
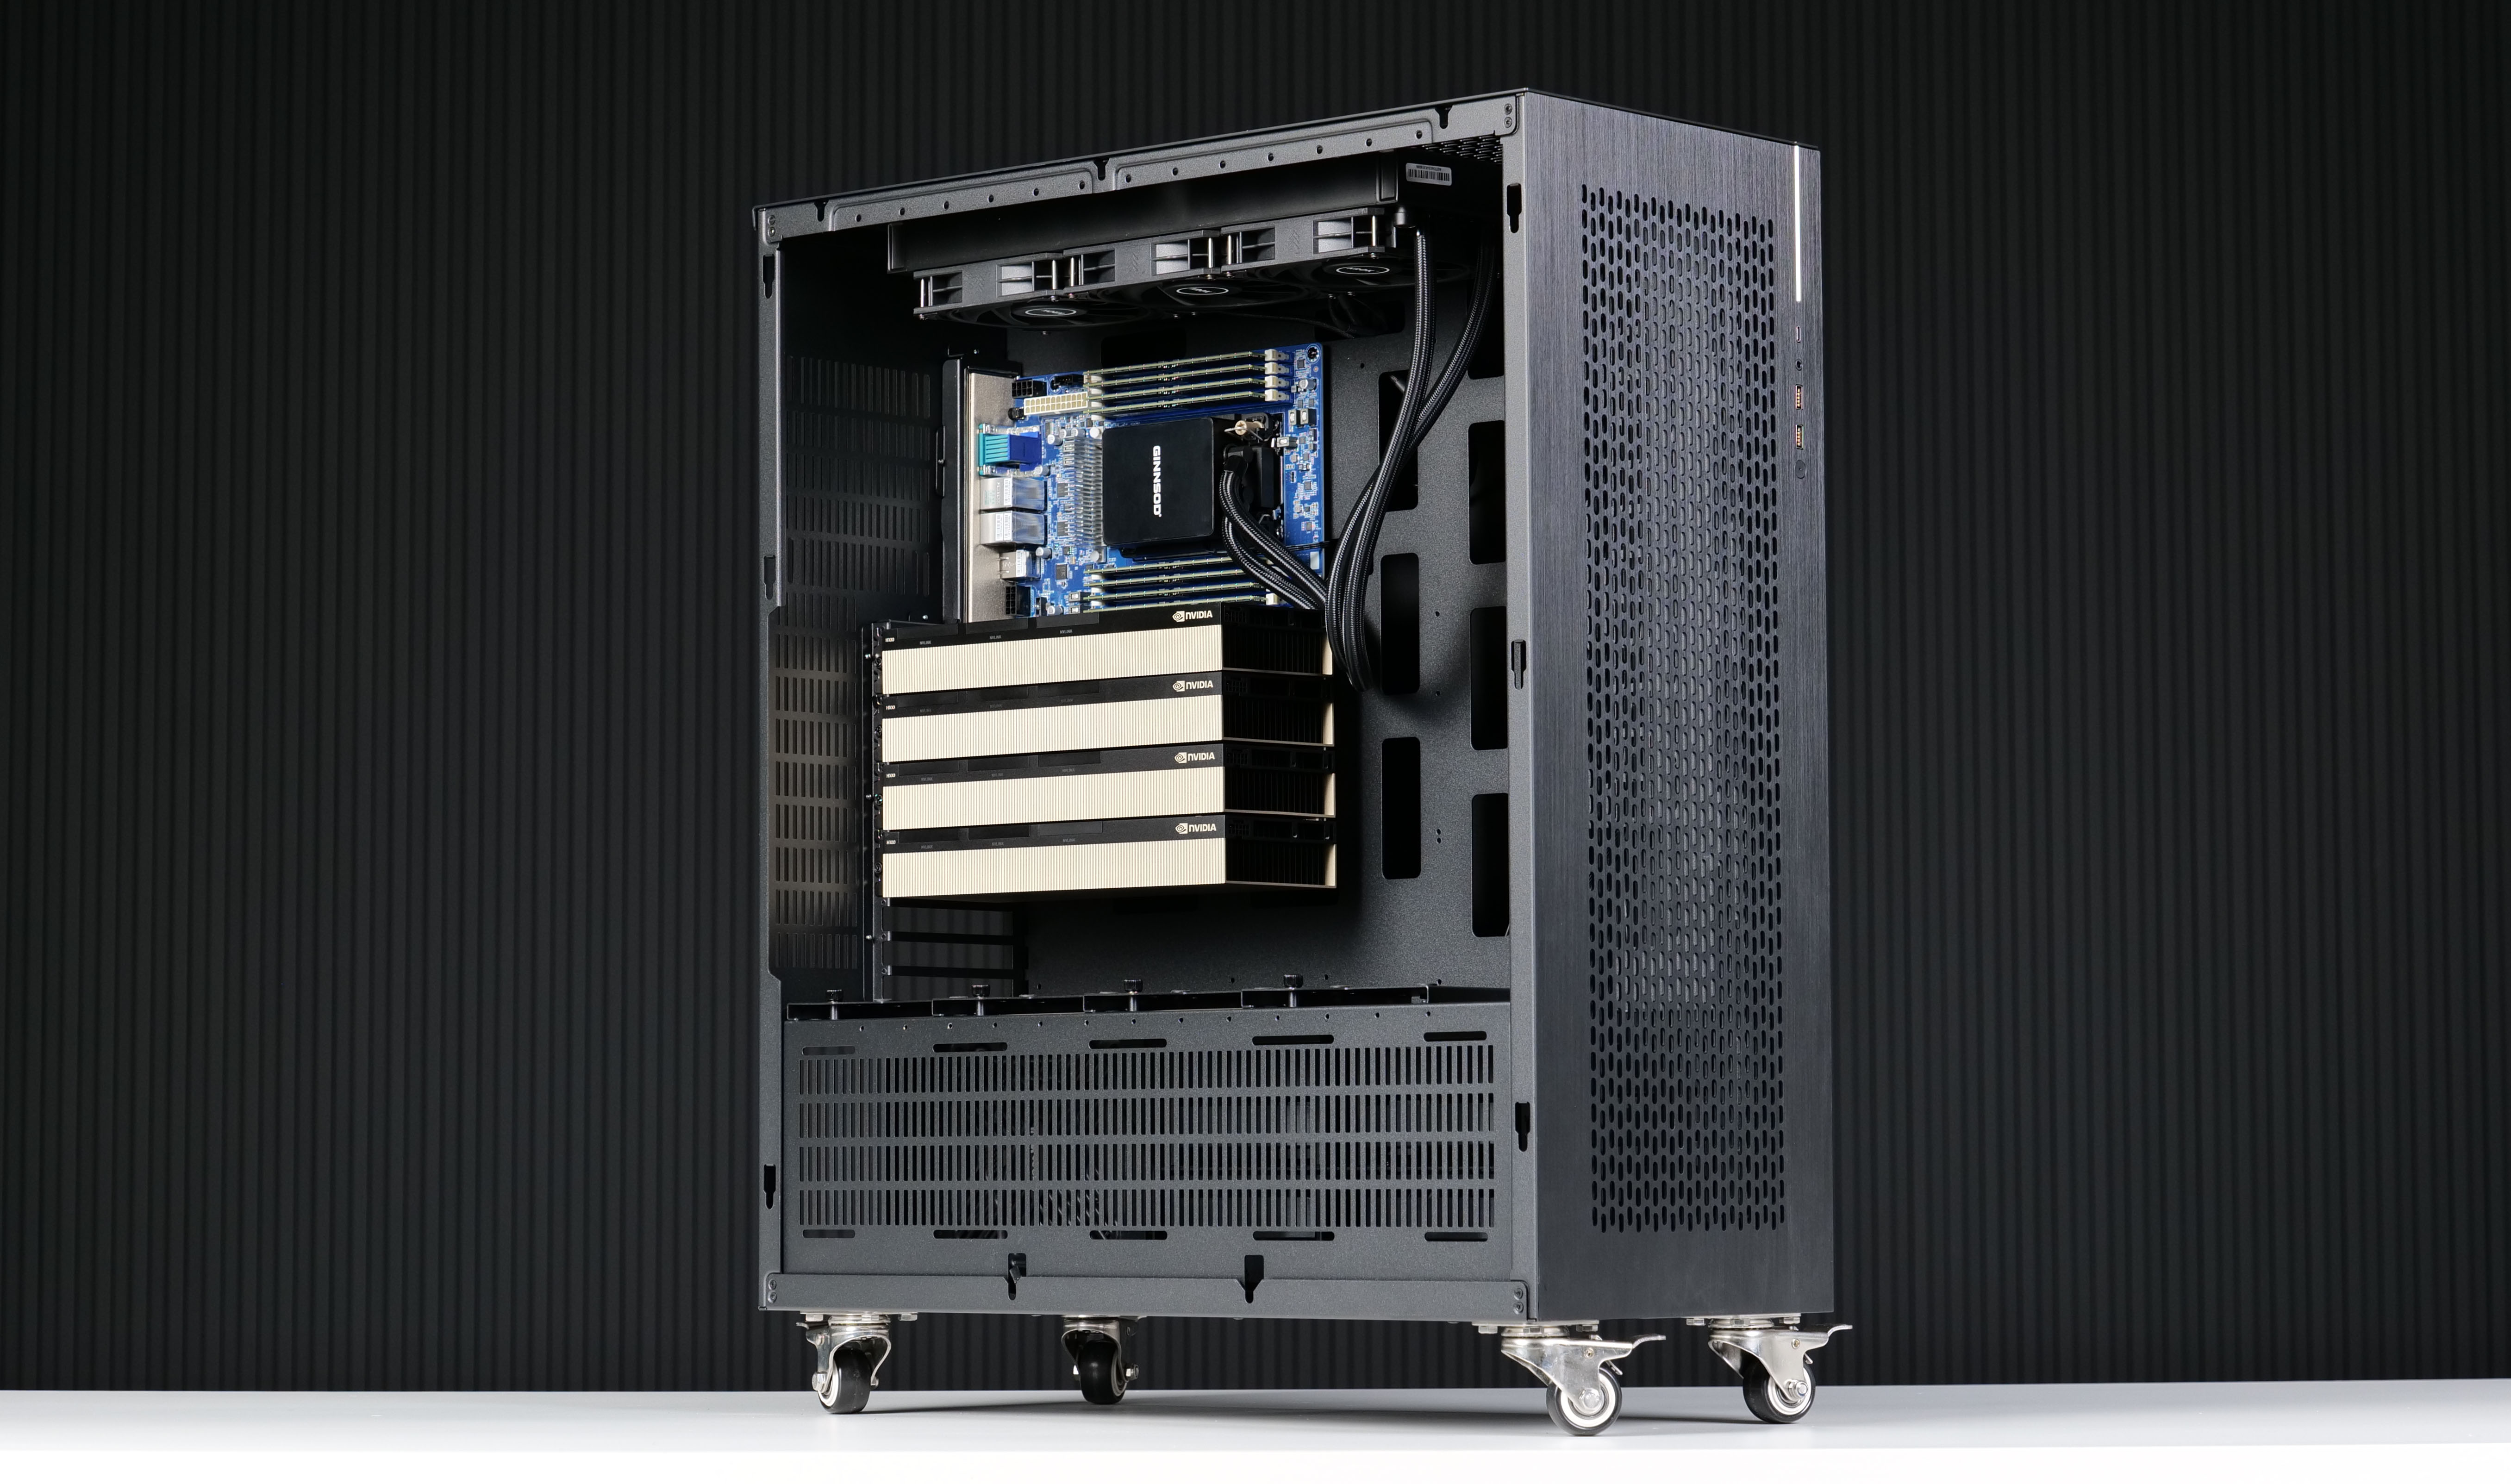
兄弟们,你们敢信吗?四张NVIDIA Tesla H100 80GB,整整320GB显存,就这么被塞进了一台个人工作站里!不是机房,不是云服务器,就摆在桌边,安静得像台普通主机。当我在本地跑起671B参数的大模型,看着代码以秒为单位疯狂输出的时候,整个人都麻了——这哪是电脑,这是印钞机啊!💰
开箱即王炸:这配置单看得我血压飙升
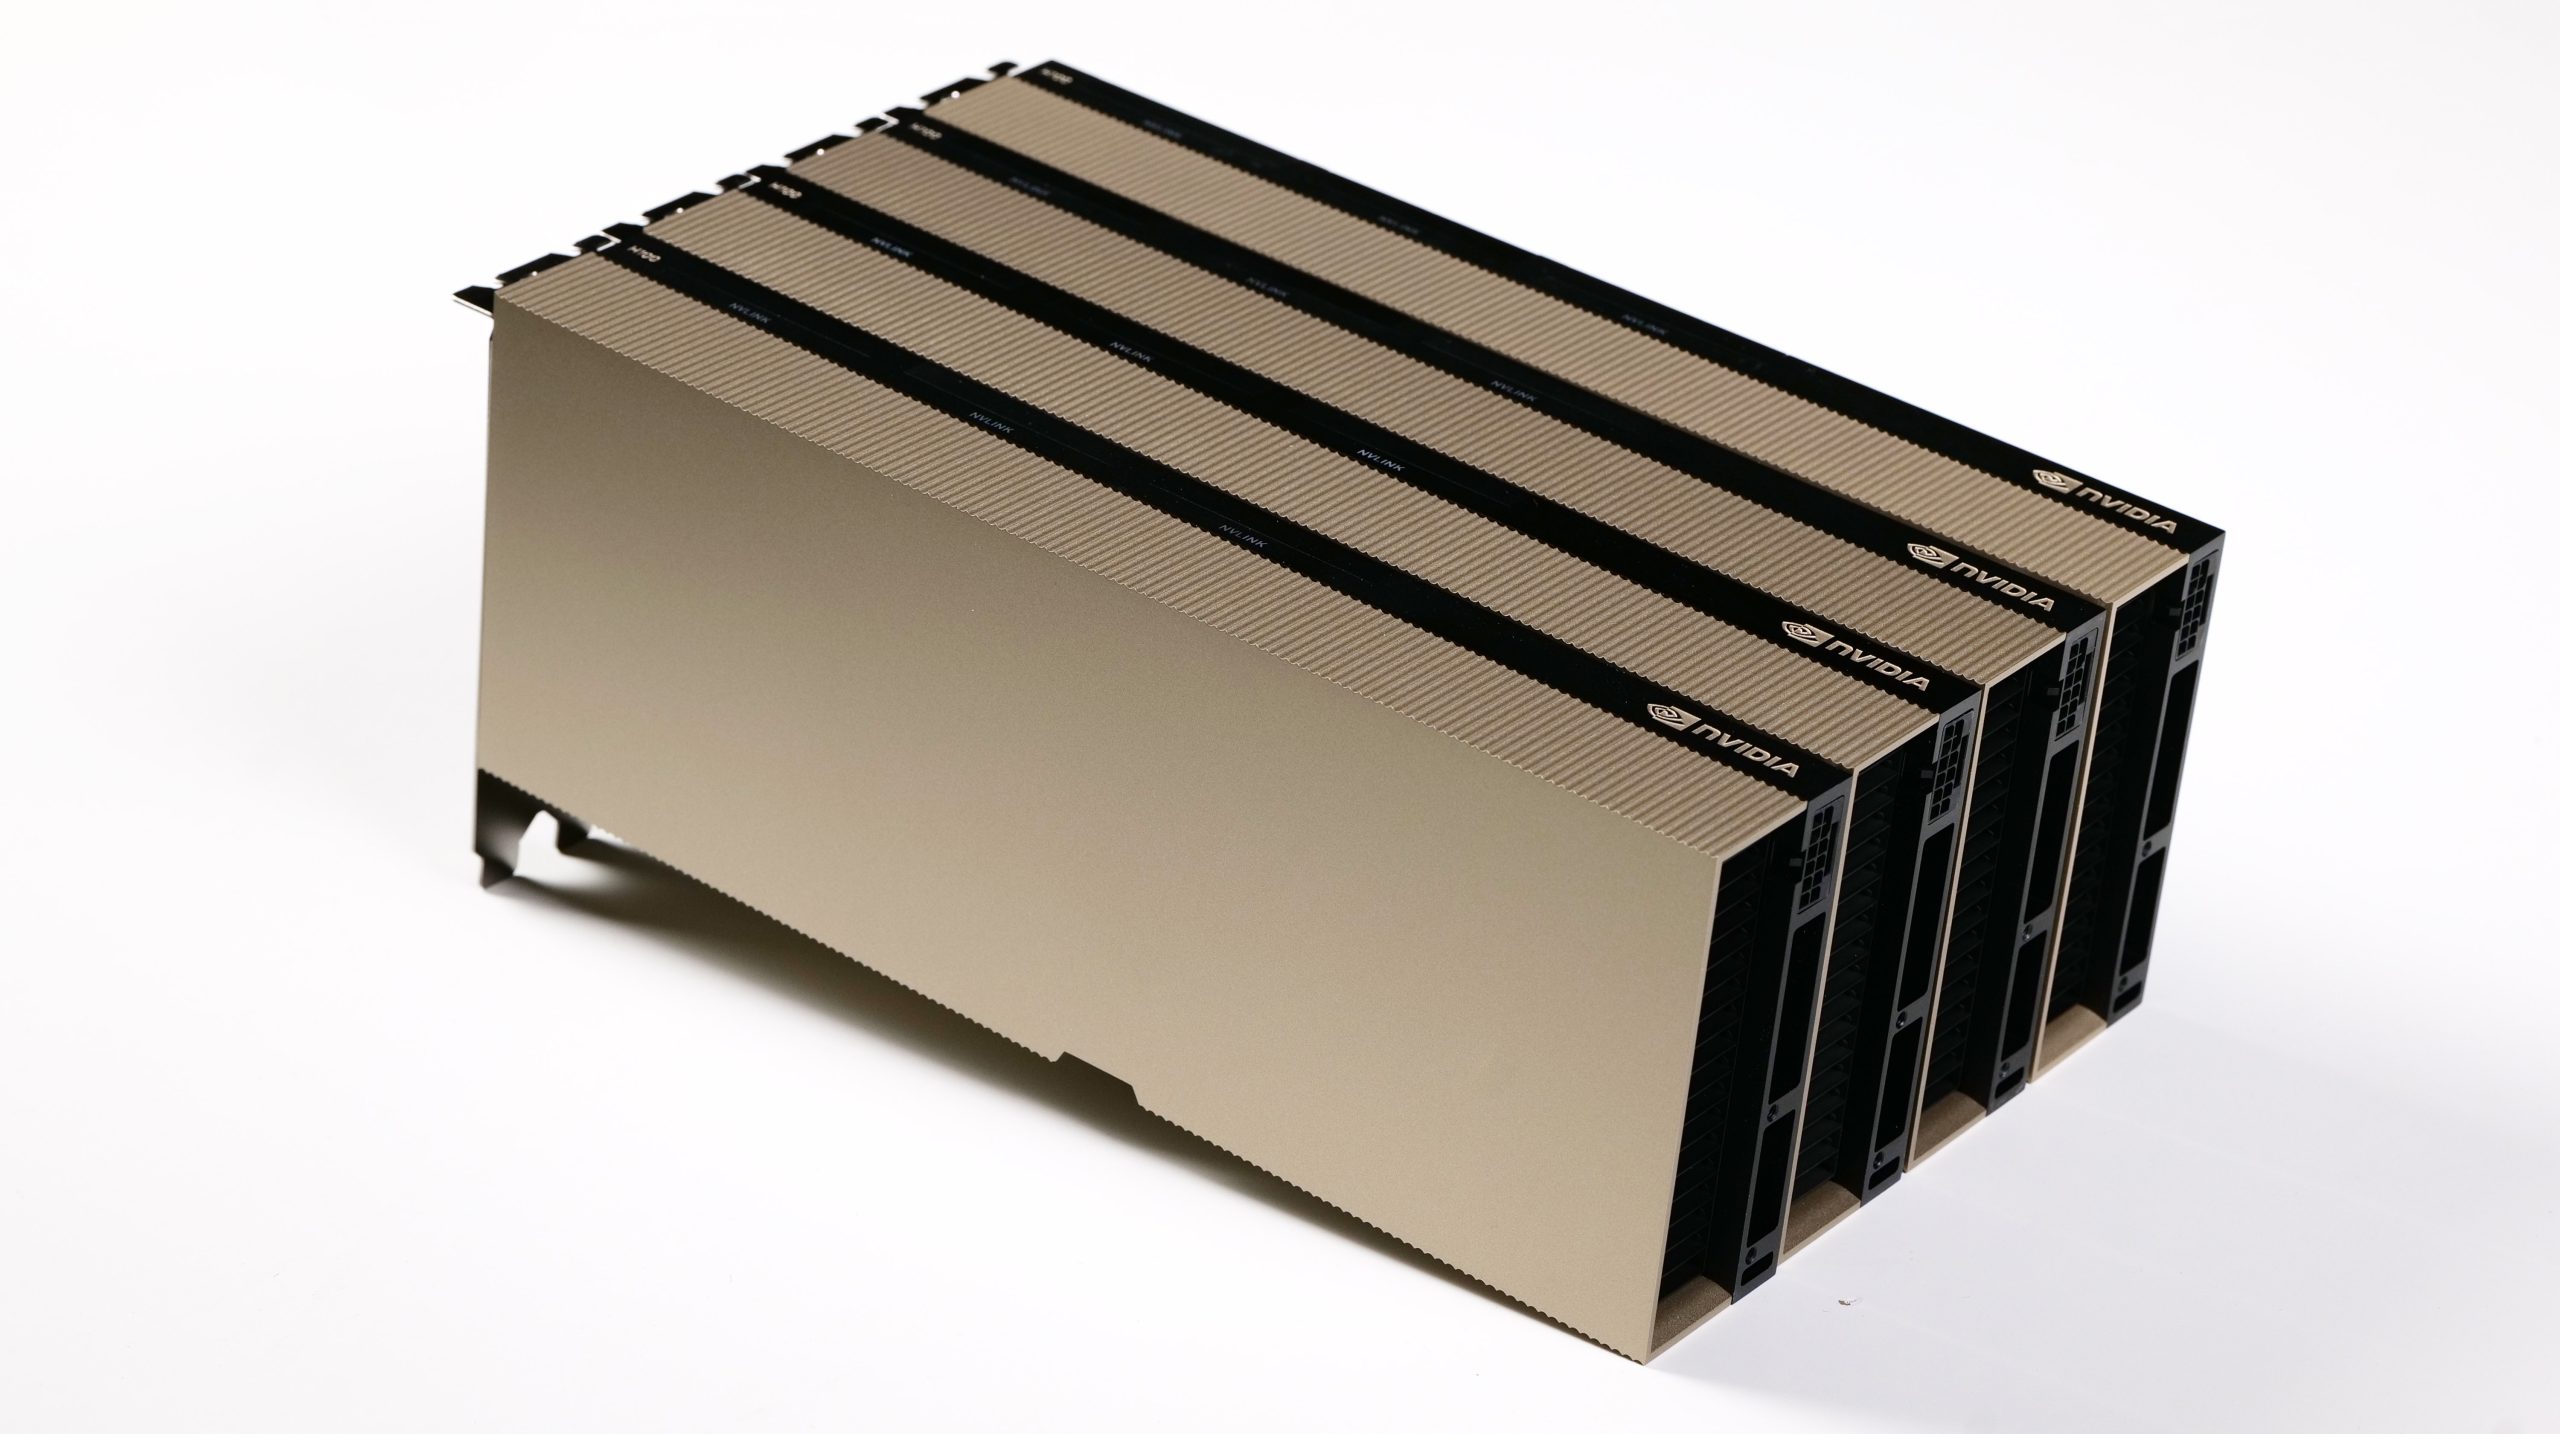
先别急着划走,咱们直接上硬货。这套方案的完整配置如下:
- 处理器:Intel第四代至强铂金8473C(52核心104线程)
- 主板:技嘉MS03-CE0
- 内存:三星512GB DDR5 RECC 4800(64GB×8)
- 硬盘:三星990Pro 4TB Gen4 NVME
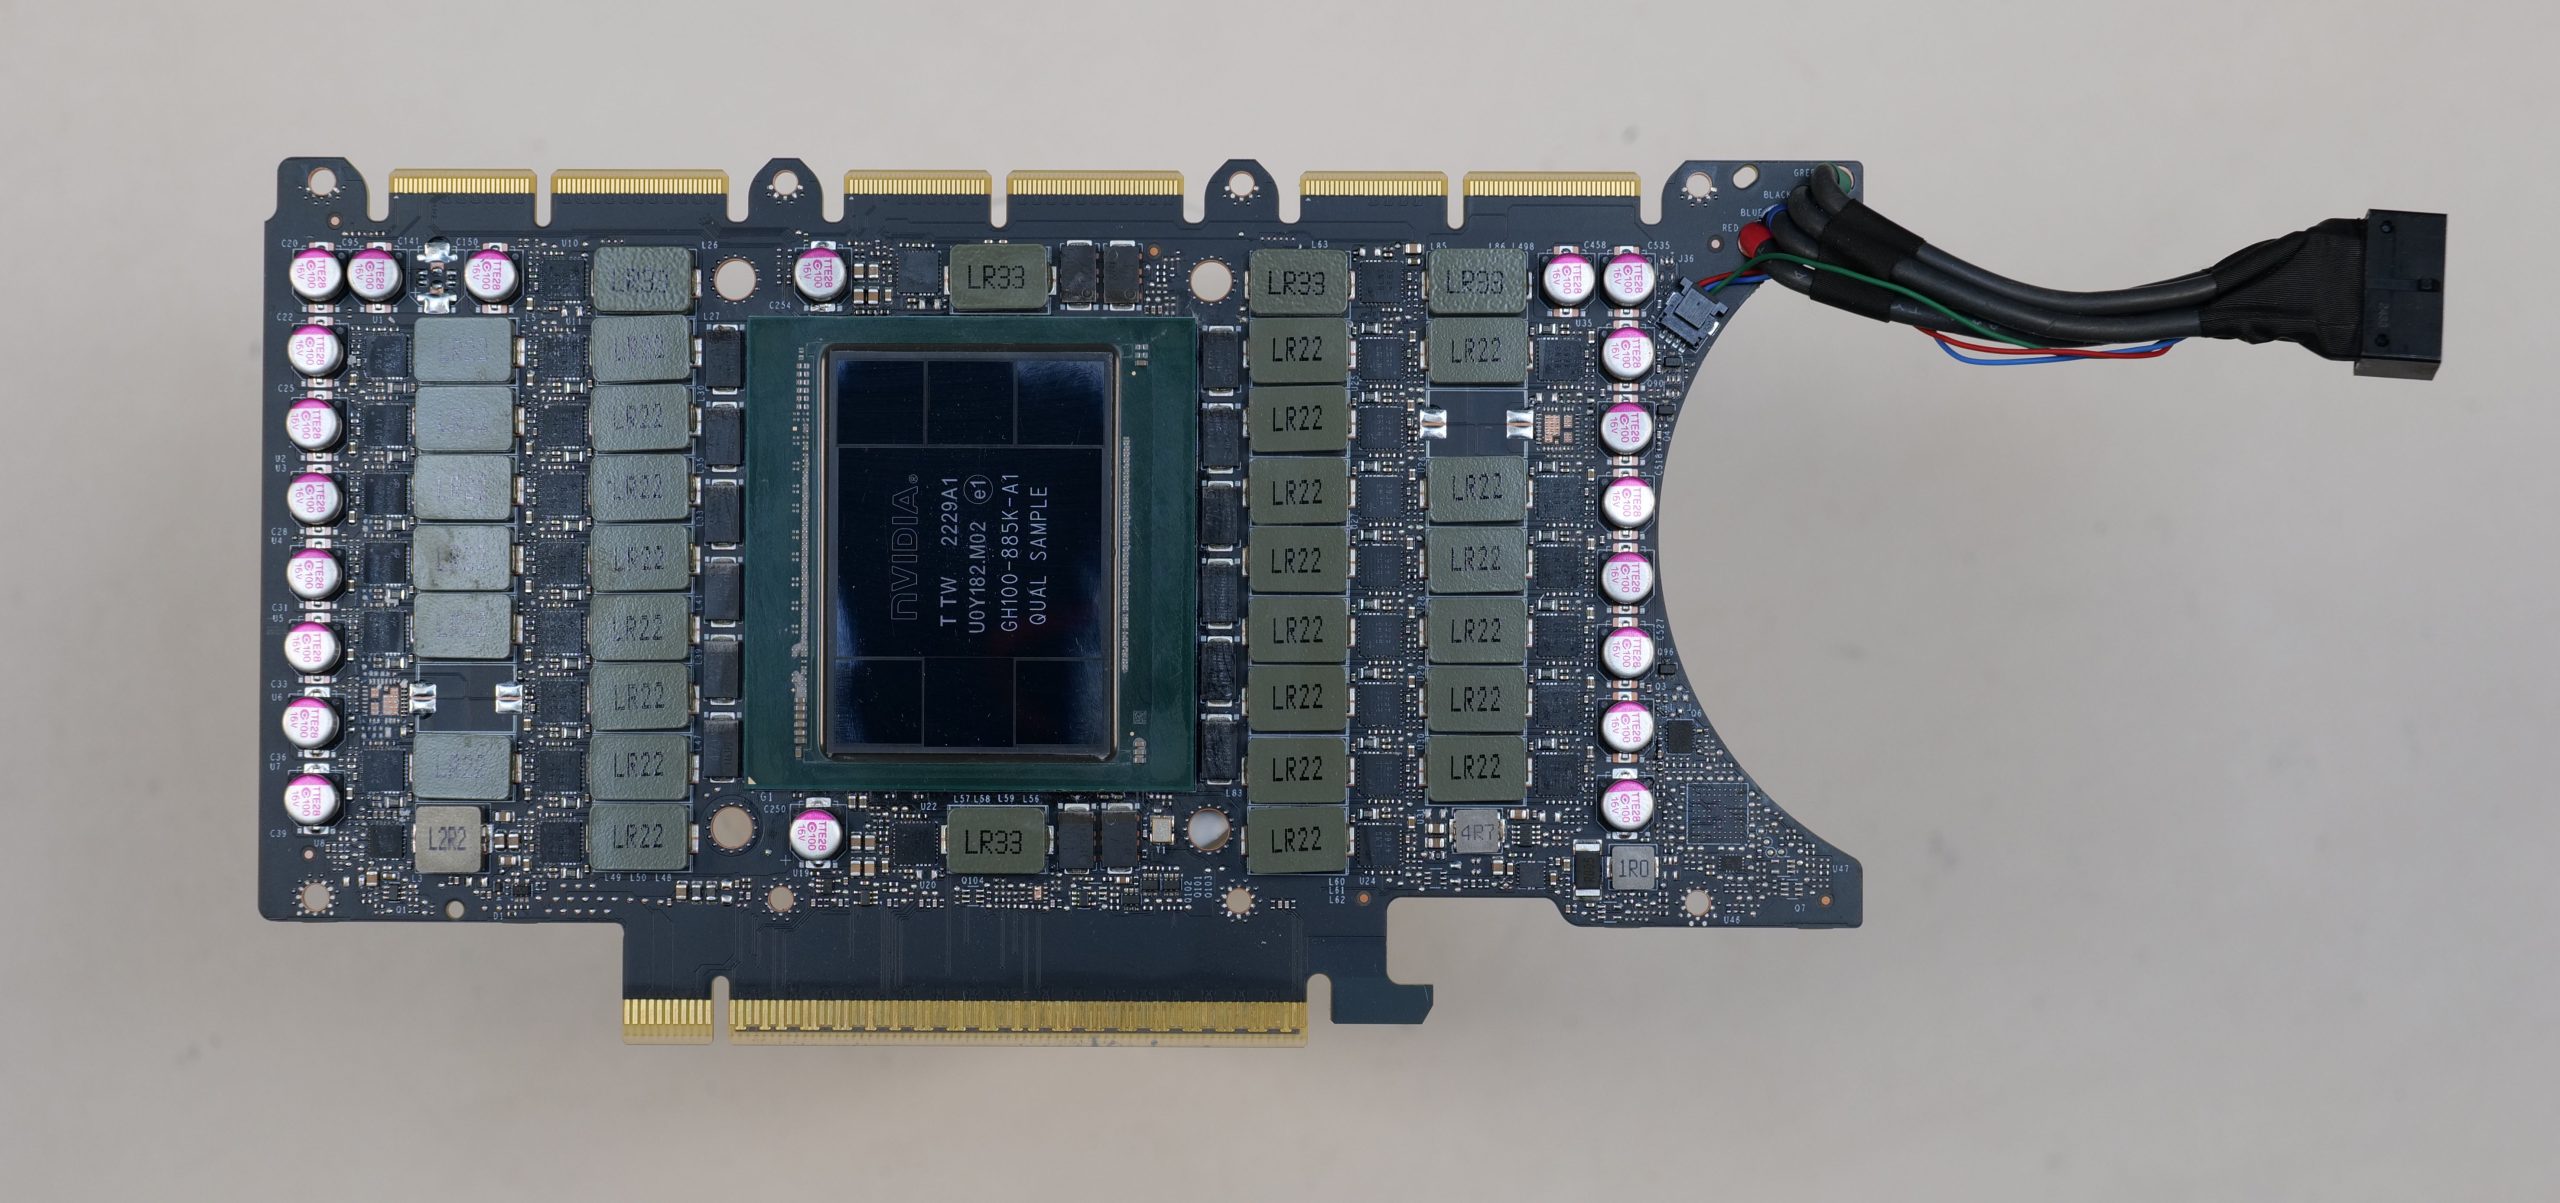
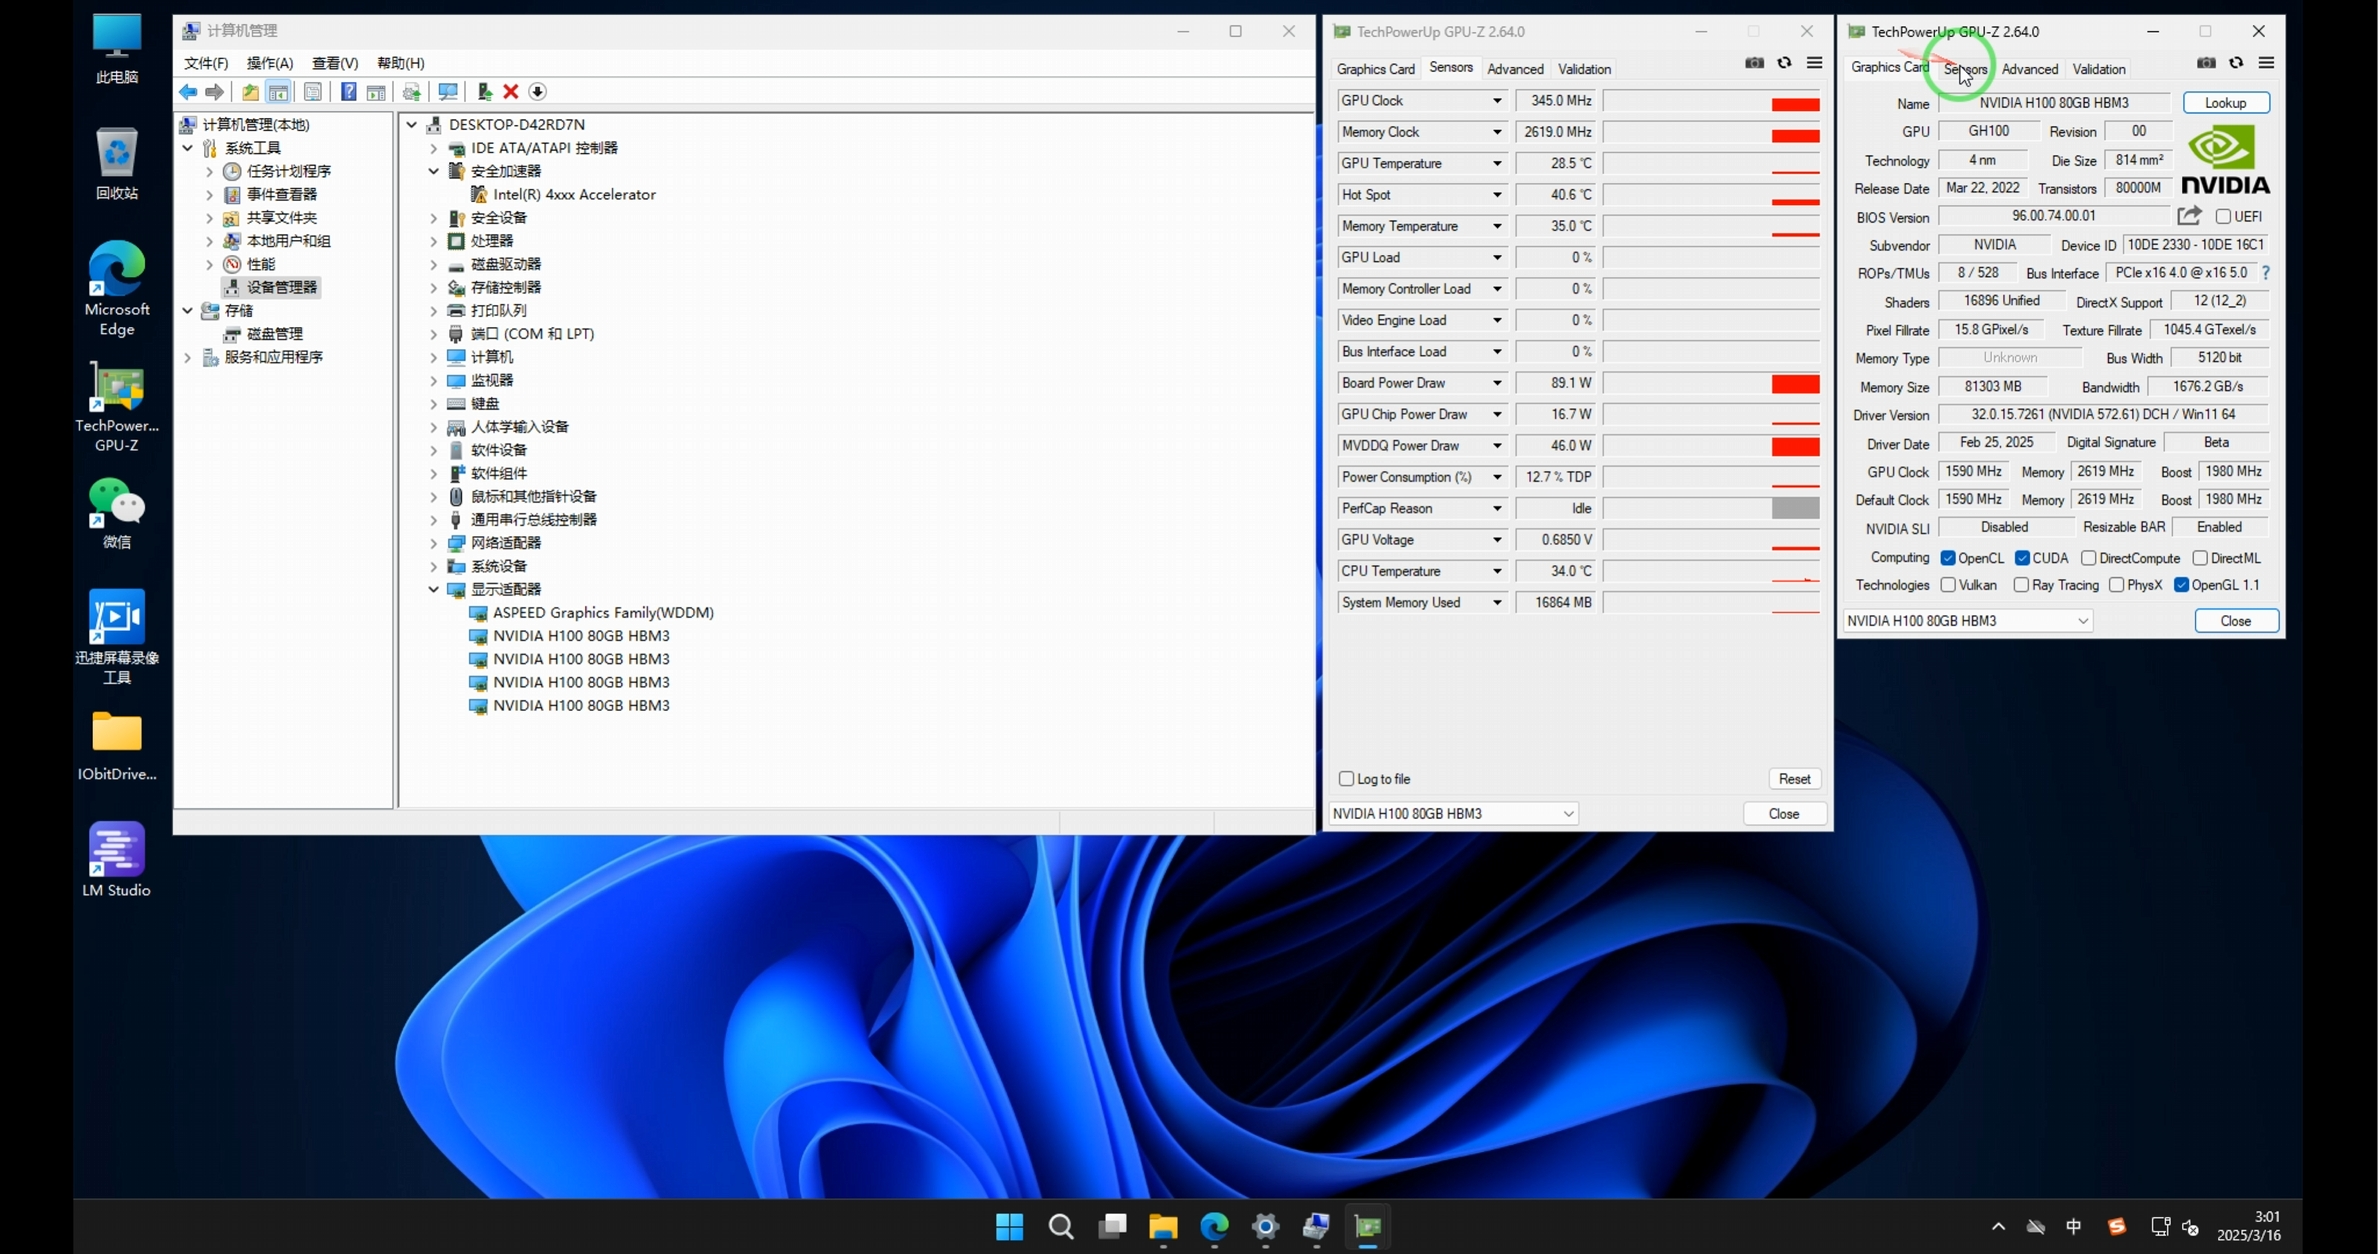
- 显卡:NVIDIA Tesla H100 80GB ×4
- 散热:技数犬定制360一体式水冷(CPU+四卡全覆盖)
- 电源:长城黑匣子3000W金牌全模组
- 机箱:Abee C1000w全塔滑轮工作站
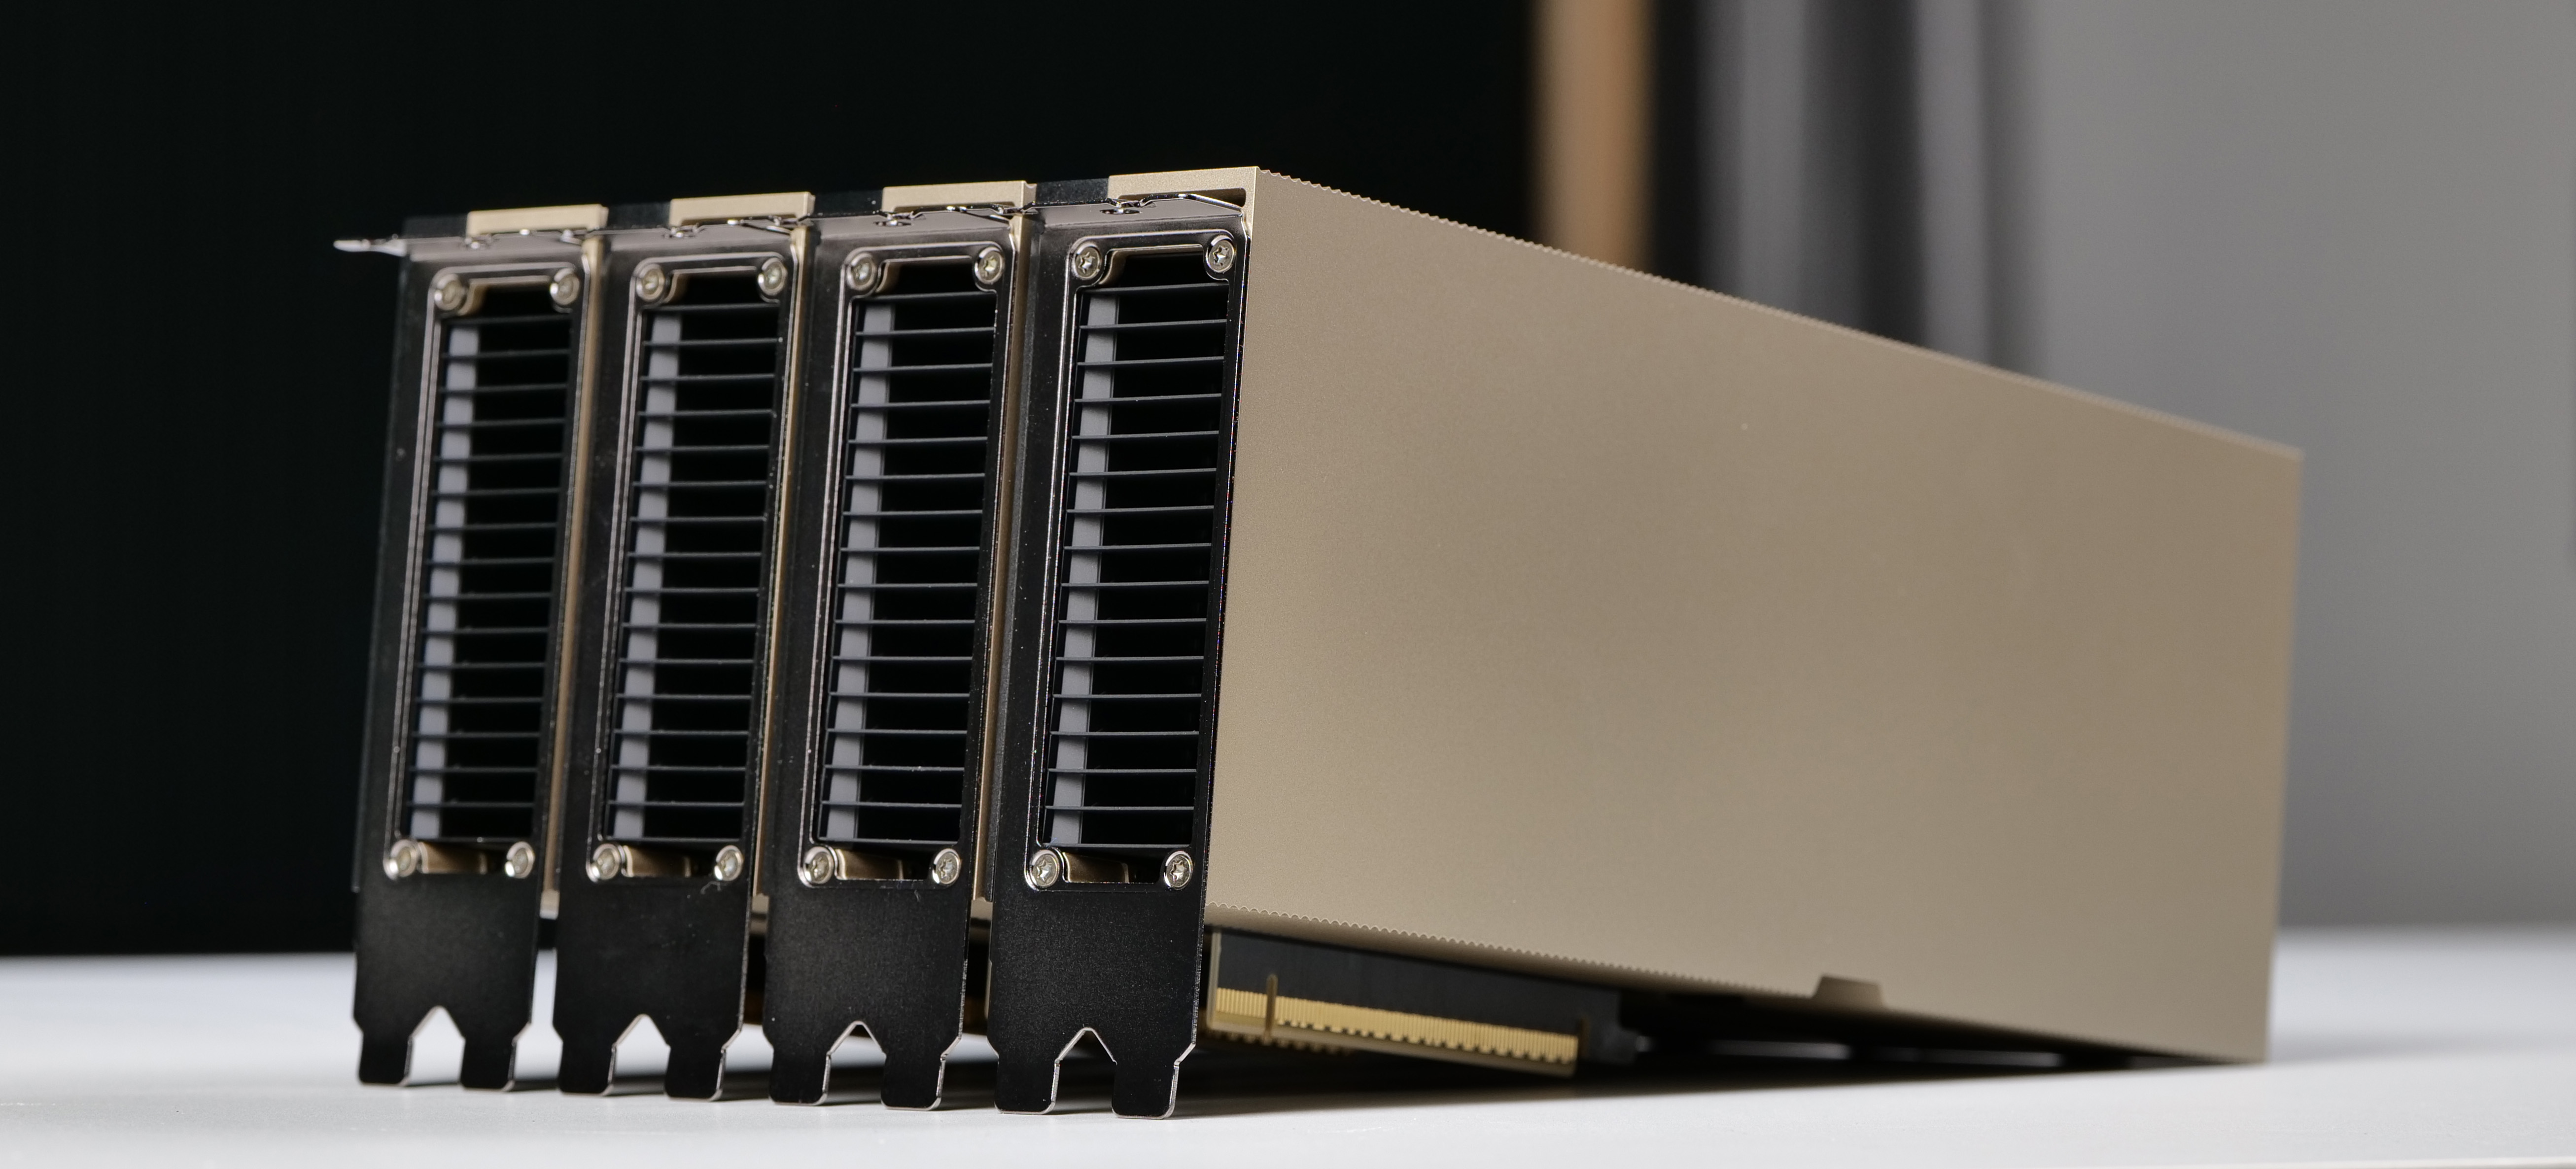
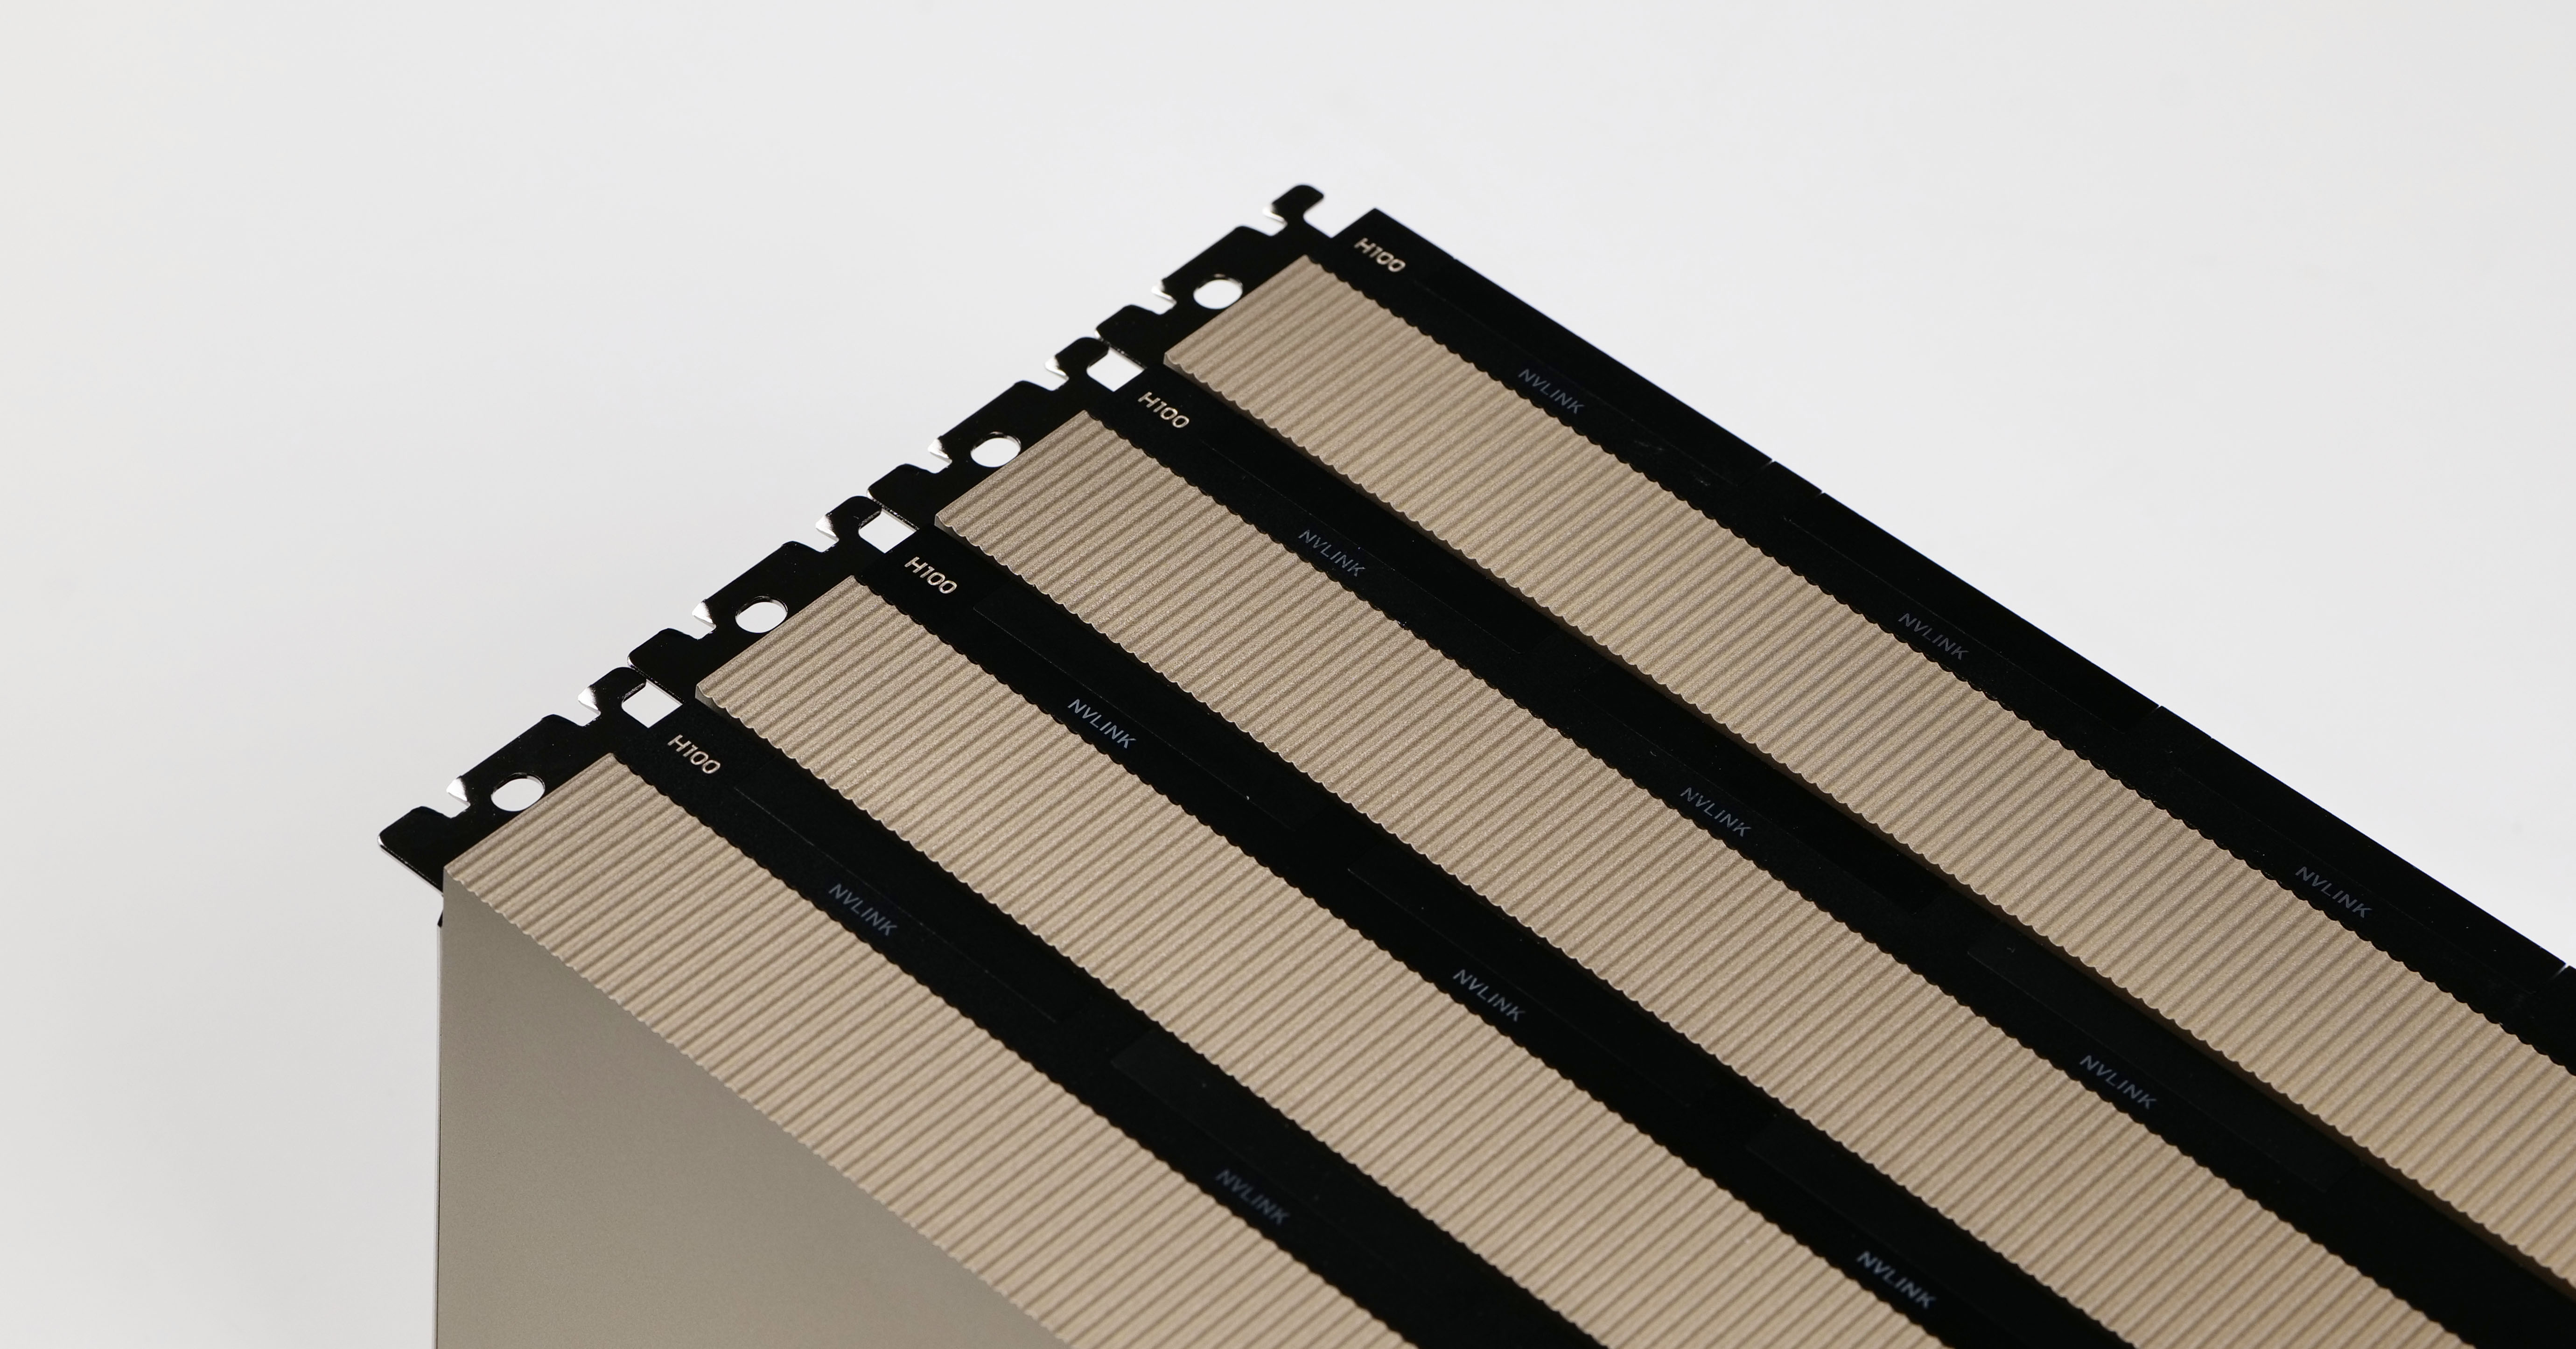
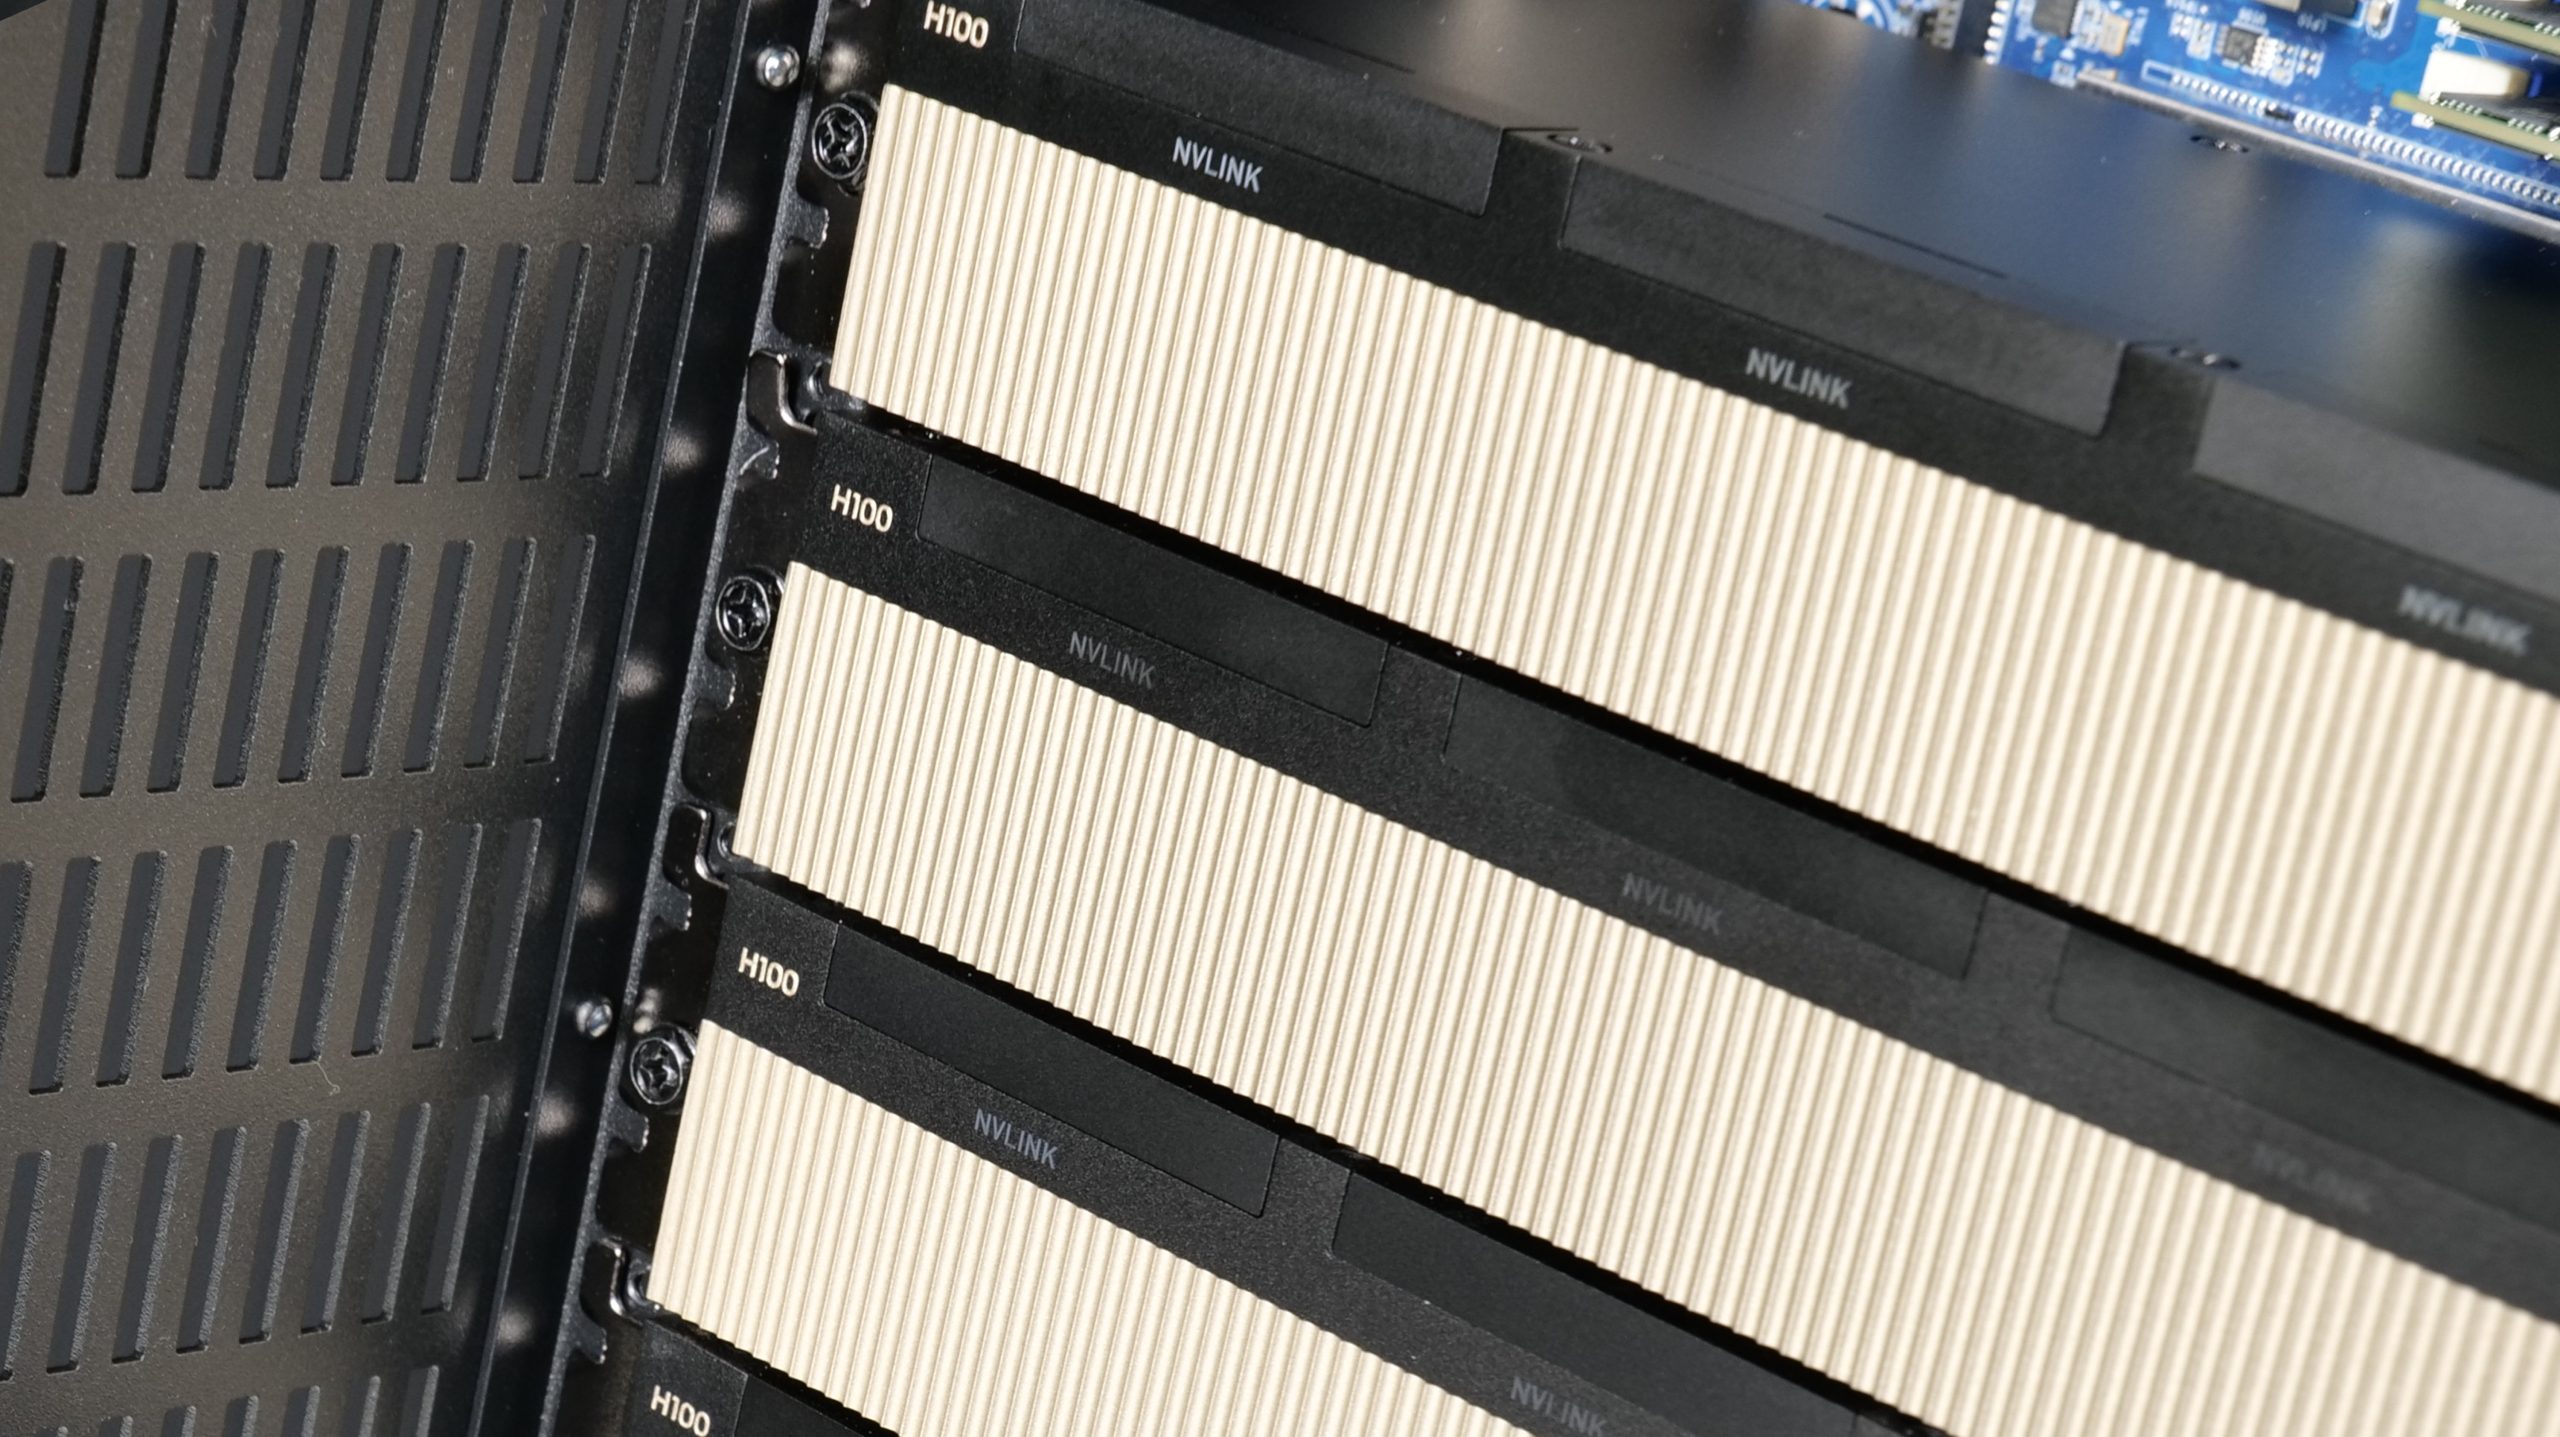
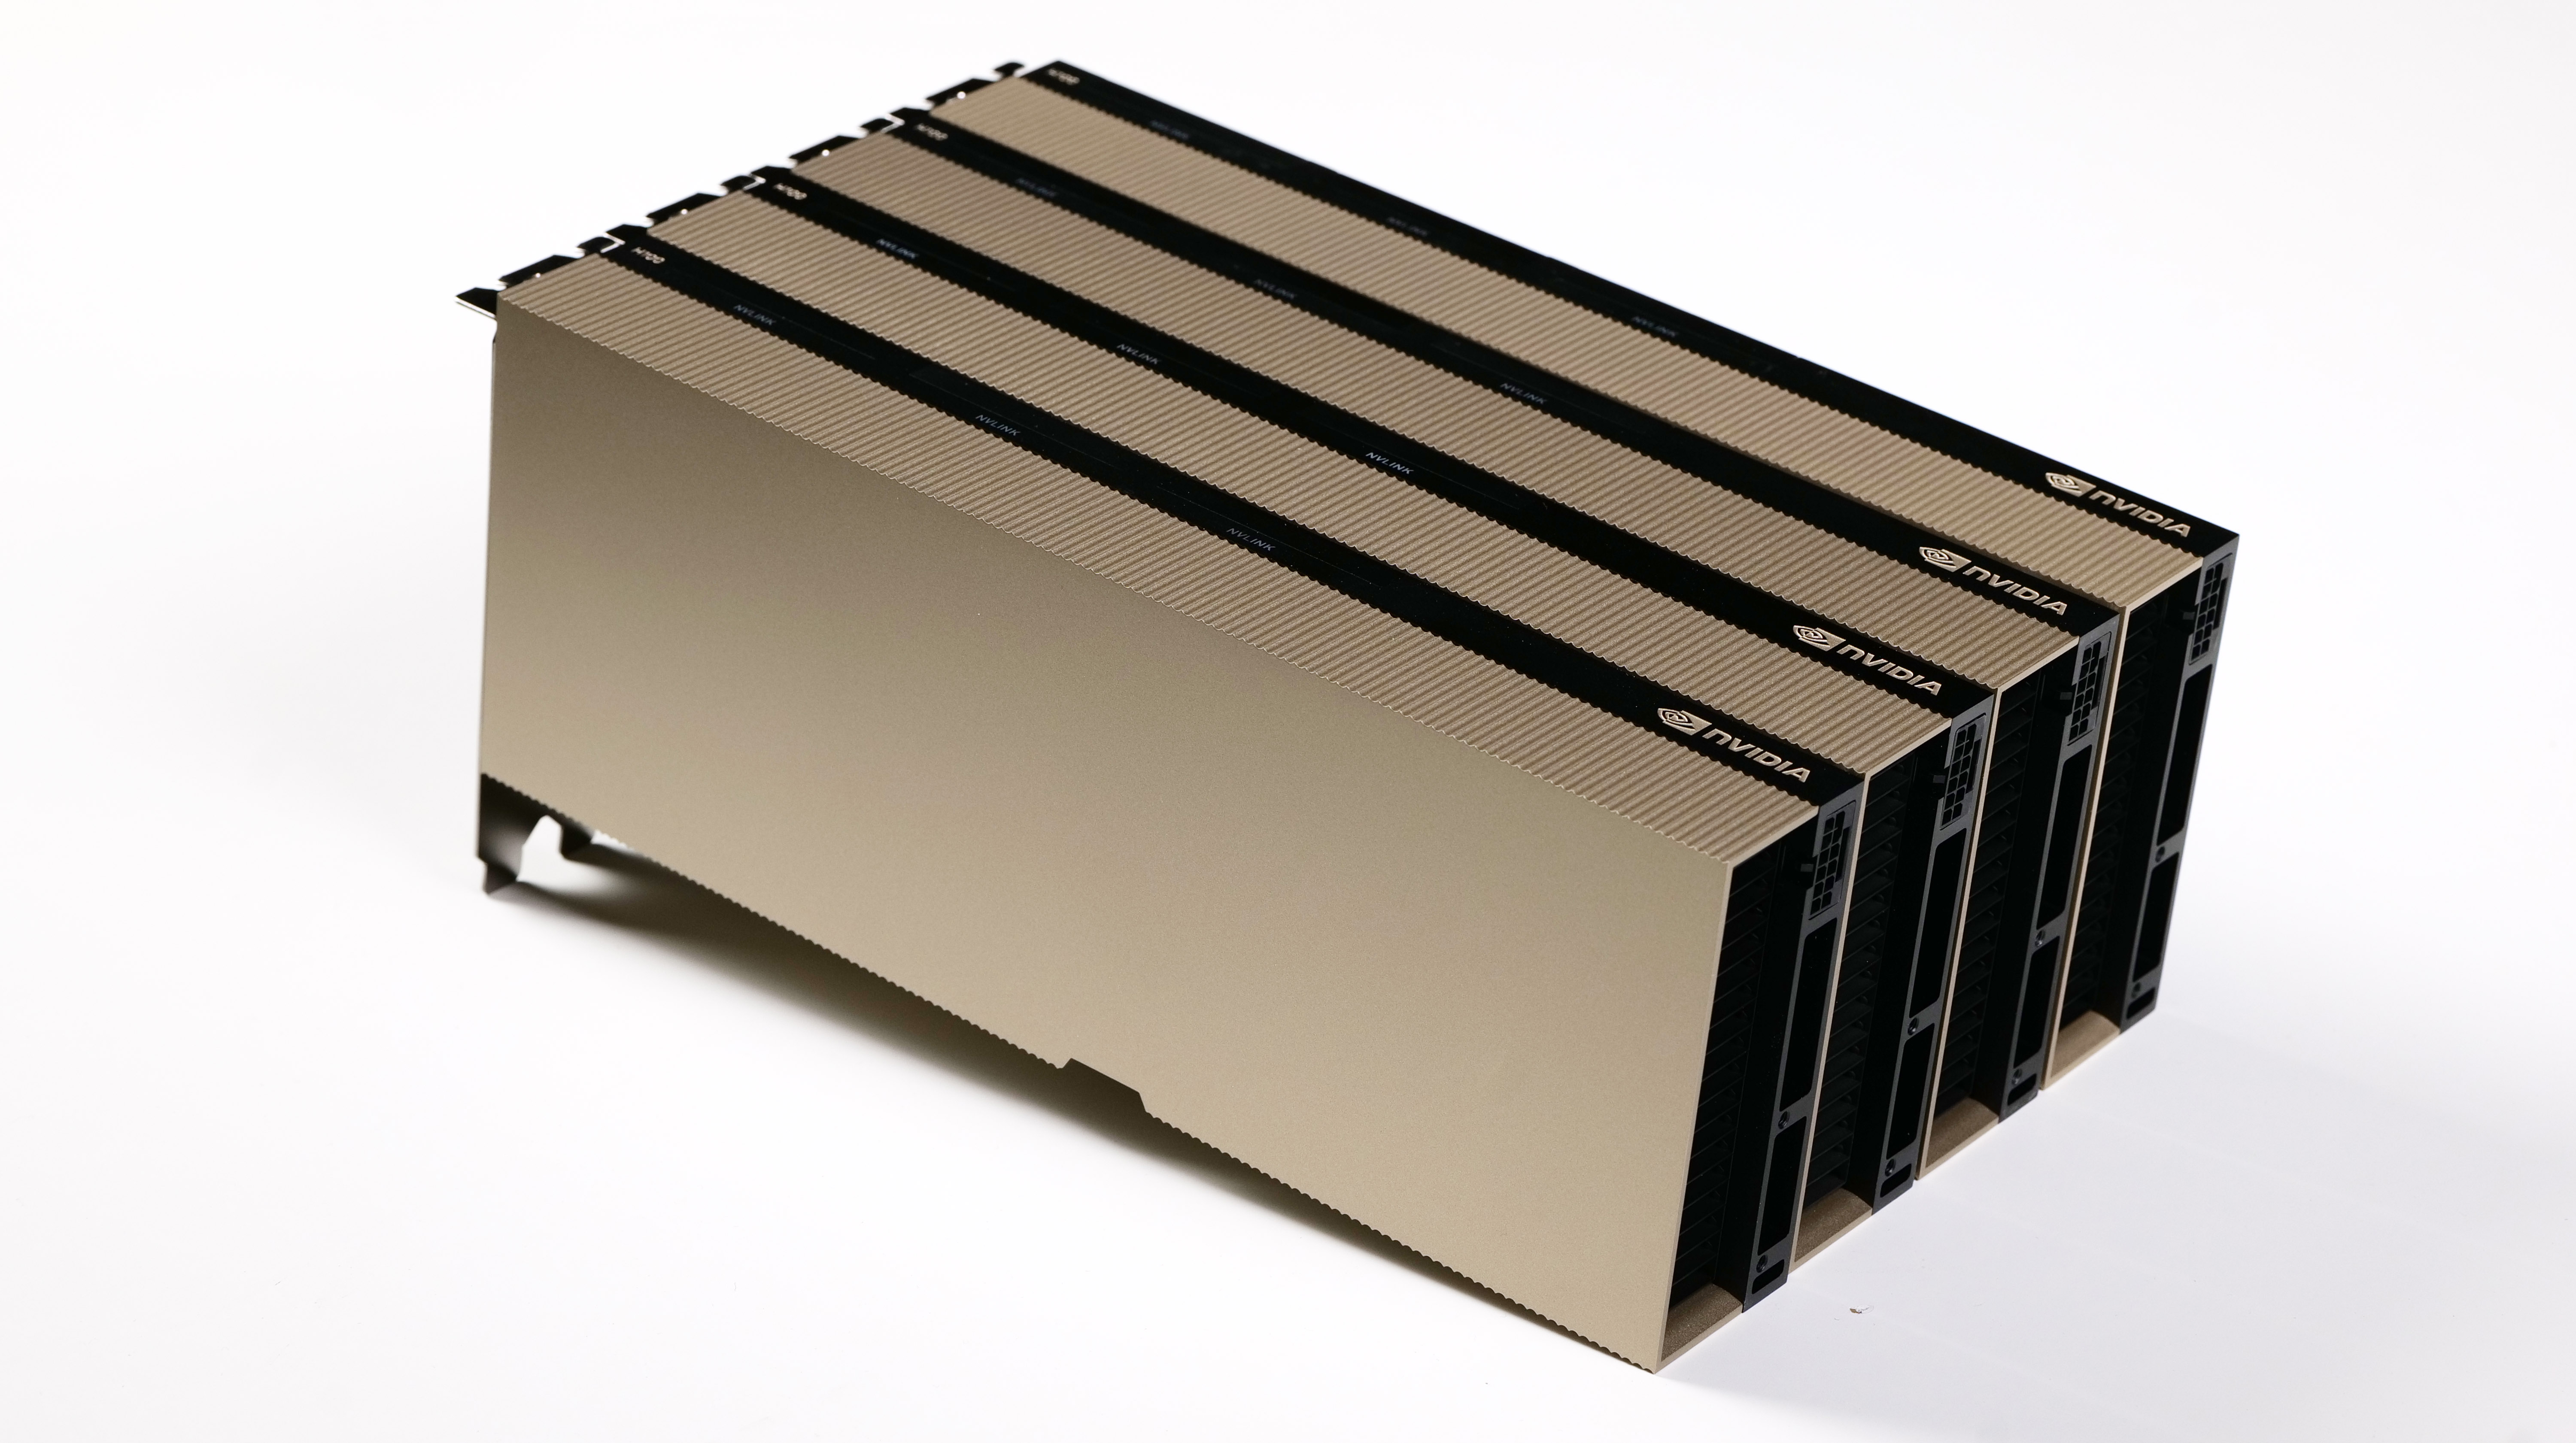
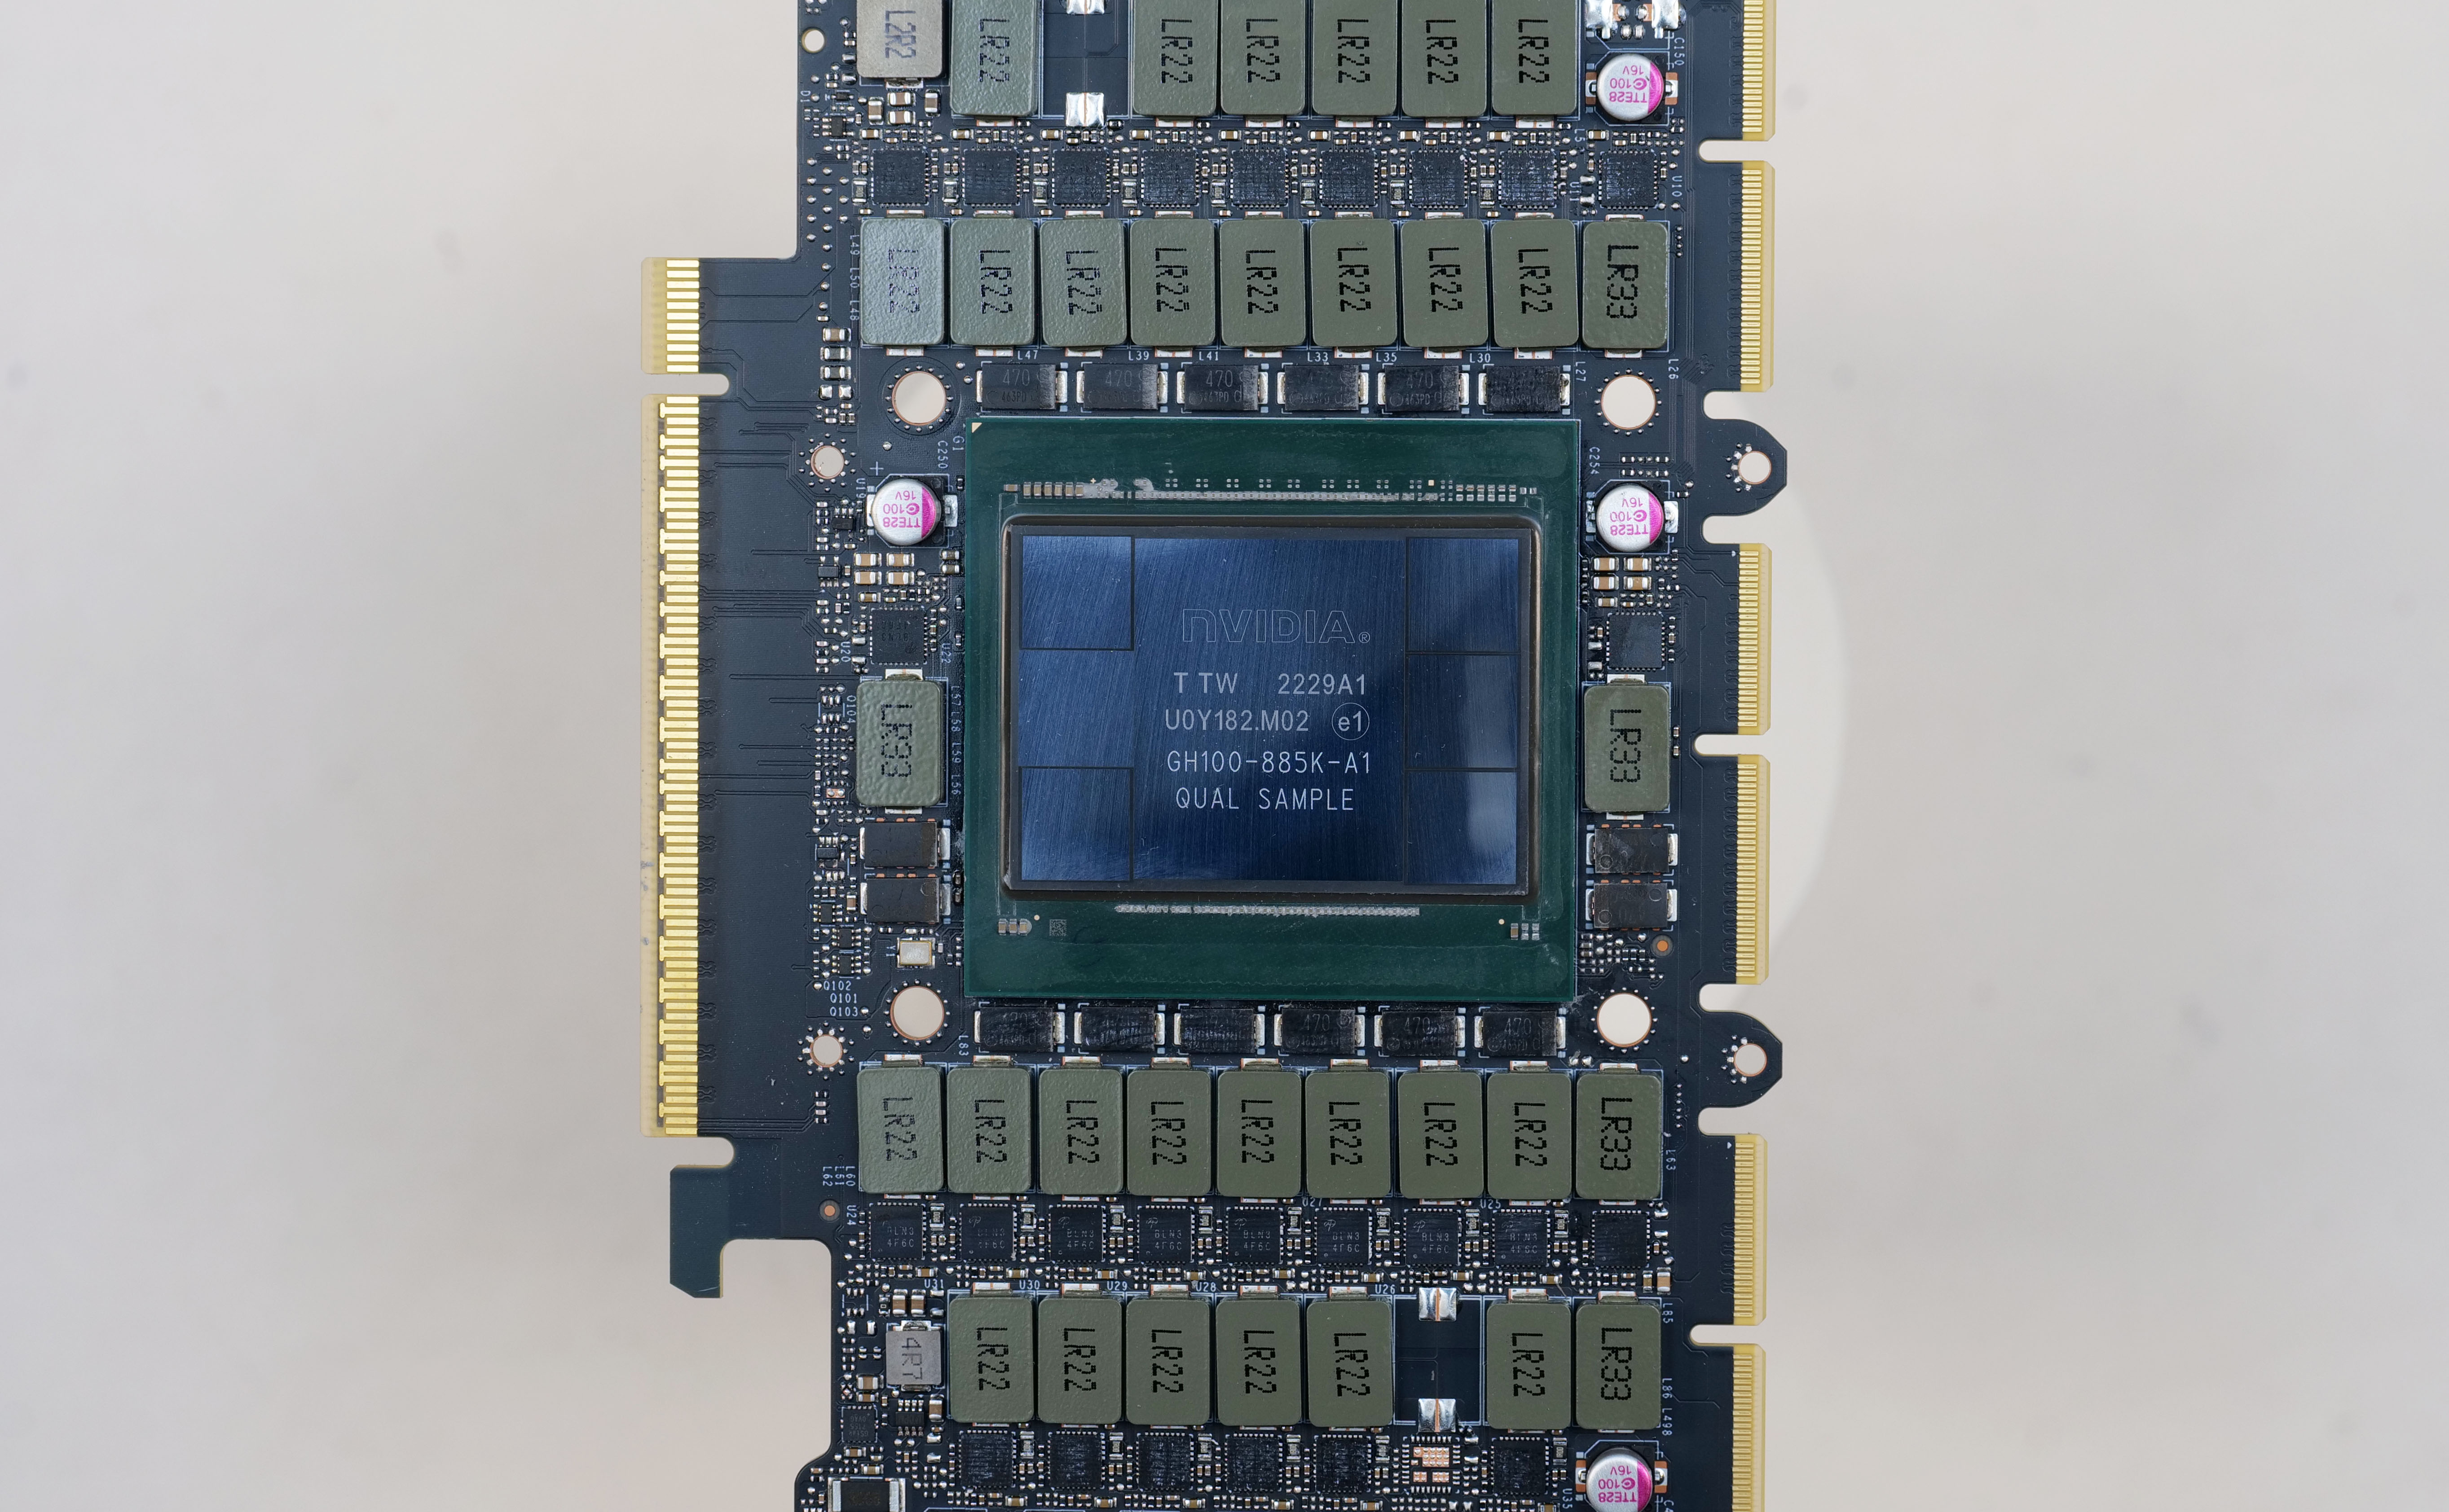
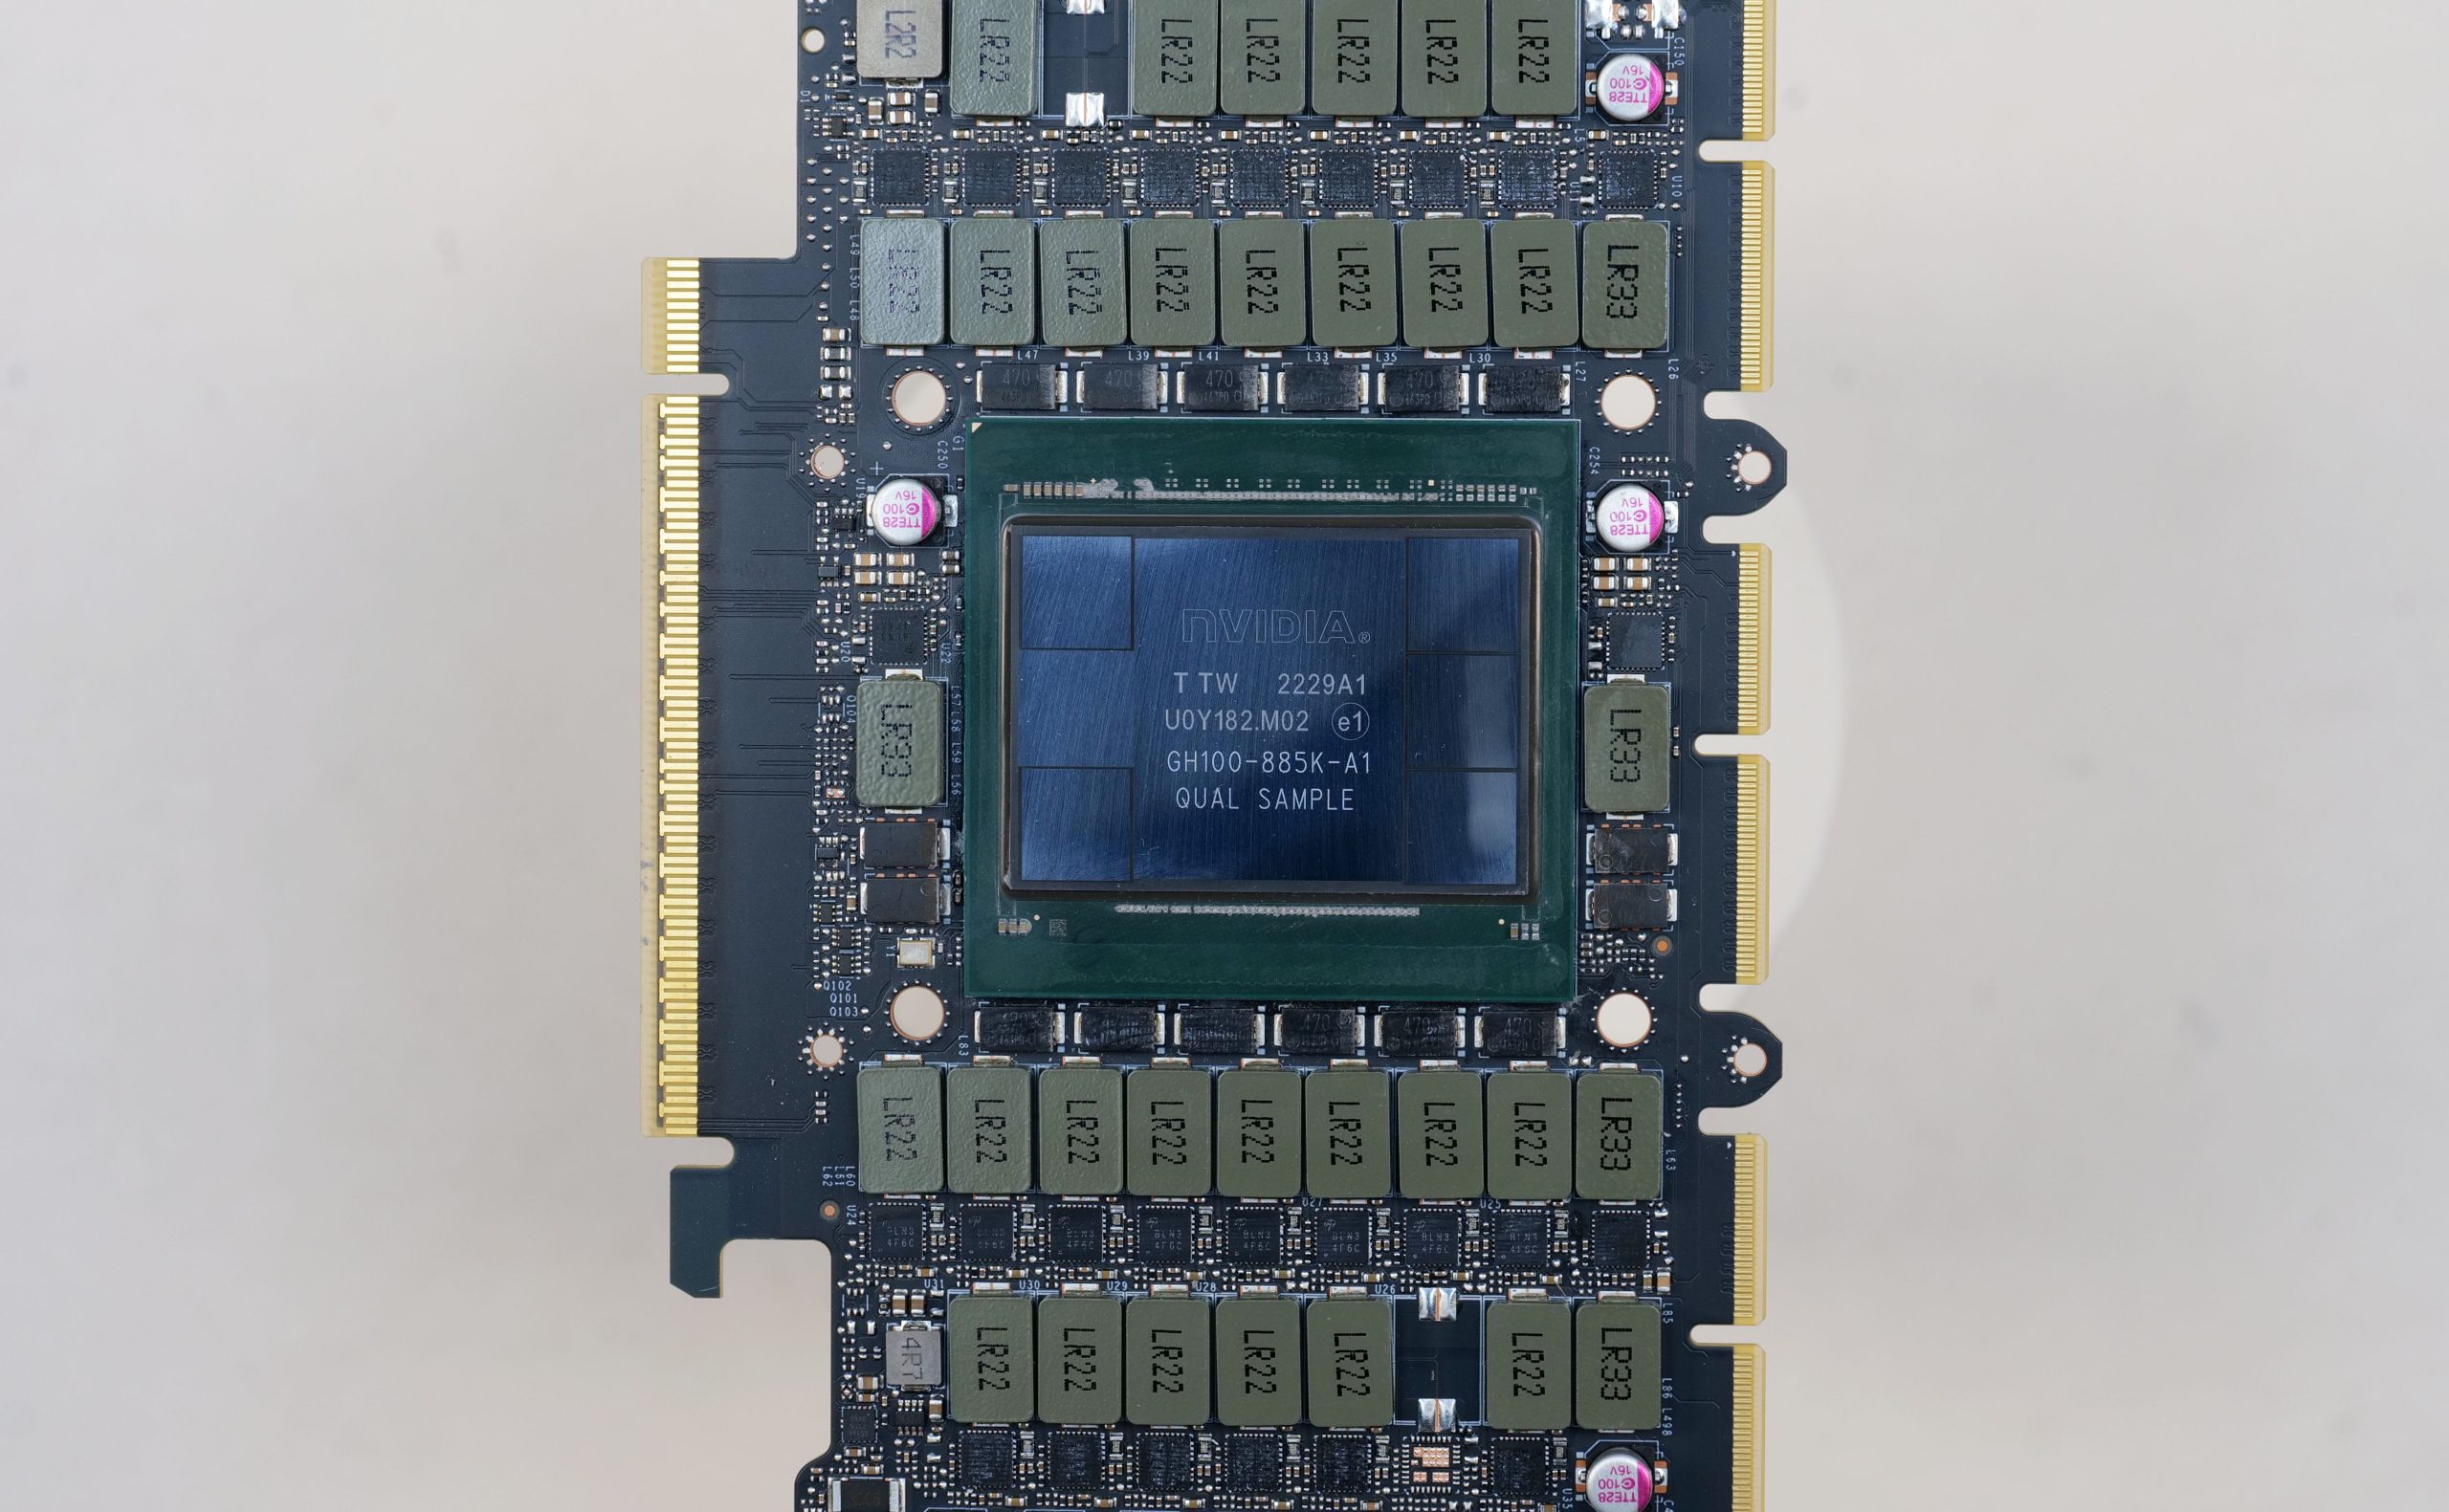
看到这配置单,懂行的兄弟已经倒吸一口凉气了。四张H100 PCIe版,每张都是800亿晶体管、814平方毫米核心面积的怪物,台积电5nm工艺,单卡就拥有16896个CUDA核心和80GB HBM2e显存,显存带宽高达2.04TB/s。四张卡加起来,那就是320GB显存、8TB/s带宽的恐怖存在!
技术参数?用大白话给你翻译翻译
我知道你们看到FP64、Tensor Core这些词就头大。别急,我给你翻译成人话:
- FP32单精度浮点性能60TeraFLOPS:相当于每秒进行60万亿次计算,打个比方,你手动算一道微积分需要10分钟,它一秒钟能算完地球上所有人一辈子都算不完的题。
- BFLOAT16 Tensor Core性能1671TeraFLOPS:这是AI训练的黄金精度,1671万亿次/秒,训练大模型就像开了16倍速播放。
- INT8 Tensor Core性能3341TOPS:推理加速神器,跑AI应用时响应速度飞快。
最离谱的是,这四张卡还支持两两NVLink互联,数据传输速度直接拉满。在70B FP16级别的模型部署上,这已经是个人玩家的天花板了!
实测体验:671B模型说跑就跑
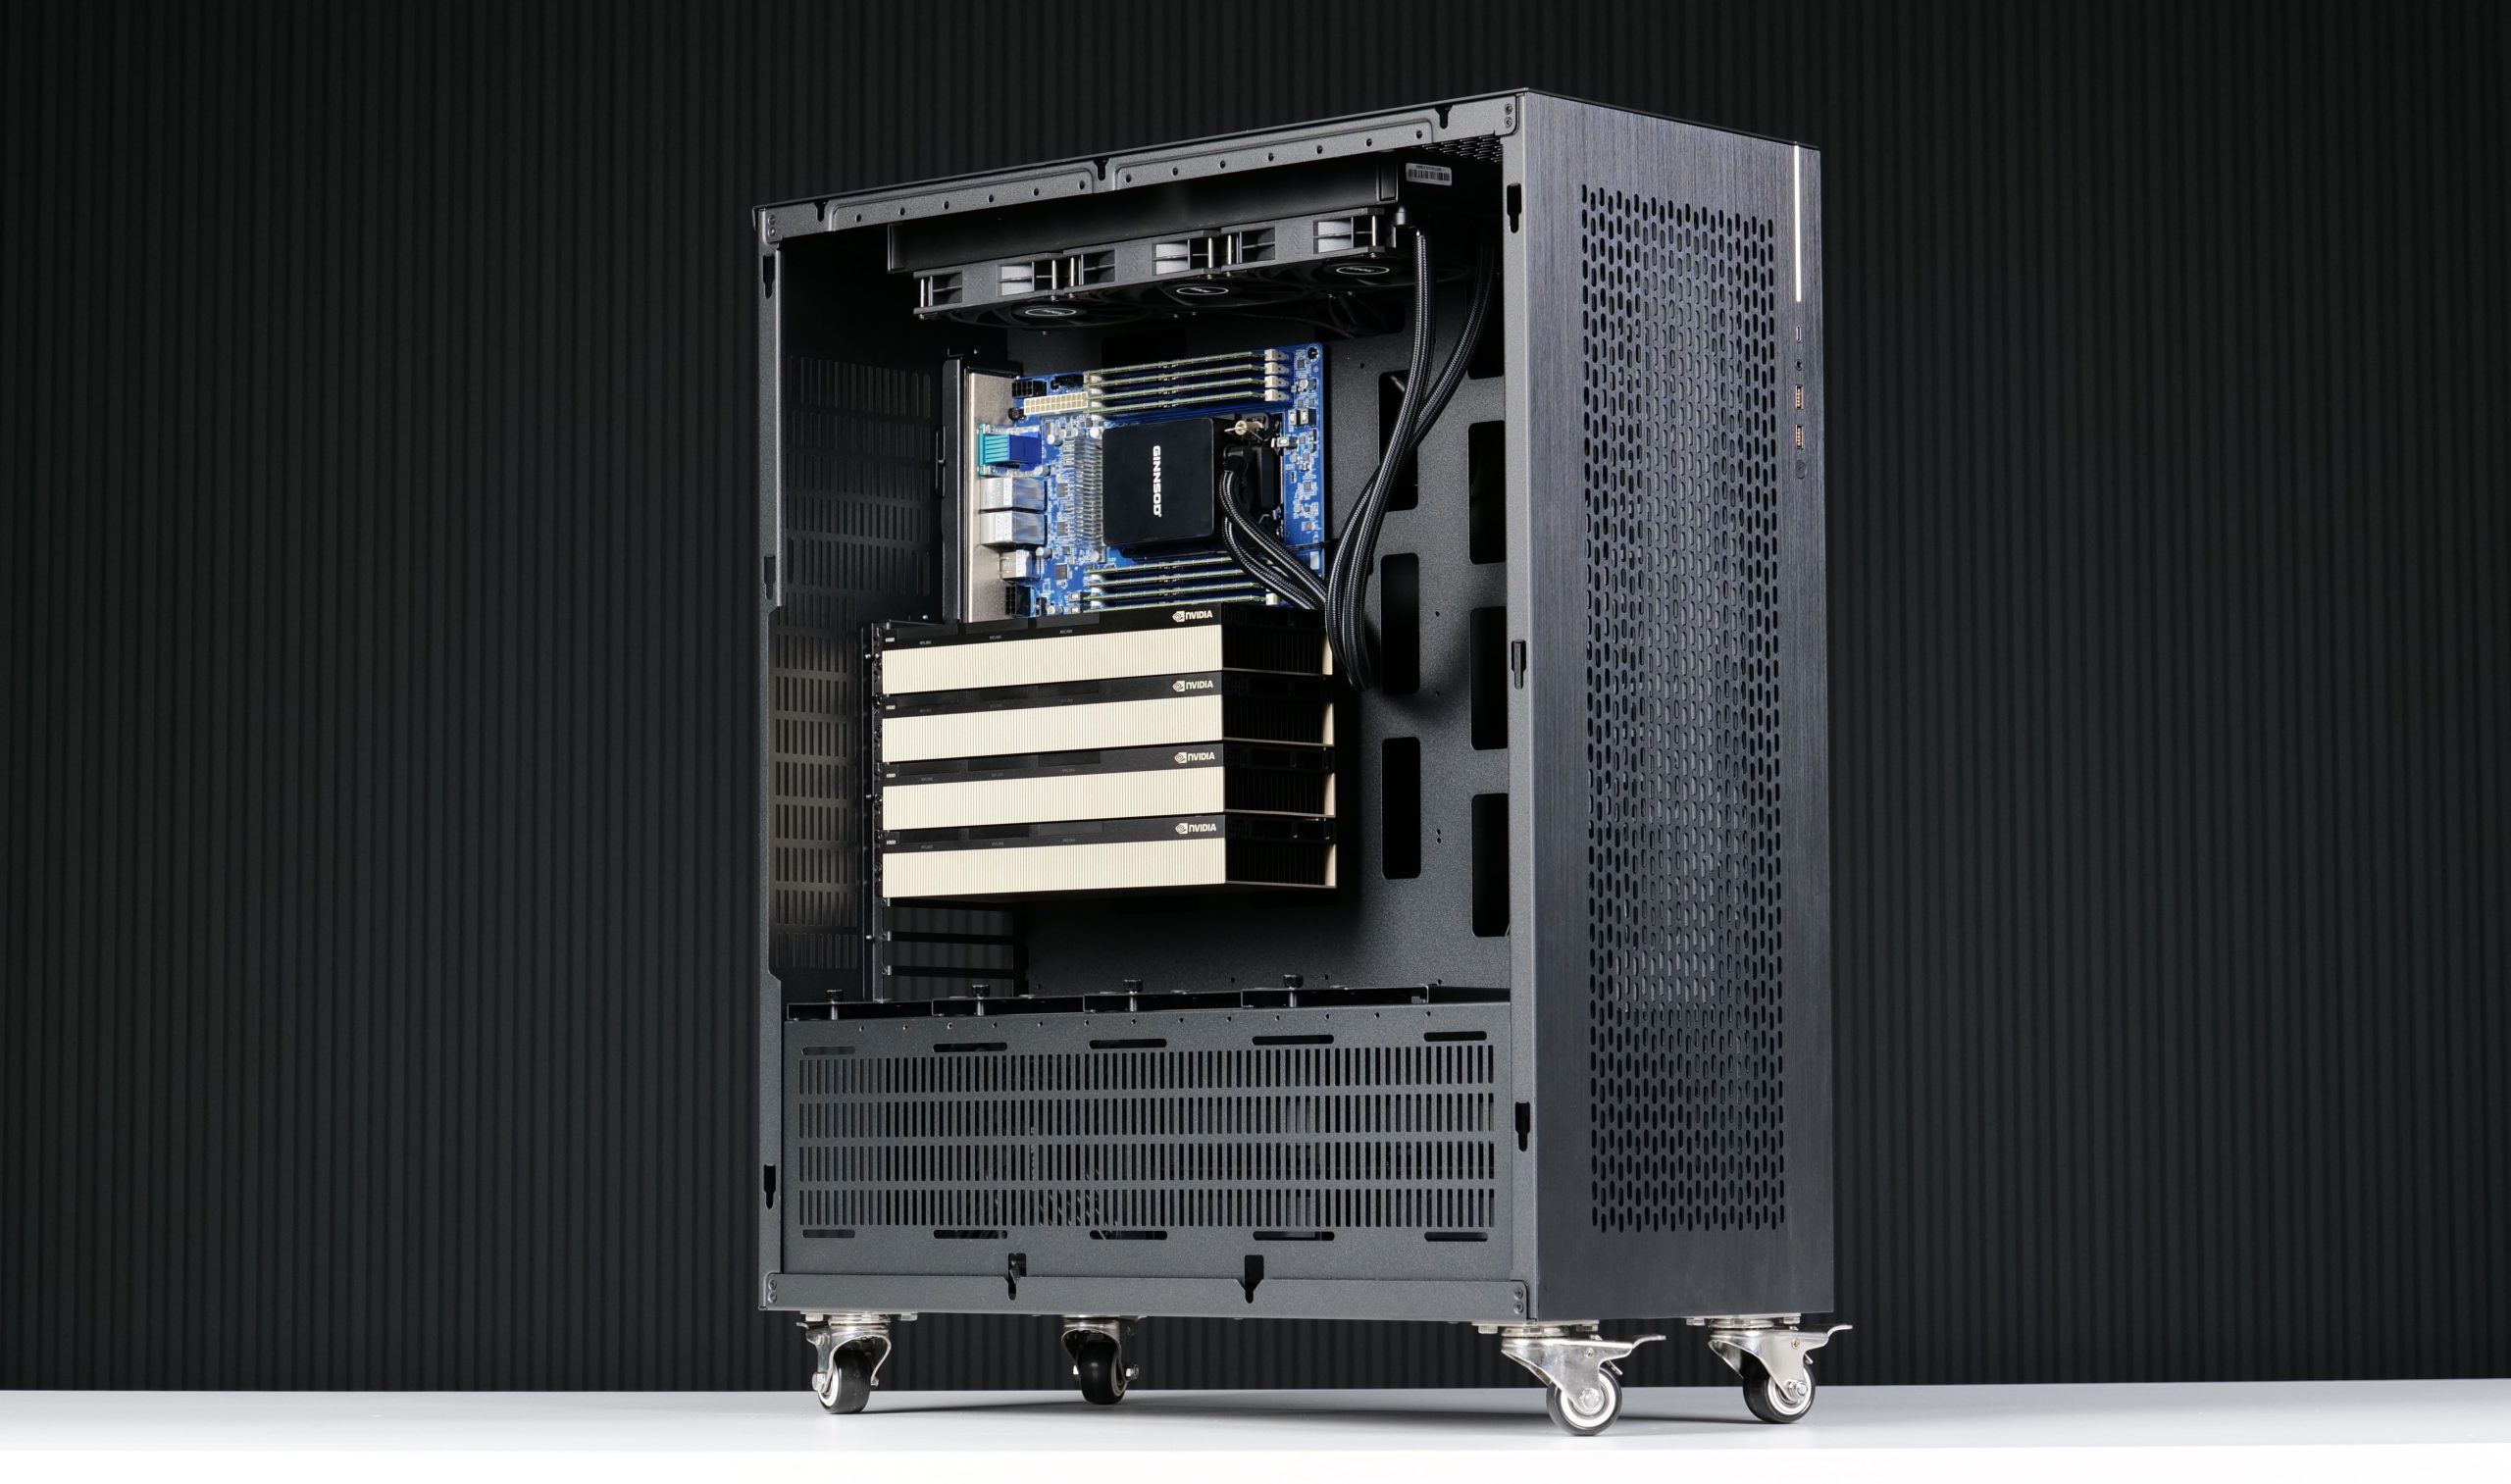
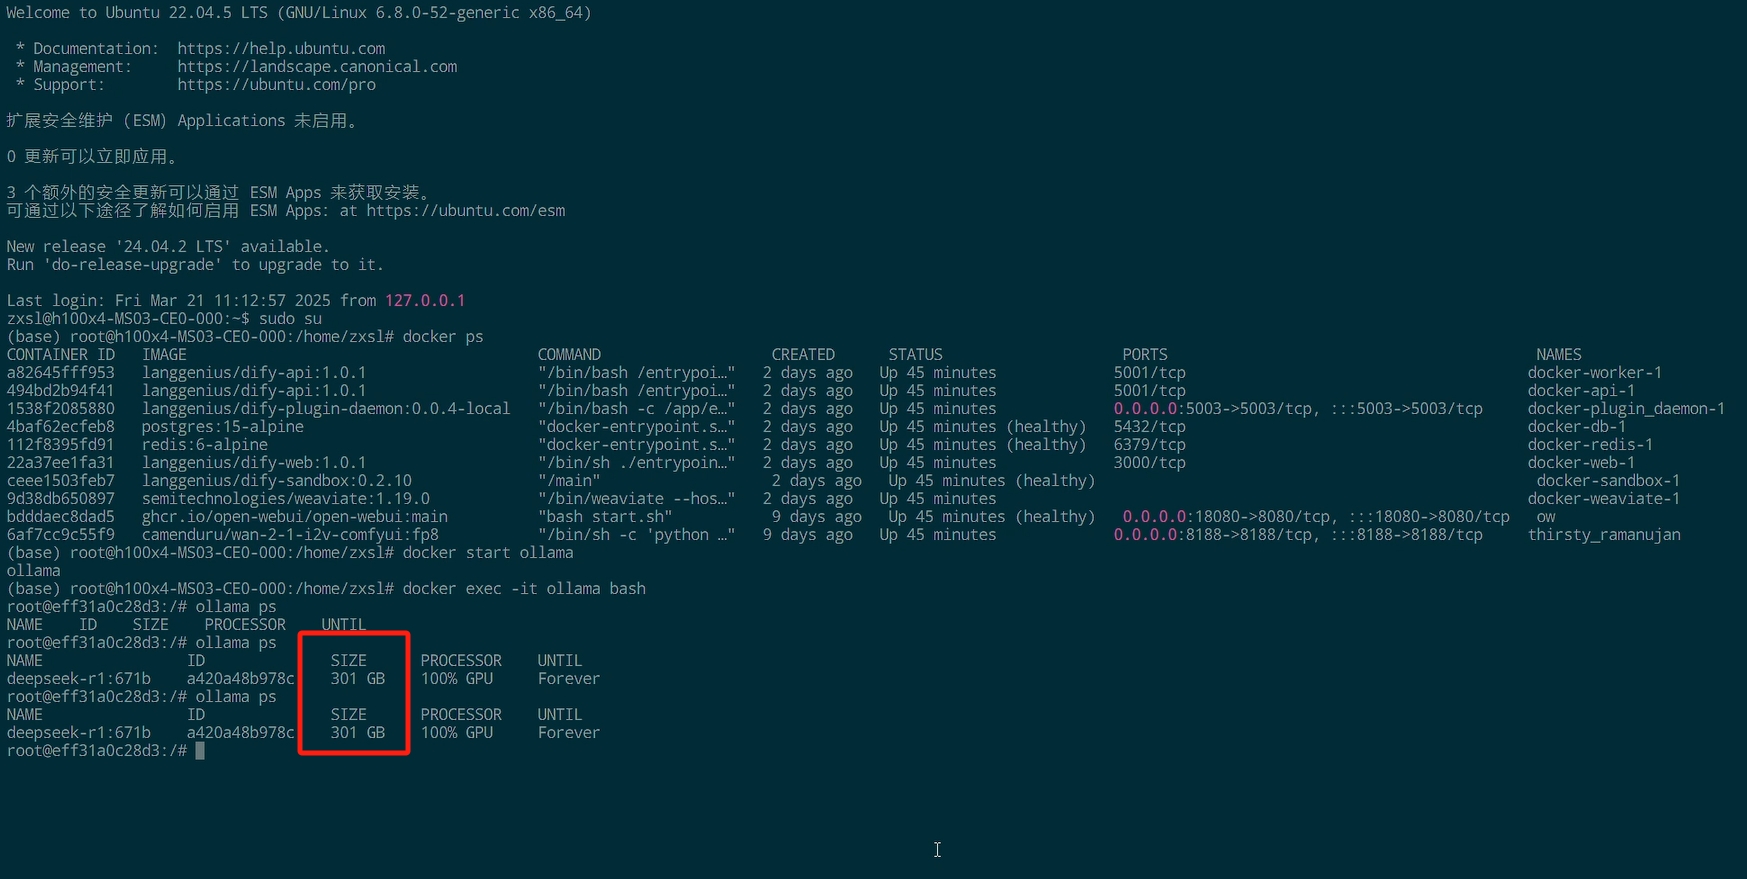
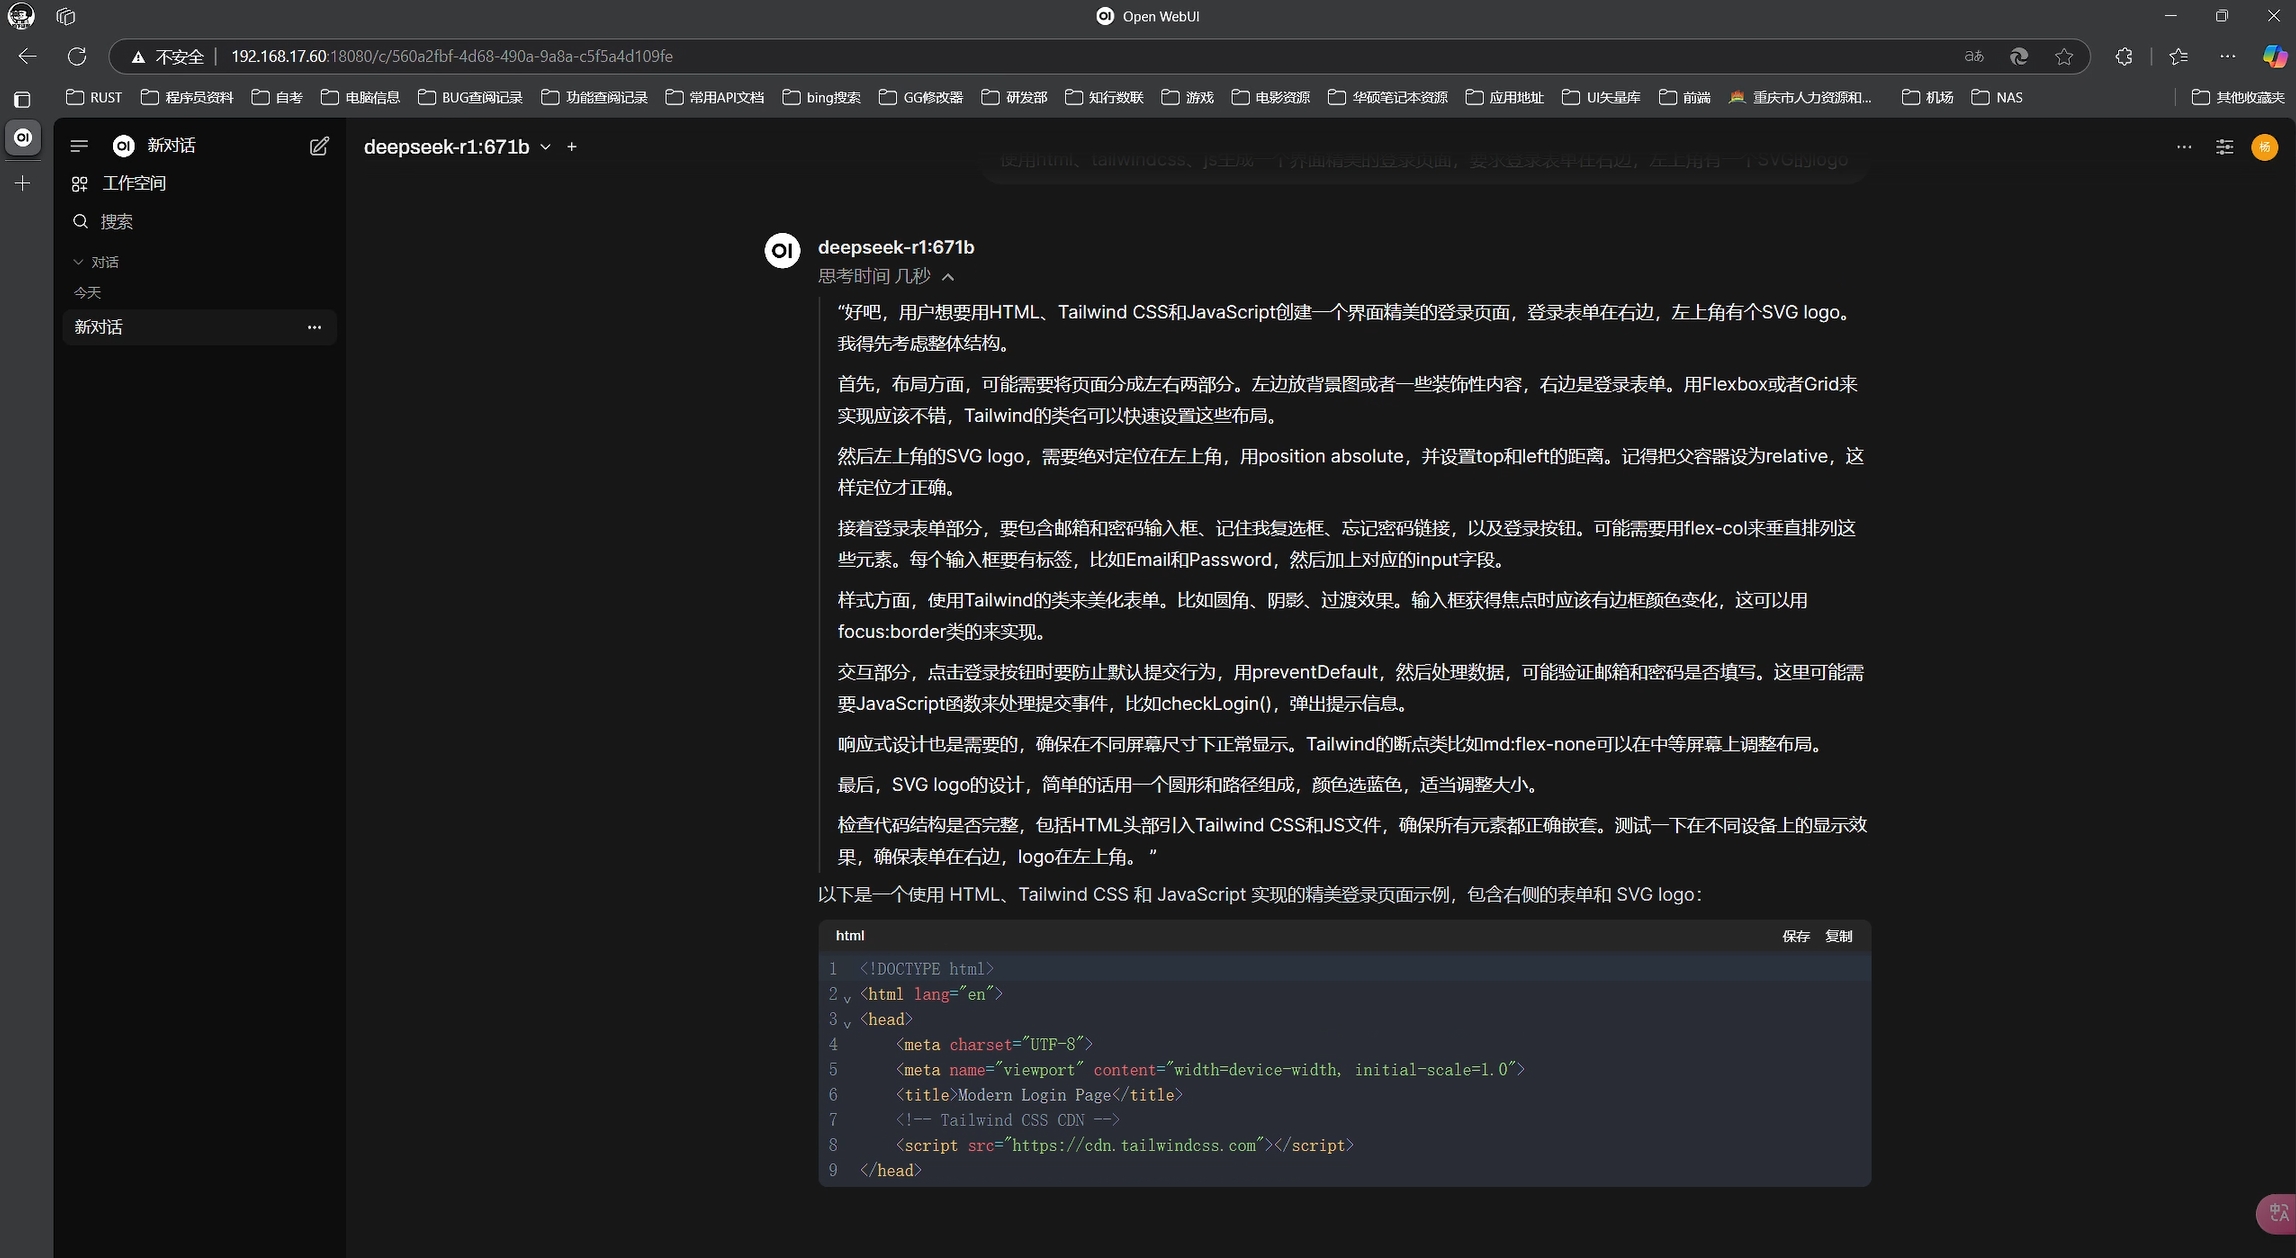
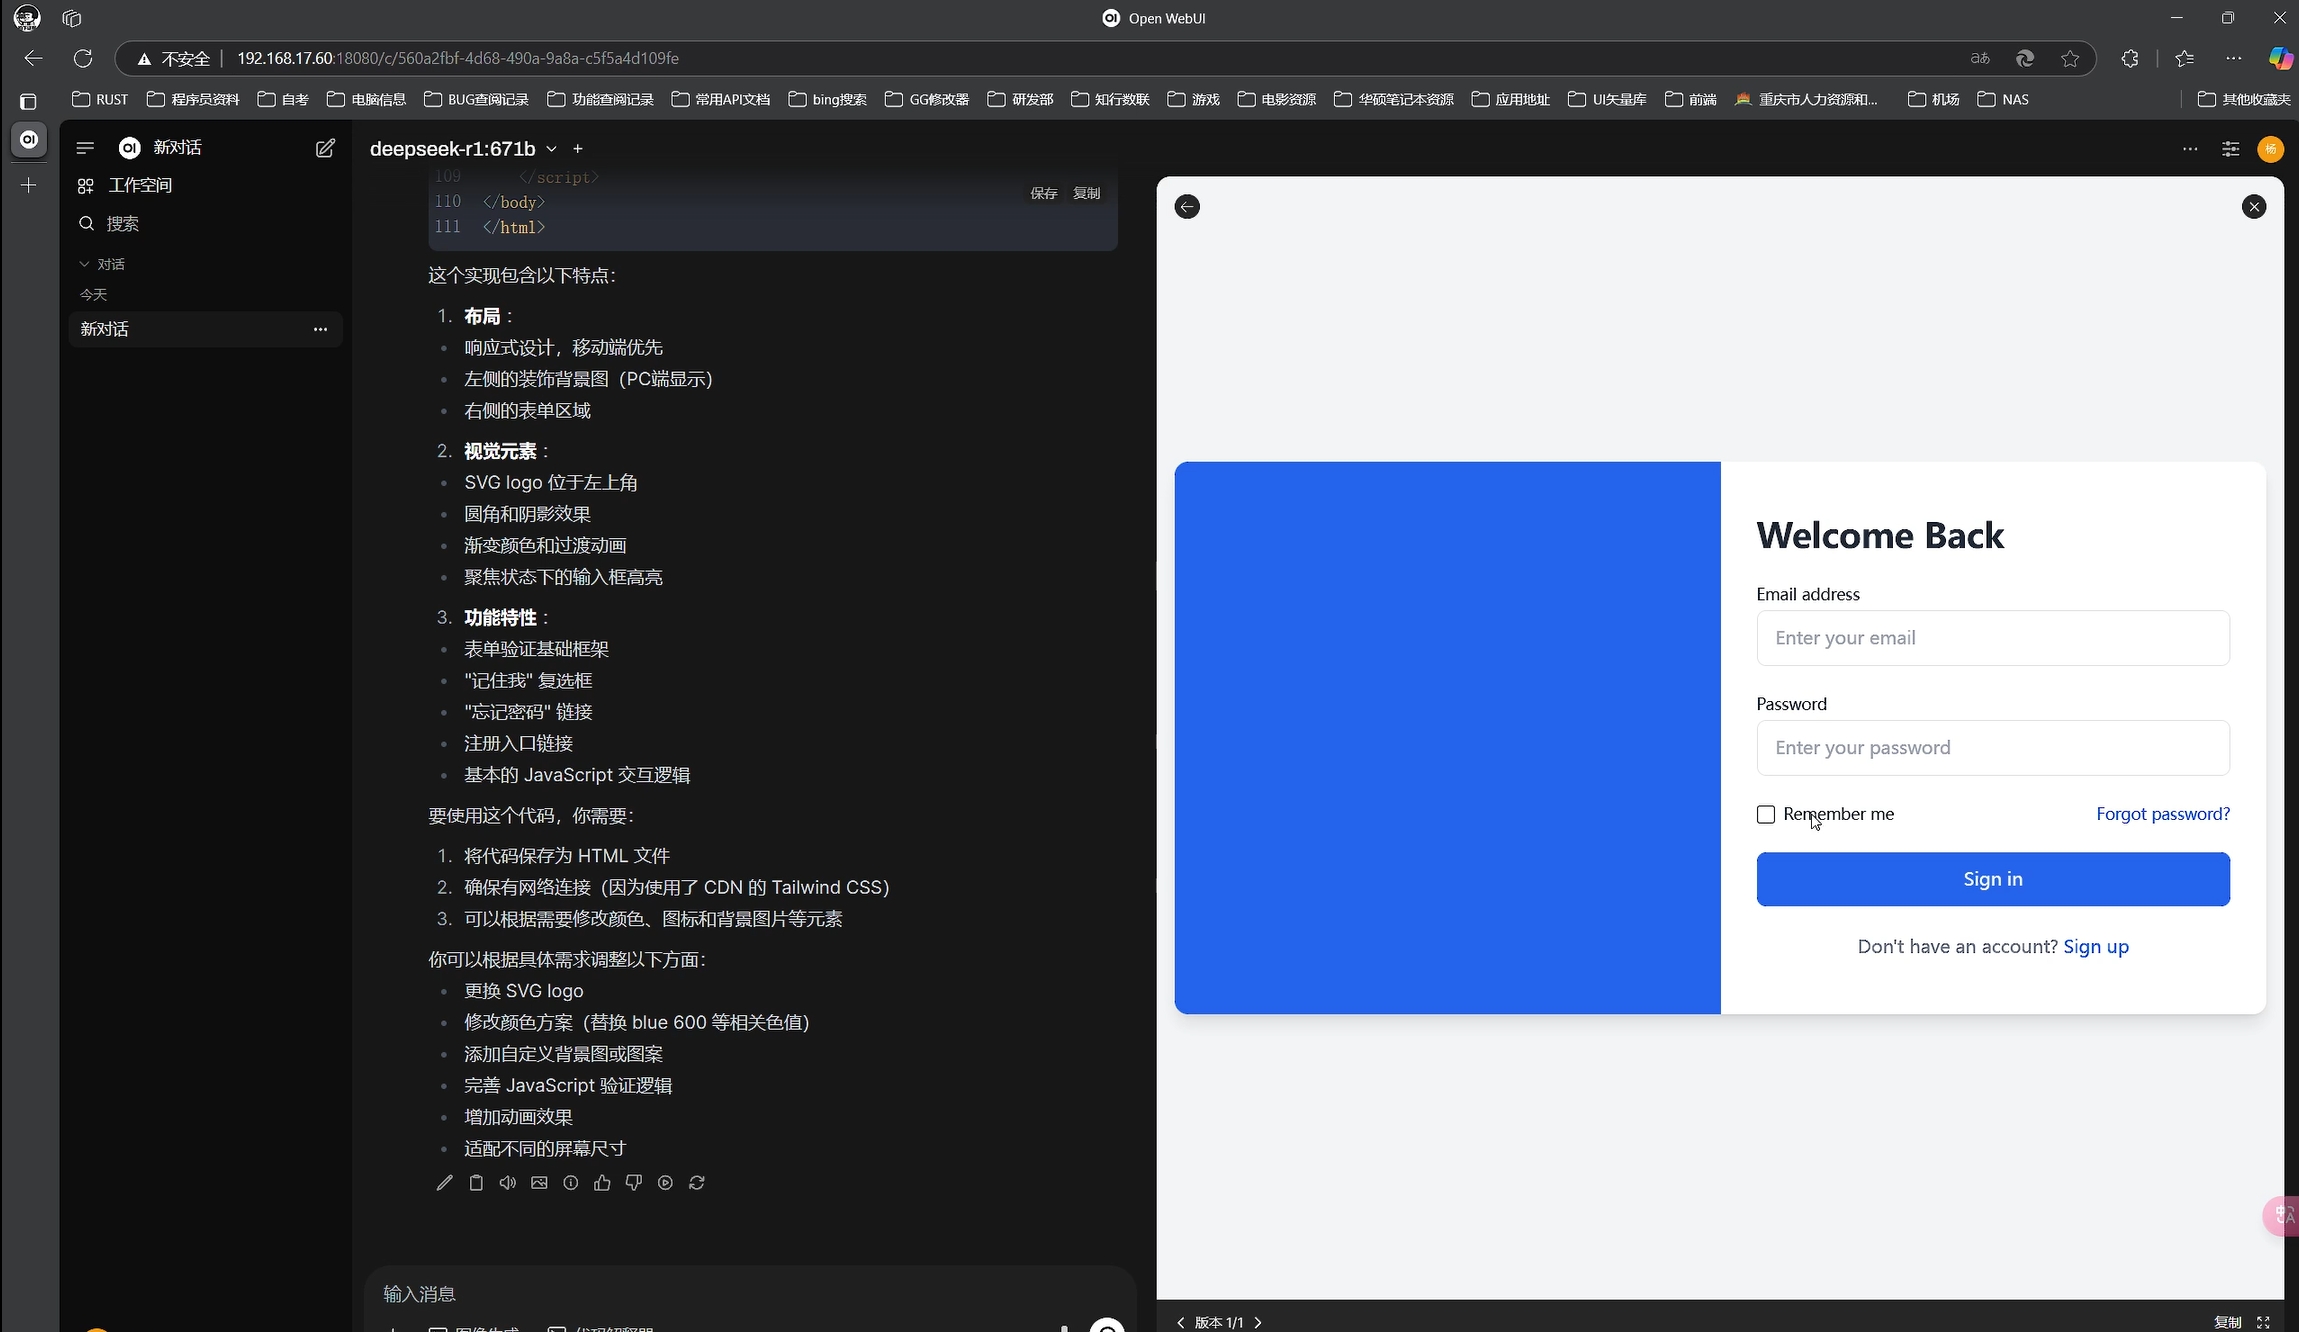
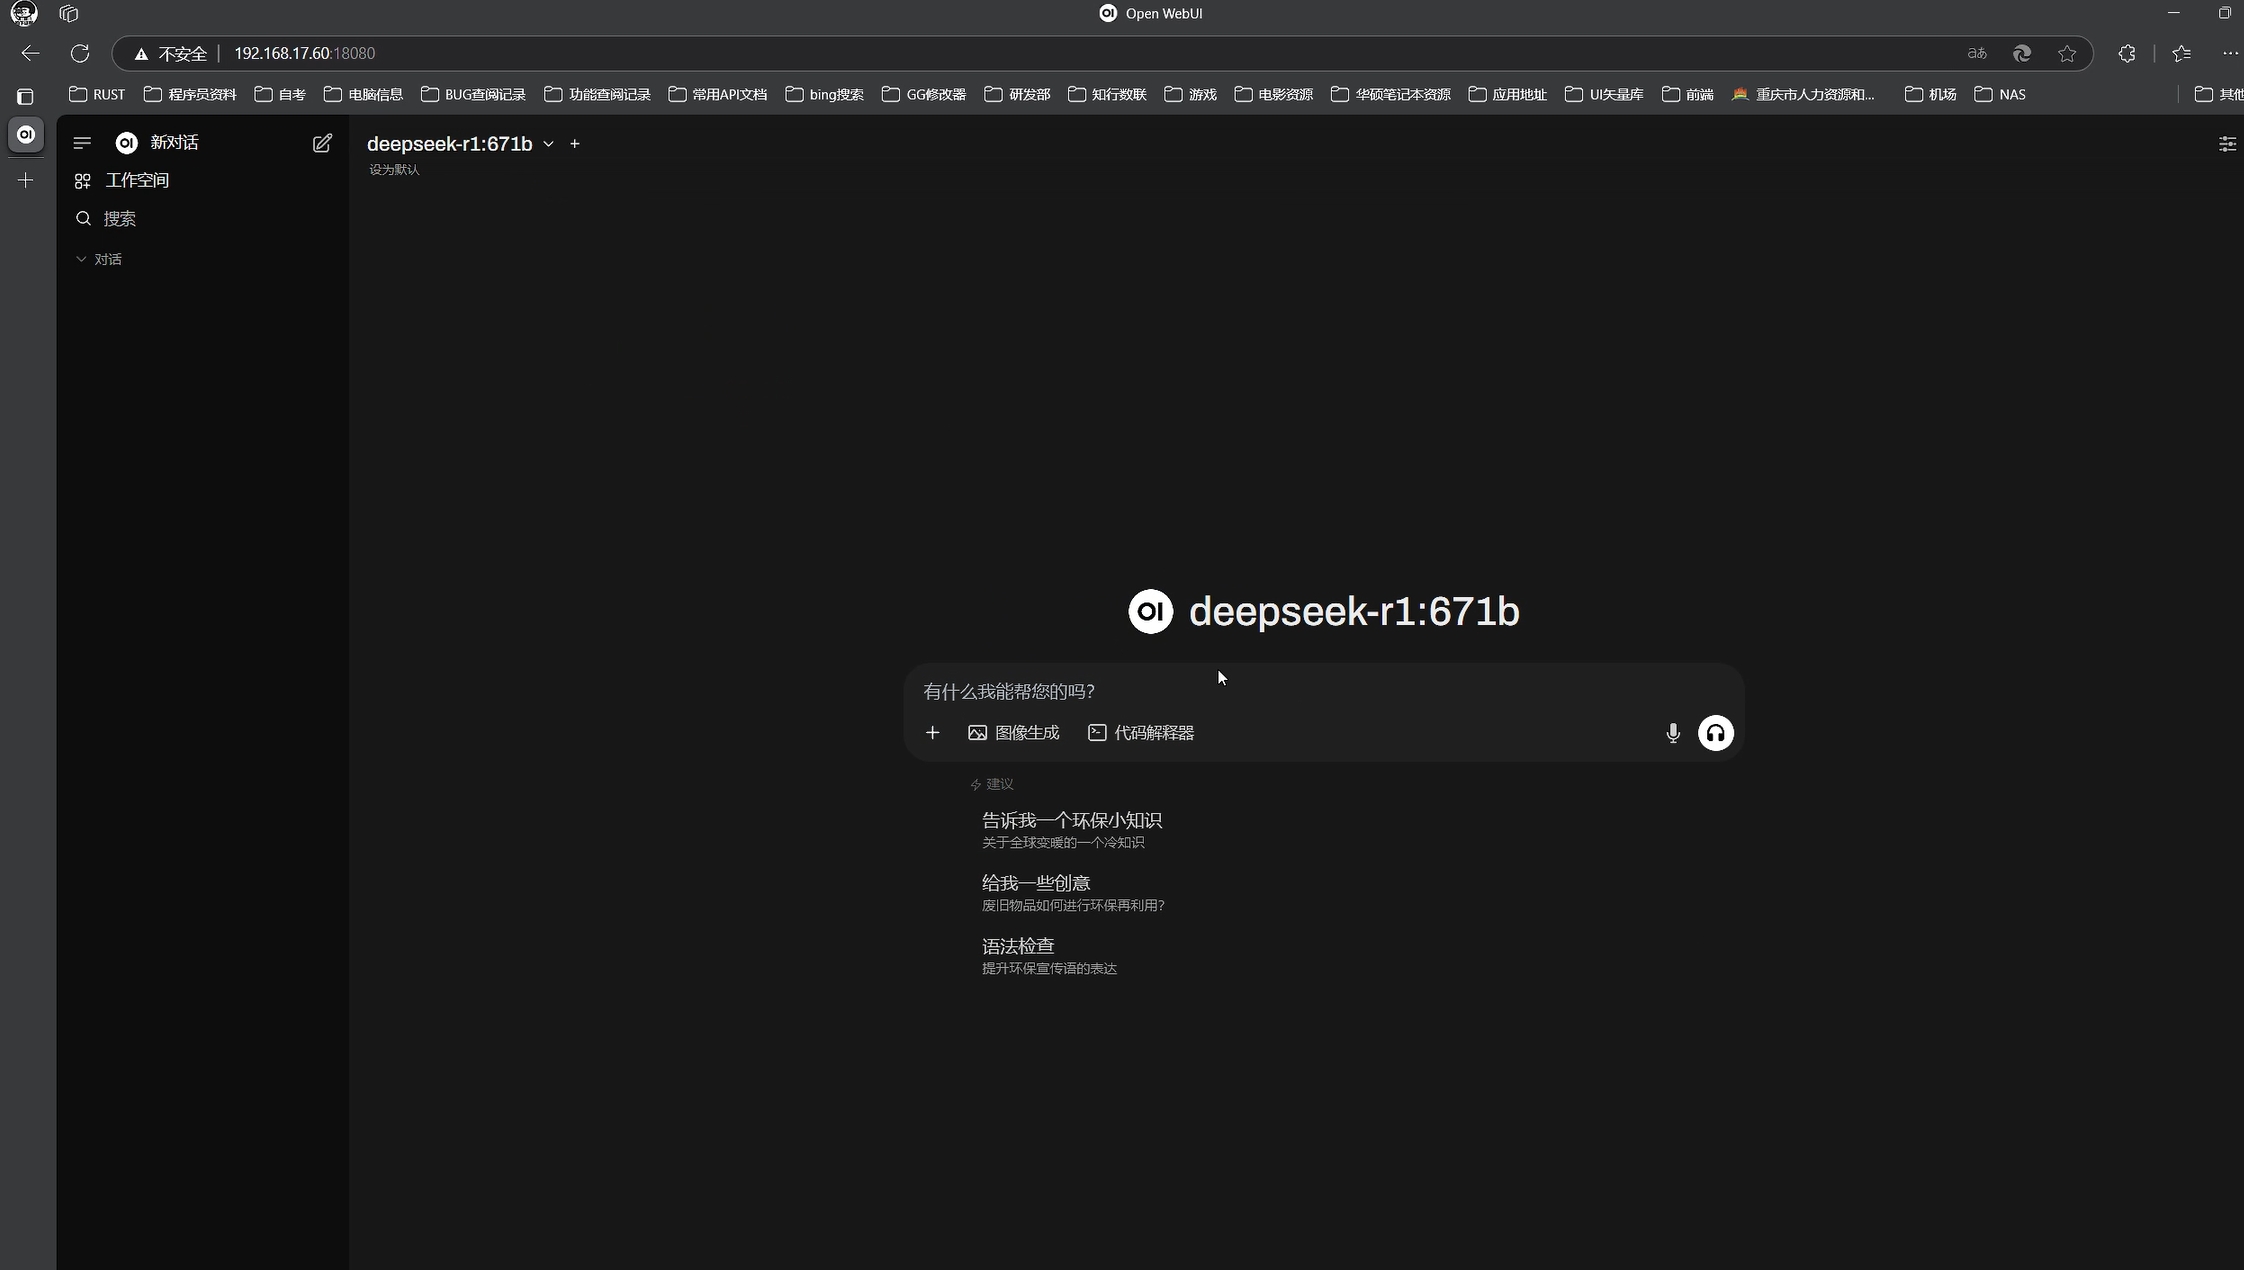
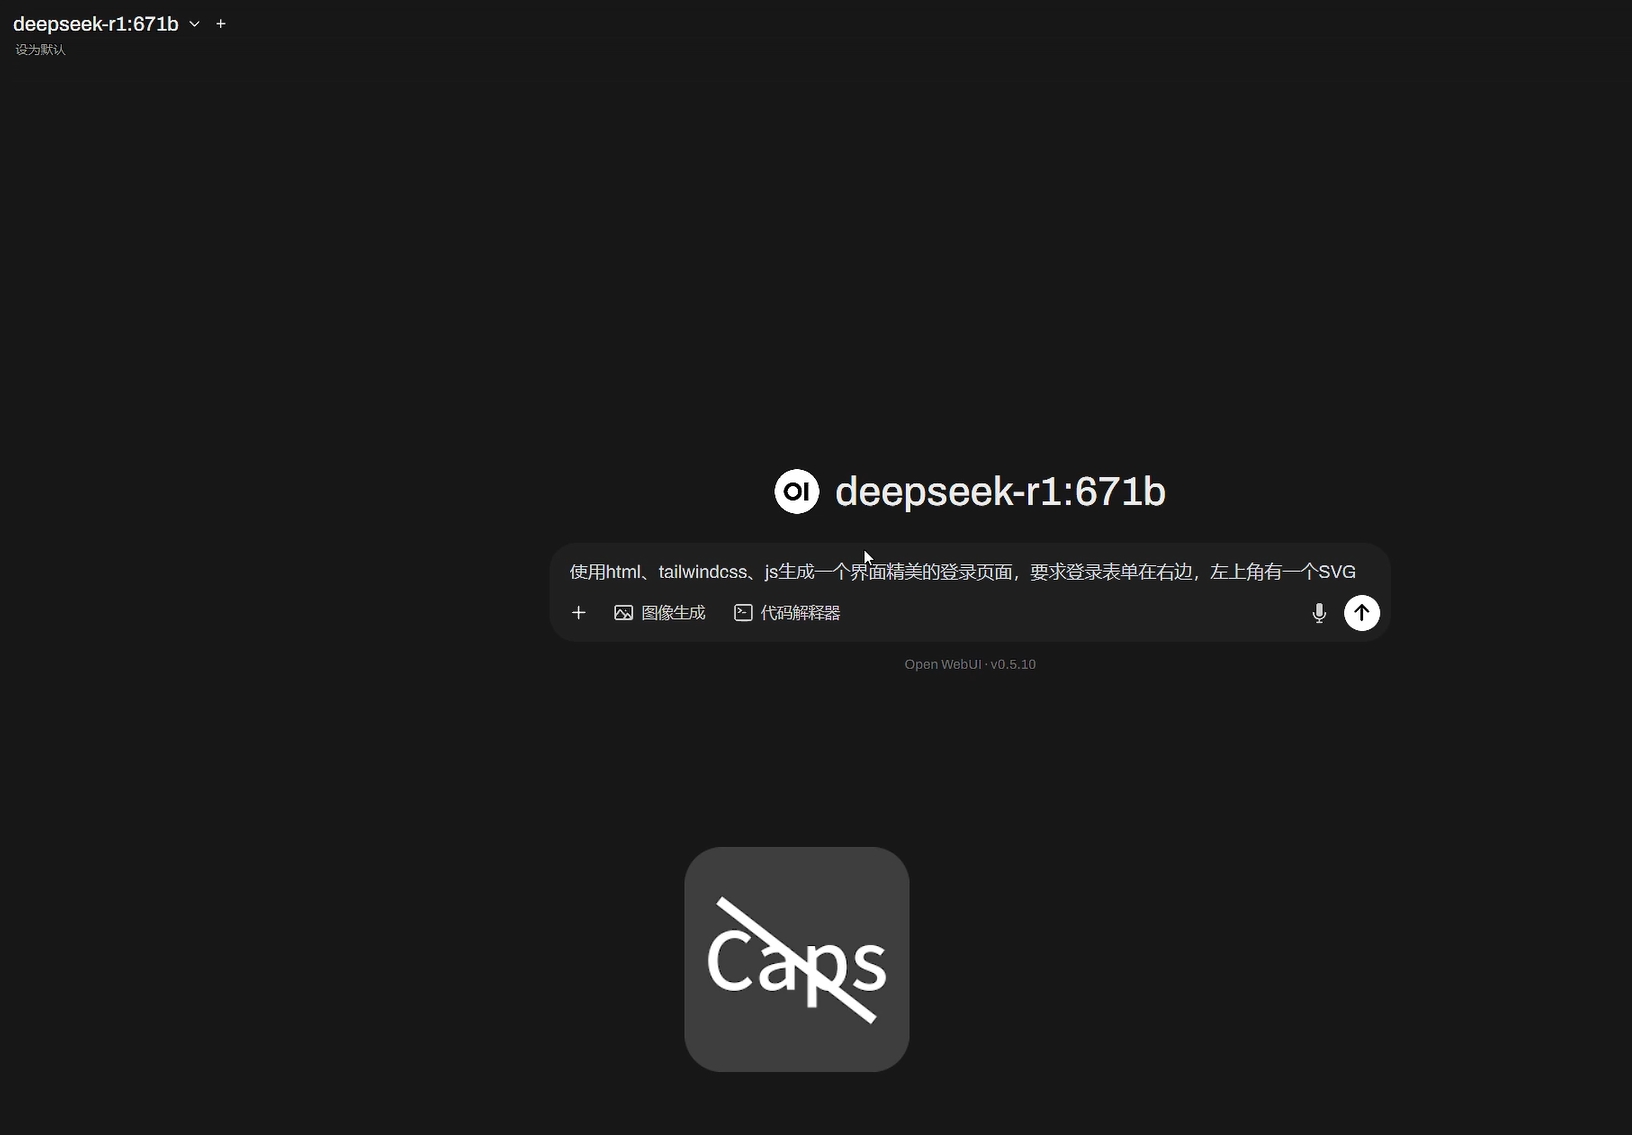
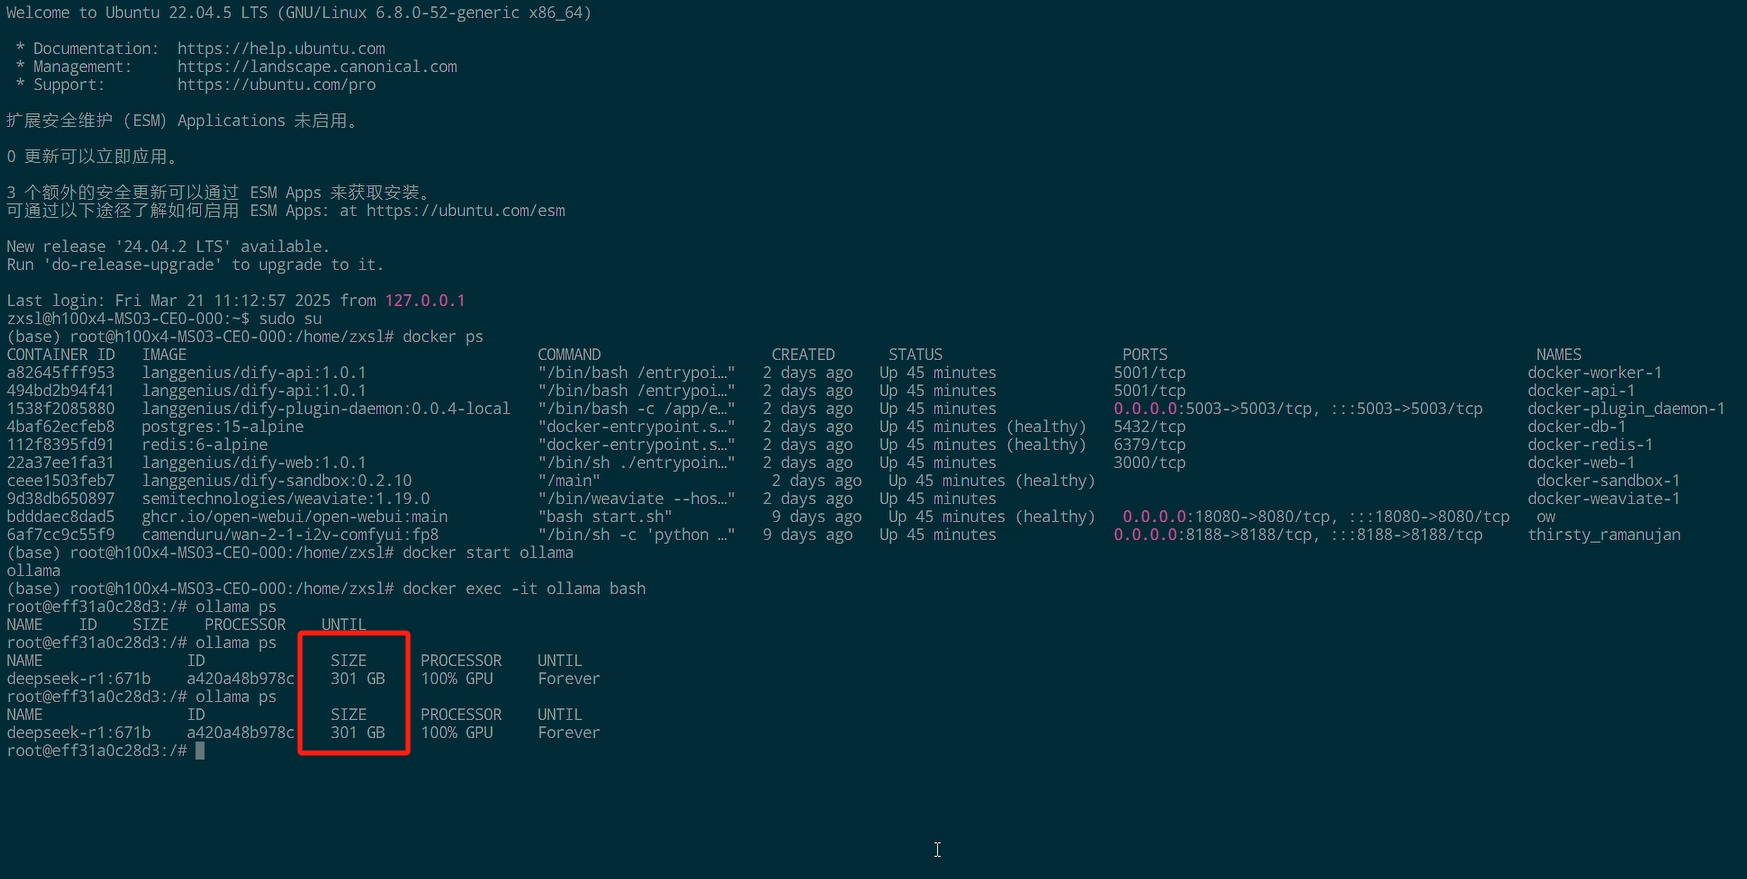
光说不练假把式。我直接上手试了试671B Q2量化模型,需要301GB显存,这四张卡轻松吃下。加载完成后,让它开发一个登录界面,基本是秒为单位完成输出,而且代码质量极高,稍微微调就能直接上线。
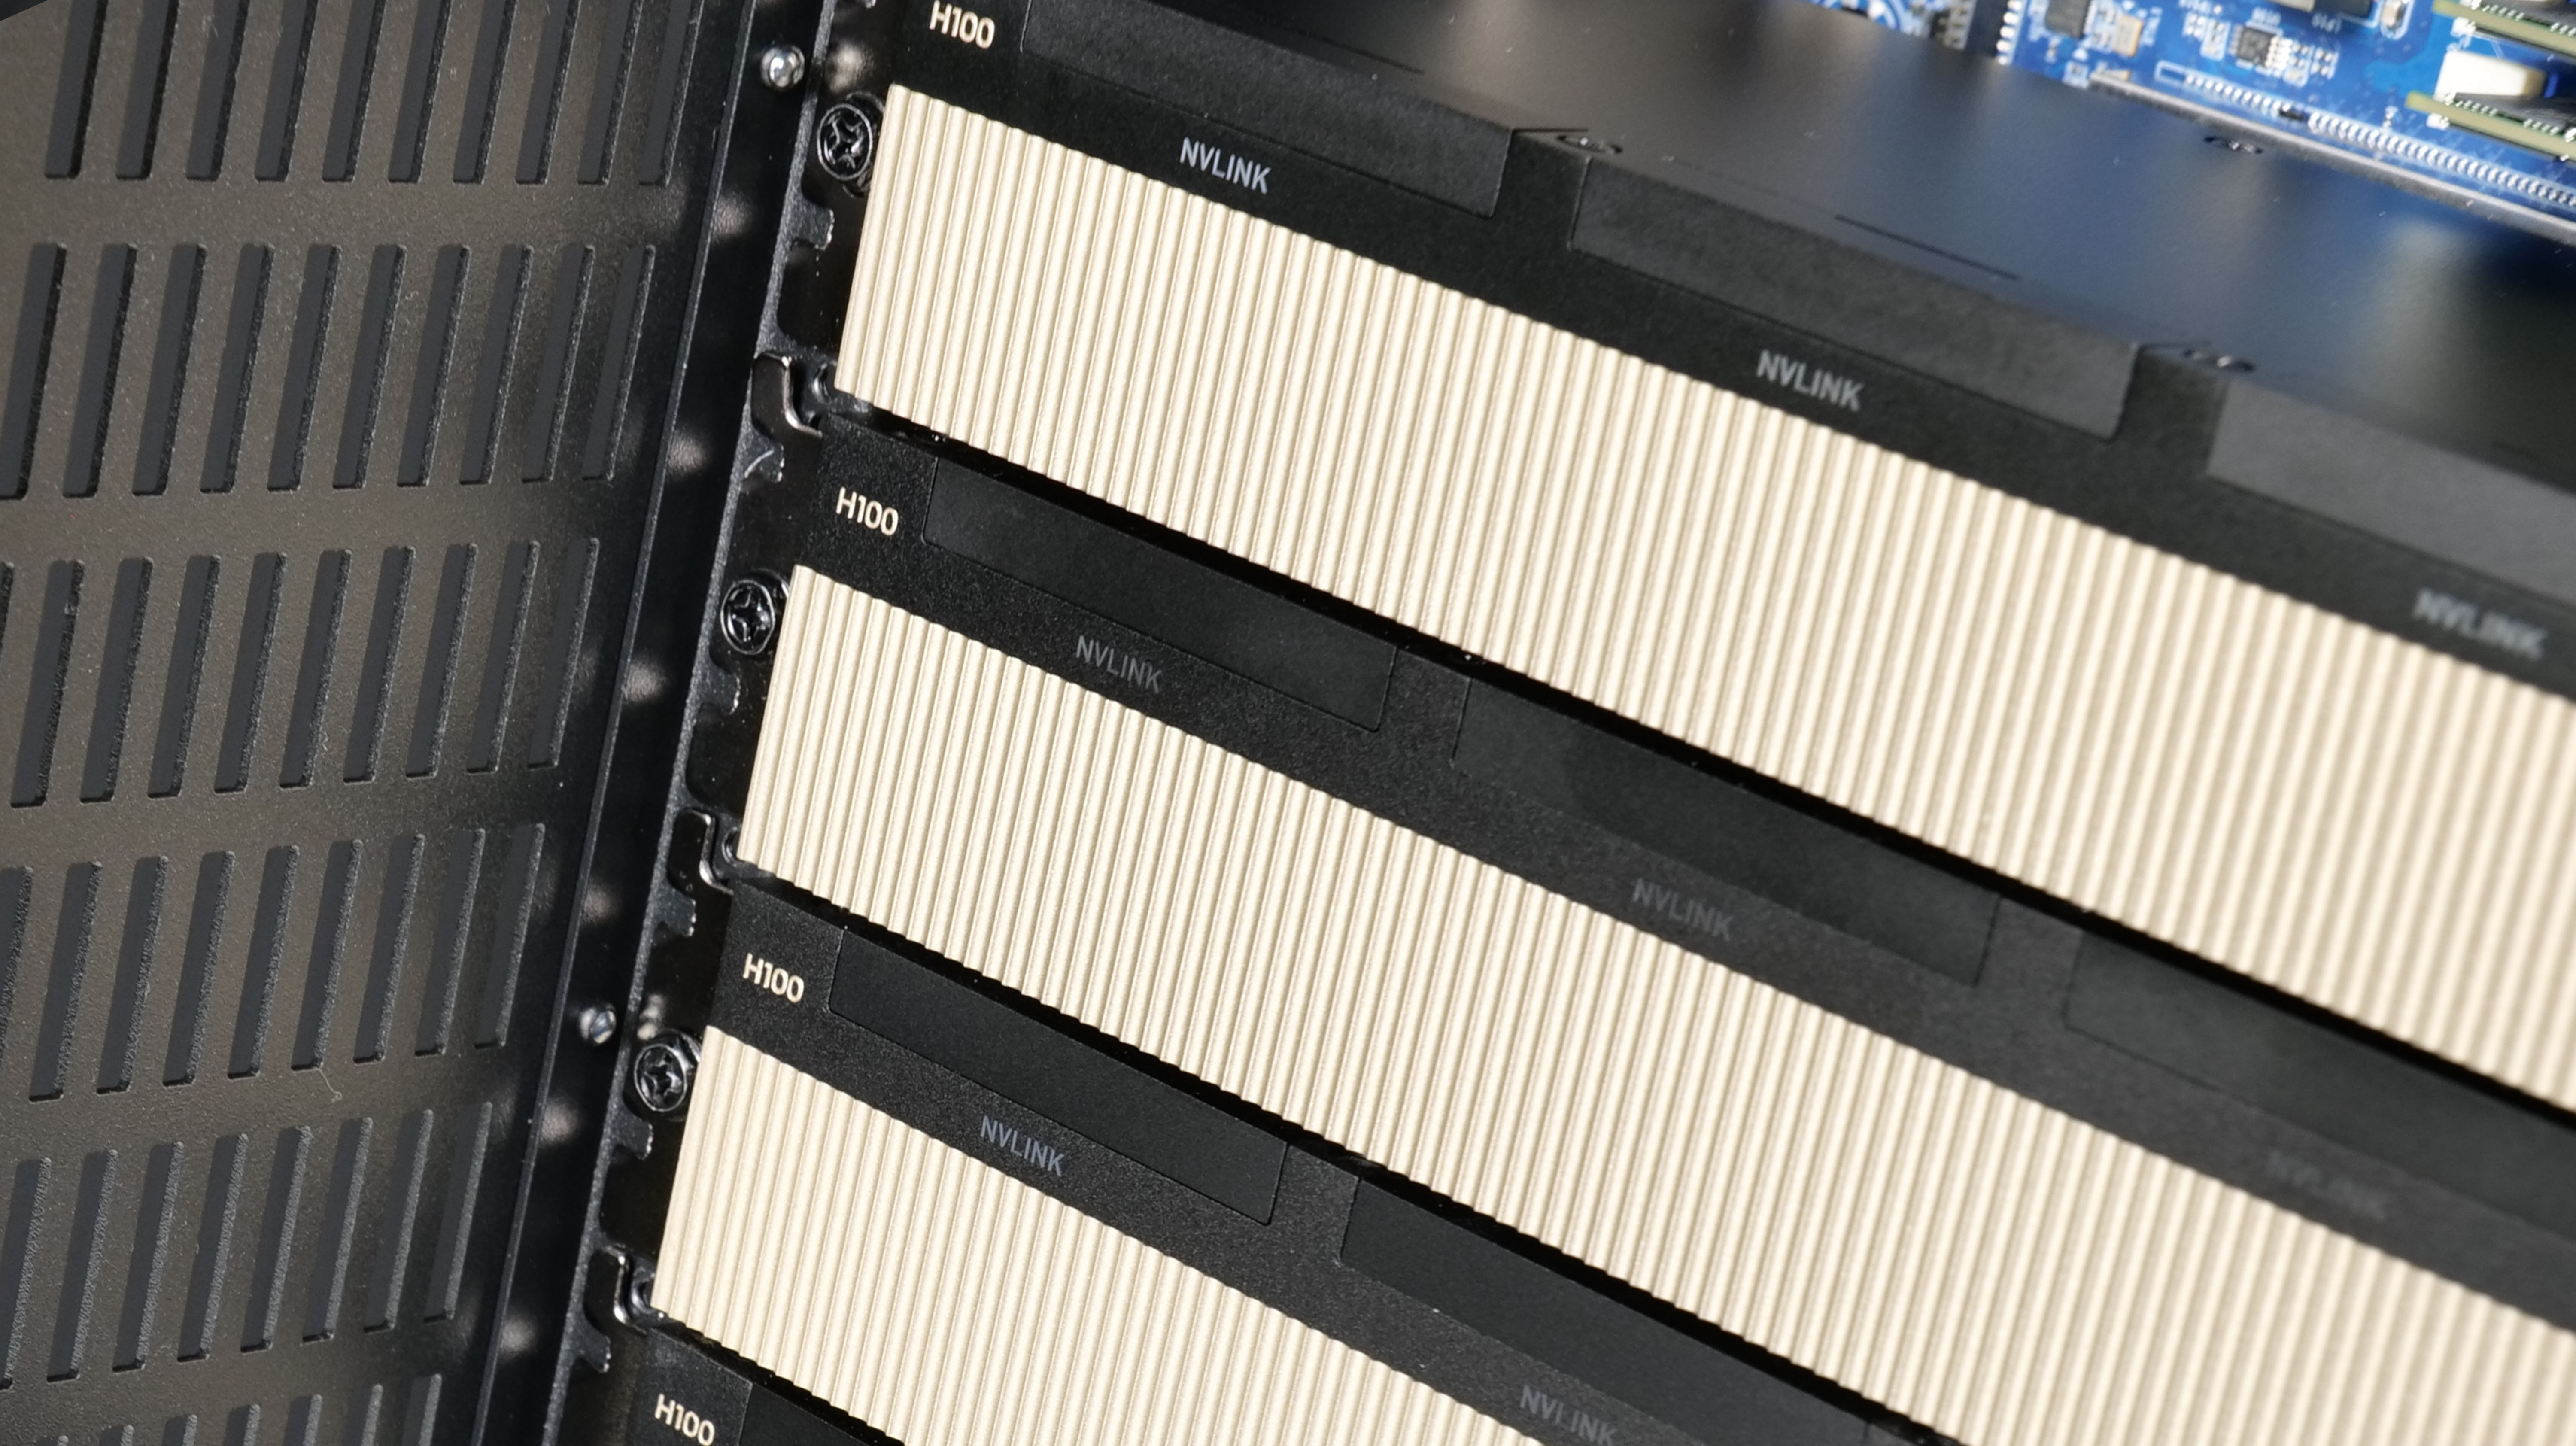
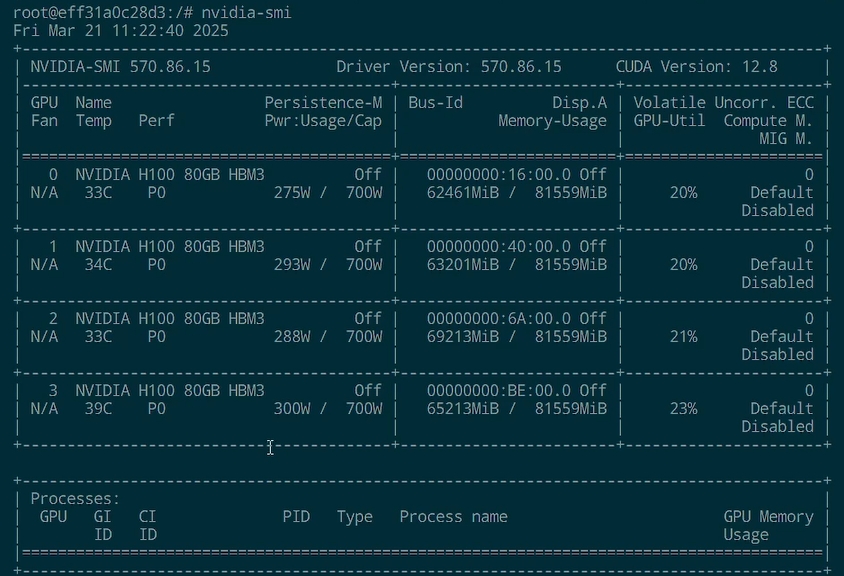
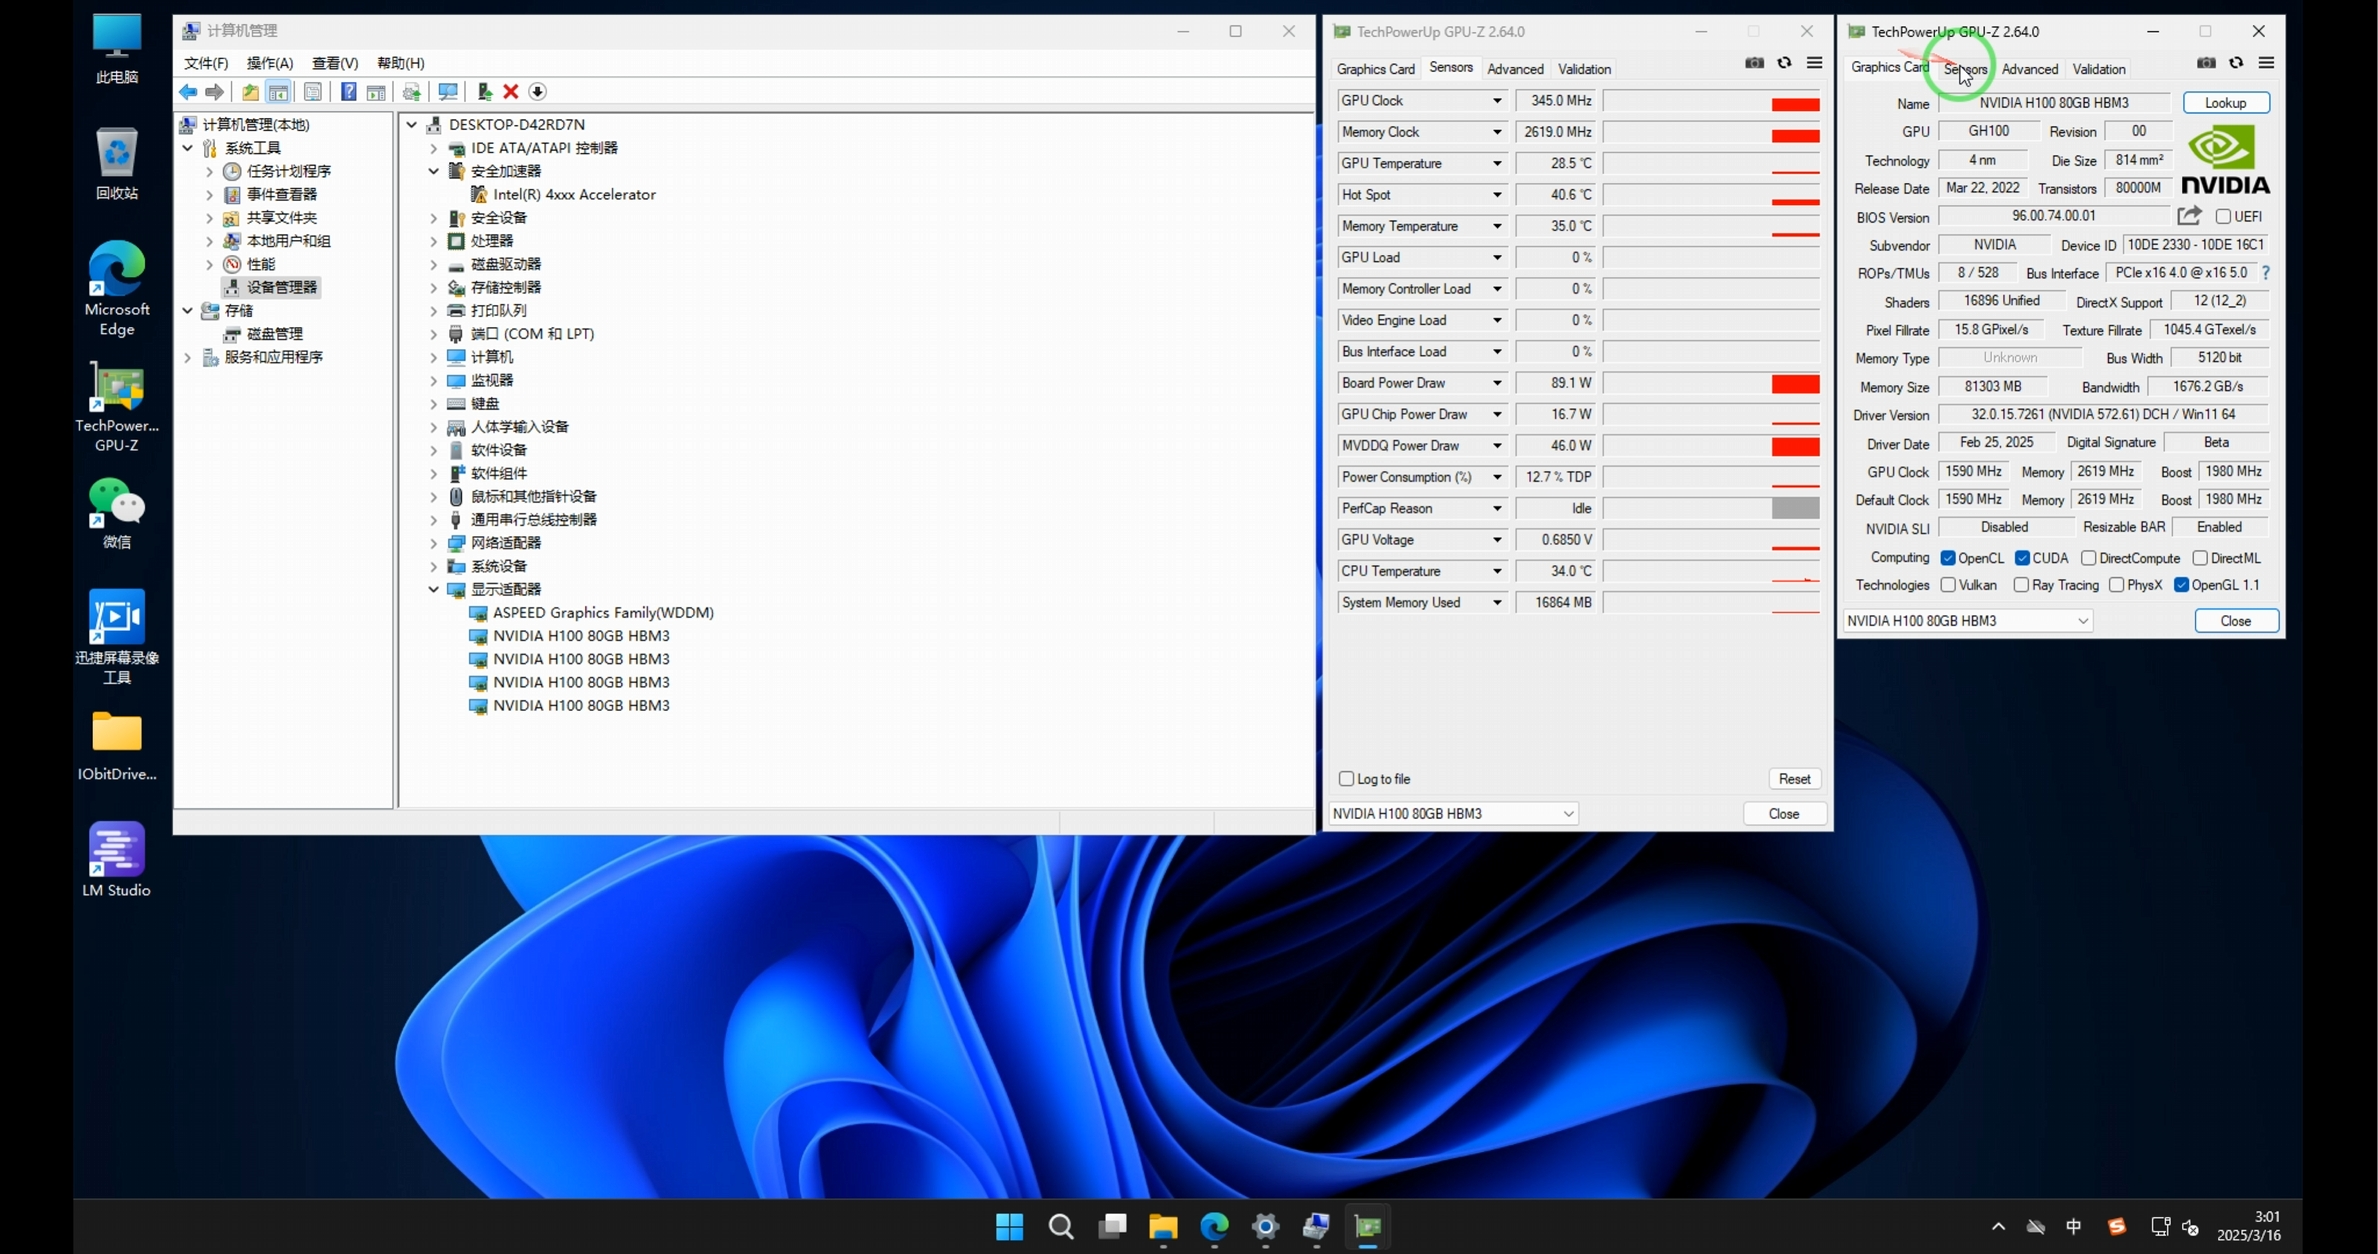
四张卡满载运行时,单卡功耗在300W左右,但温度控制得极好——不超过40度!这得益于技数犬定制的360一体式水冷散热器,把原本适合机架式服务器的涡轮卡改造成了适合PC机箱的水冷方案,噪音和散热都完美解决。
这玩意儿适合谁?
说实话,这套配置不是给普通玩家准备的。适合人群包括:
- AI科研团队:需要本地部署大模型,数据安全要求高,不能上云
- 中小企业/政企单位:内部AI应用开发,需要私有化部署
- 硬核AI发烧友:预算充足,追求极致性能的极客玩家
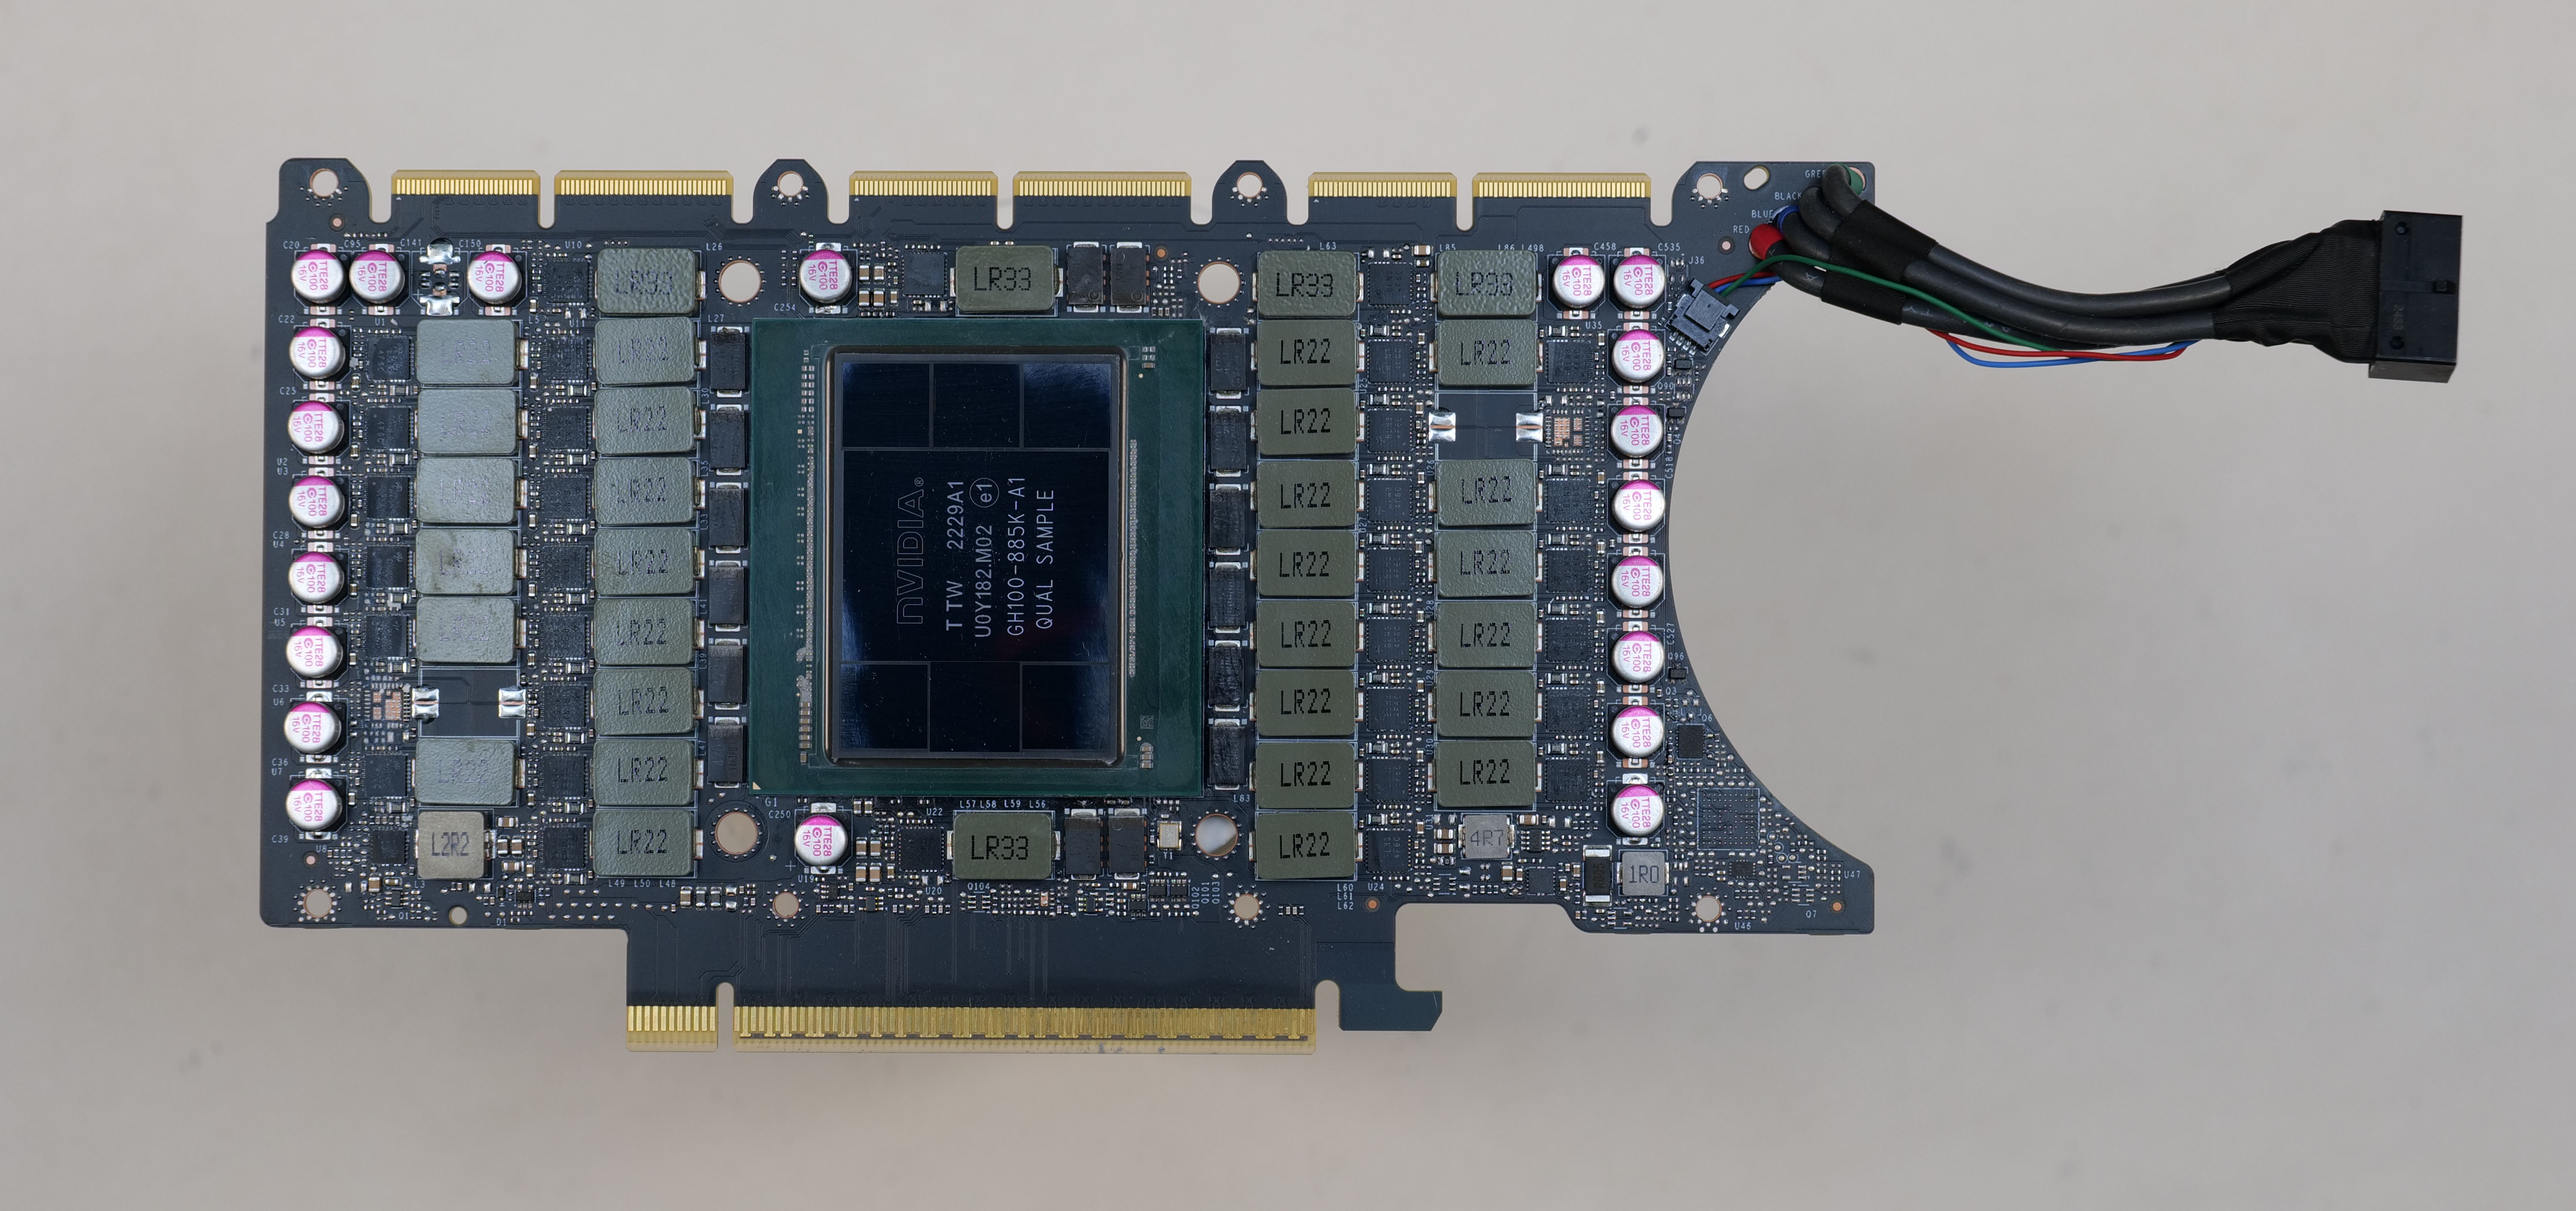
至于预算,我只能说:没有大几十万下不来。四张H100本身就价值不菲,加上整套平台配置,妥妥的“一套房首付”级别。但如果你真的需要本地跑大模型,这钱花得值——省下的云服务费用和等待时间,长期来看是划算的。
我的真实感受
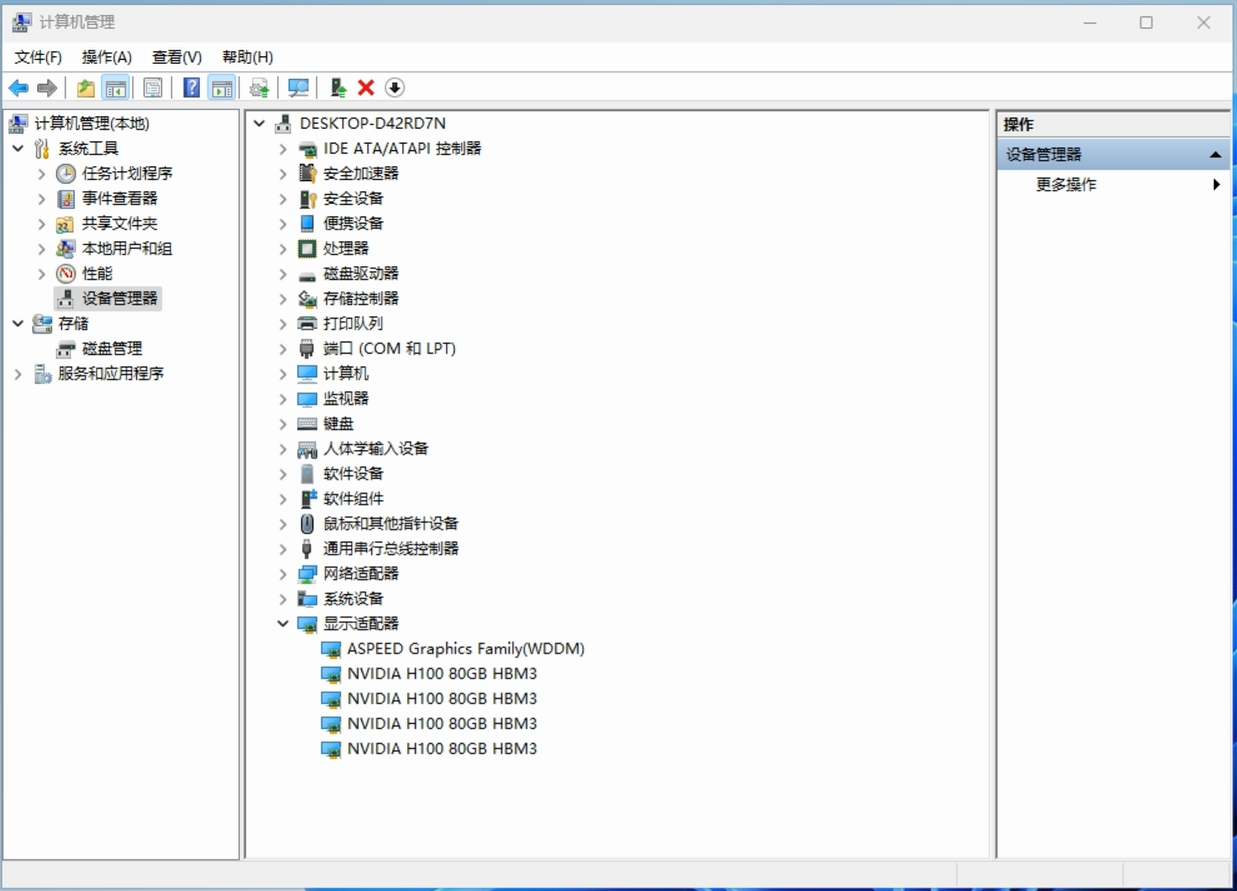
说实话,第一次看到这套机器的时候,我第一反应是“这玩意儿能开机吗?”结果不仅开机了,还装上了Windows 11,日常使用流畅得一批。四张H100在系统里被完美识别,驱动稳定,跑AI任务时性能释放彻底。
最让我惊喜的是散热设计。整机一共5个冷排(CPU一个+四卡各一个),在室温十几度的环境下,满载温度也就40度左右,安静得完全不像一台性能怪兽。
写在最后
这套方案是全网少有的四卡H100个人工作站图文案例,作者后续还会更新双路至强8581C的升级版本,内存突破1TB,性能更恐怖。如果你正在考虑本地部署大模型,这套配置单可以直接抄作业。
最后提醒一句:理性消费,量力而行。如果你只是偶尔跑跑小模型,一张RTX 4090就够用了;但如果你真的需要320GB显存跑千亿级模型,这套方案就是你的终极答案。
关注我,后续还有更多硬核数码内容! 🔥
产品图集