机器人界的“卖水人”火了!半年融资170亿,这个00后团队凭什么?
🤖 你有没有想过,当我们在网上刷视频、聊AI的时候,有一群人正在疯狂“喂”机器人吃饭——不是喂米饭,而是喂数据。
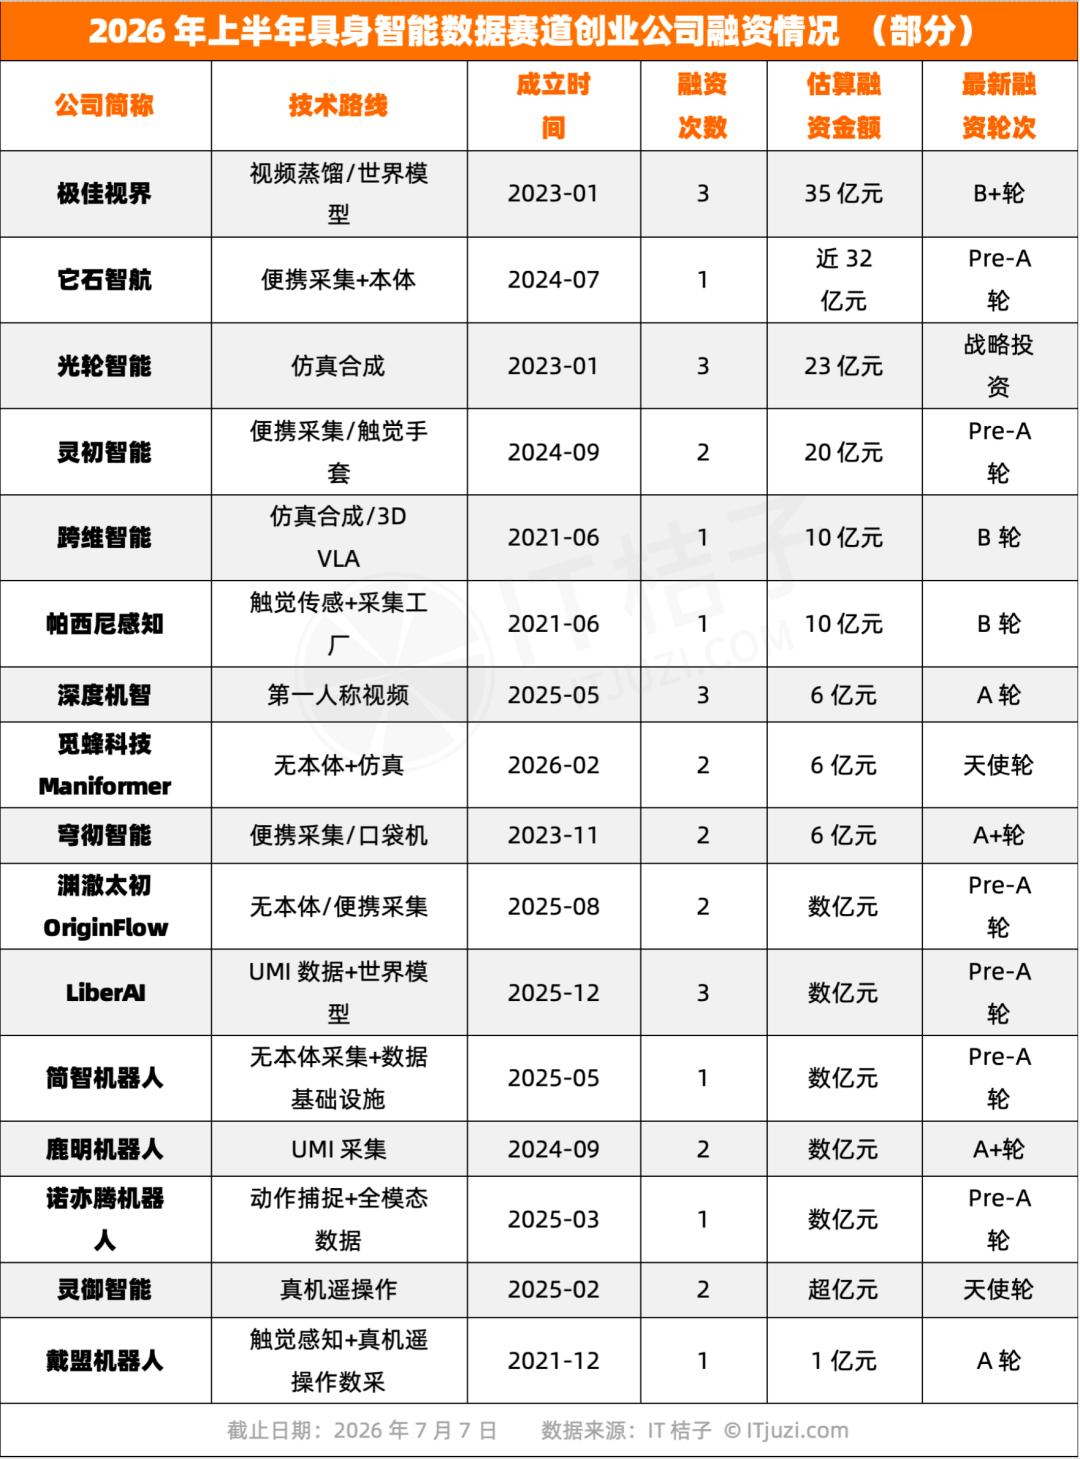
最近,一个叫LiberAI的团队火了。成立8个月,融资5轮,估值飙到50亿。创始人是个00后,清华计算机系特等奖学金得主,23岁博士毕业就出来创业。这履历,简直像开了挂。
但更让我震惊的是,整个具身智能数据赛道,2026年上半年25家公司合计融资超170亿元。当所有人都在造机器人、抢“淘金”的时候,这群人默默干起了“卖铲子”的生意,而且赚得盆满钵满。
为什么机器人也需要“吃饭”?
先别急着划走,这事儿跟你我都有关系。
大语言模型为什么这么聪明?因为互联网上有海量的文字数据可以“喂”给它。但机器人不一样——它需要学习的是“拿杯子”“拧瓶盖”“颠勺”这种三维物理动作。这些数据,互联网上根本没有!
就像教一个孩子做菜,光看菜谱没用,得手把手教他切菜、翻炒、控火候。机器人也一样,需要真实世界的动作数据来训练。
这就是为什么“数据”成了具身智能赛道最确定的一门生意。Grand View Research预测,全球数据采集与标注市场2030年将达171亿美元。
五大流派,谁在“印”数据?
现在这个赛道,已经分出了五大流派,各有各的绝活:
流派一:真机遥操派——把数据当流水线做 最激进的是帕西尼感知,在天津建了全球最大的具身数据采集工厂,年产2亿条数据。3月完成超10亿元B轮,估值破百亿后,又宣布再建四座超级工厂。这扩张速度,比奶茶店还快!
还有诺亦腾机器人,创始人戴若犁曾做到全球专业动捕市场70%份额,现在带着全模态数据平台卷土重来,估值约30亿元。
流派二:仿真合成派——在虚拟世界里“印刷”数据 如果真实数据太贵,能不能在电脑里造一个物理足够真实的虚拟世界,批量“印刷”训练数据?
这条路跑出了全球第一个具身数据独角兽:光轮智能。2026年一季度新增订单5.5亿元,一个季度超过去年全年。这赚钱速度,比印钞机还快!
流派三:UMI无本体采集派——绕开机器人本体,“复刻”人手动作 这个流派更聪明——既然机器人贵,那就让人戴上便携设备采集动作数据,再“复刻”给机器人。成本低、效率高,还能量产。
数据“卖铲人”凭什么这么赚钱?
说白了,这就是一个“基础设施”生意。就像淘金热时期,真正赚大钱的不是淘金者,而是卖铲子、卖牛仔裤的人。
现在机器人赛道百花齐放,但大家都缺数据。谁掌握了高质量的数据,谁就掌握了机器人的“智商”。所以,这些数据公司成了资本追捧的香饽饽。
光轮智能2025年营收增长10倍,2026年一季度新增订单5.5亿元。跨维智能上半年营收1亿元,已有超1500套模型完成商业化交付。这数据,比很多“淘金”的机器人本体公司都好看。
普通人能从中看到什么?
虽然咱们普通人没法直接投资这些公司,但可以从中学到一个道理:当风口来的时候,与其挤破头去追风口,不如想想风口需要什么“铲子”。
就像现在,大家都在讨论机器人会不会取代人类工作,但真正赚钱的,是那些给机器人“喂饭”的人。
最后说句实在话,这个赛道现在估值确实有点“疯”。但谁让机器人是未来呢?就像当年的互联网,泡沫归泡沫,趋势归趋势。咱们吃瓜群众,看看热闹就好,顺便想想自己能不能也找到属于自己的“铲子”🔧
适合人群:对AI、机器人、科技投资感兴趣的朋友 预算区间:免费吃瓜,或者关注相关ETF和基金 温馨提示:投资有风险,吃瓜需谨慎,别被估值数字冲昏头脑~