告别GPU焦虑!Cloudflare Workers AI:让Hugging Face模型秒变“按需付费”神器 🚀
你是不是也有过这样的经历?👇
想部署一个开源大模型(比如Llama、Mistral)跑个AI应用,结果一看GPU价格瞬间清醒——租一张A100动辄每小时几十块,还得自己配服务器、调环境、处理高并发……最后算下来,项目还没上线,钱包先“瘦身”成功。
别慌,今天给大家安利一个能让你“白嫖”顶级GPU算力的骚操作:Cloudflare Workers AI 正式接入 Hugging Face Hub!简单来说,以后你可以在Cloudflare遍布全球的边缘节点上,用无服务器模式直接调用Hugging Face上的热门开源模型,按请求付费,不用管服务器,简直是小团队和独立开发者的福音!
这玩意儿到底解决了什么痛点?🤔
咱们都知道,Hugging Face是AI界的“GitHub”,模型多到挑花眼。但“模型好用,部署要命”是通病:
- GPU稀缺且贵:好卡买不到,买到了心疼电费。
- 固定成本高:哪怕你的应用只有1个用户,服务器也得24小时开机烧钱。
- 运维复杂:版本更新、依赖冲突、扩缩容……每一项都让人头秃。
而Cloudflare Workers AI这套新服务,直接把Hugging Face上的热门模型(比如Llama 2、Gemma、Mistral)打包成API接口。你不需要知道GPU长啥样,只需要写几行代码,请求发出去,Cloudflare的全球边缘网络就会自动调度空闲GPU帮你跑推理,用多少付多少,闲置不花钱。
划重点!这个“按请求计费”有多香?💰
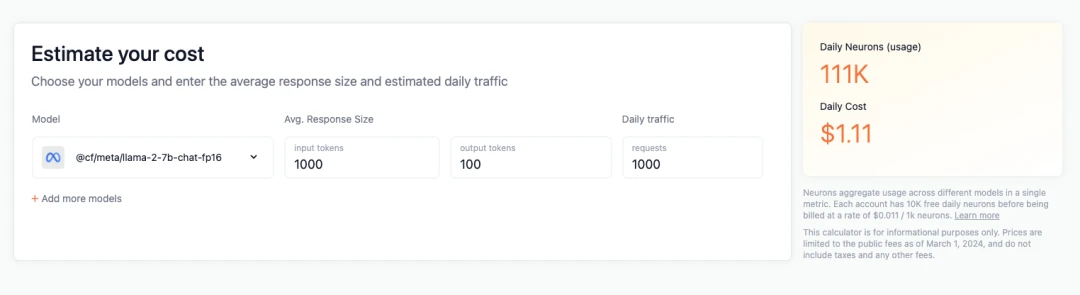
官方给了一个超直观的例子:假设你做了一个RAG(检索增强生成)应用,每天处理1000个请求,每个请求包含1000个输入Token和100个输出Token,用的是Meta Llama 2 7B模型。
猜猜一天成本多少?只要1美元! 💵
这什么概念?以前你可能得租一台带GPU的云服务器,一个月固定支出几百上千,现在直接砍到一杯咖啡钱/天。对于个人开发者做Side Project,或者初创公司验证MVP,这个成本结构简直友好到哭。

上手有多简单?三步走!👣
别被“无服务器”吓到,操作比点外卖还简单:
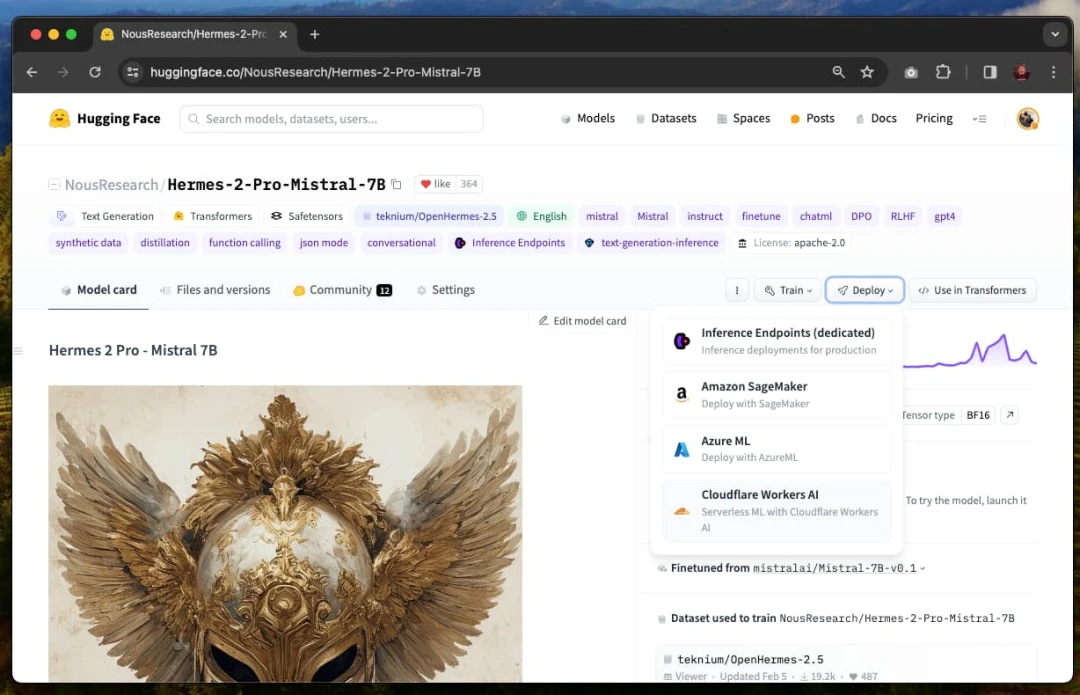
- 找到模型:在Hugging Face上搜索你想要的模型(比如超火的Mistral 7B Hermes 2 Pro),在模型页面找到“部署”按钮。
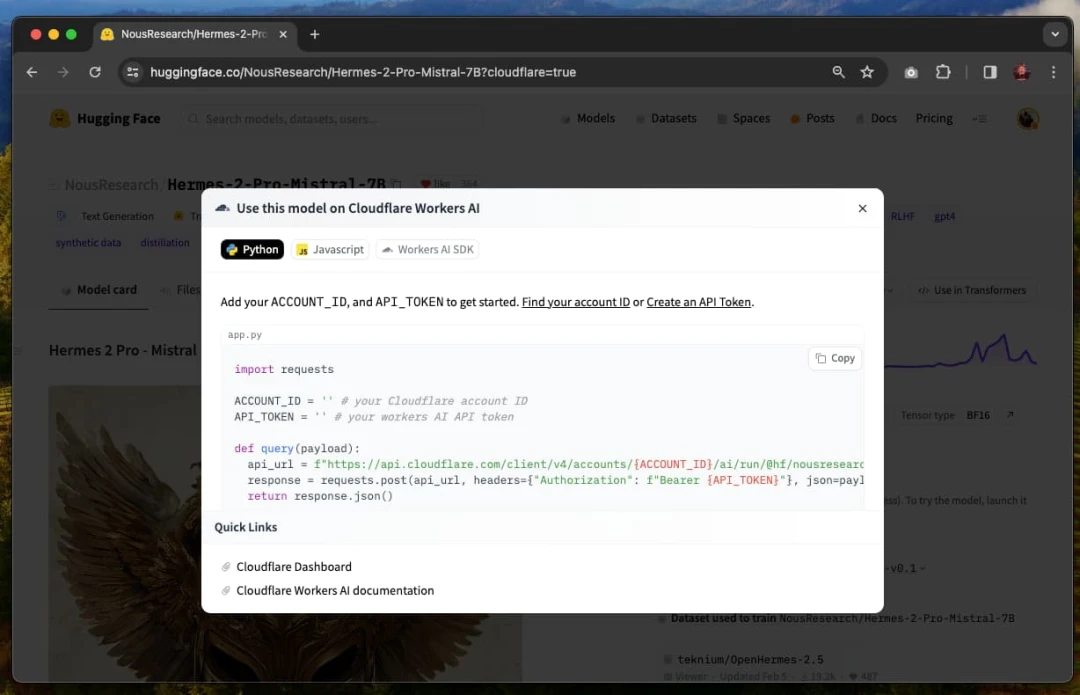
- 选择Cloudflare Workers AI:点击后会直接跳转到一个带示例代码的界面。
- 复制代码,跑起来:你可以选择用REST API,或者直接在Workers里用Cloudflare AI SDK。只需要设置好
ACCOUNT_ID和API_TOKEN两个环境变量,就完事儿了。

官方还贴心地做了一个Cloudflare精选模型集合,目前支持Llama、Gemma、Mistral等主流开源模型。如果你想要的模型暂时没上架,也可以提交请求催更。
我的真实体验:边缘计算真的快⚡️
我试着用Workers AI跑了一个文本生成任务,最大的感受是响应速度飞快。因为Cloudflare的节点遍布全球,请求会自动路由到离你最近的GPU上,几乎感觉不到“冷启动”延迟。而且完全不用操心并发——哪怕瞬间涌进来1000个请求,它也能自动弹性扩容,不会像自己搭的服务器那样直接“502”。
对于开发者来说,这意味着你可以把精力全部放在应用逻辑上,而不是跟基础设施斗智斗勇。比如我最近在做一个AI聊天机器人,以前最头疼的就是晚上流量高峰时服务器CPU飙红,现在换成Workers AI后,彻底“躺平”了,账单还降了一半多。

适合谁用?我的掏心窝建议 💡
- 独立开发者 / 学生党:预算有限但想玩转大模型,按需付费模式让你每天花几毛钱就能跑实验。
- 初创团队:快速验证AI产品原型,不用一开始就背上沉重的服务器成本。
- 企业级应用:如果业务有周期性波动(比如白天流量大、晚上闲置),无服务器模式能帮你省下大笔闲置资源费用。
预算参考:没有固定月费,完全看调用量。轻度使用(每天几百次请求)月成本可能就几美元;重度使用(每天几万次请求)也就几十到几百美元,比自建GPU服务器划算太多。
最后说两句真心话 ❤️
Cloudflare和Hugging Face这次联手,算是把“AI民主化”又往前推了一大步。它不炫技,不搞花活,就是实打实地把GPU算力变成了水电煤一样的基础设施——打开开关就能用,按表计费。
如果你正在为“GPU太贵”或“部署太烦”而头疼,真心建议去试试这个服务。也许,你的下一个爆款AI应用,就差这一步“零门槛部署”的距离。
传送门:👉 Cloudflare Workers AI 官方文档 | Hugging Face 模型集合
(温馨提示:需要先注册Cloudflare账号并获取API令牌哦~)