
500亿估值背后的“价格屠夫”:Kimi K3如何用14天改写AI大模型格局?
你是否还在为每月几百块的AI订阅费肉疼?或者因为大模型“答非所问”而血压飙升?最近,AI圈发生了一件大事,直接让整个行业的价格体系“地震”了——月之暗面(Moonshot AI)带着他们的最新力作Kimi K3,不仅把估值推上了500亿美元,更可能让你我这样的普通用户,用上更便宜、更聪明的AI。
14天,估值暴涨150亿美元,这不是融资,是重新定价
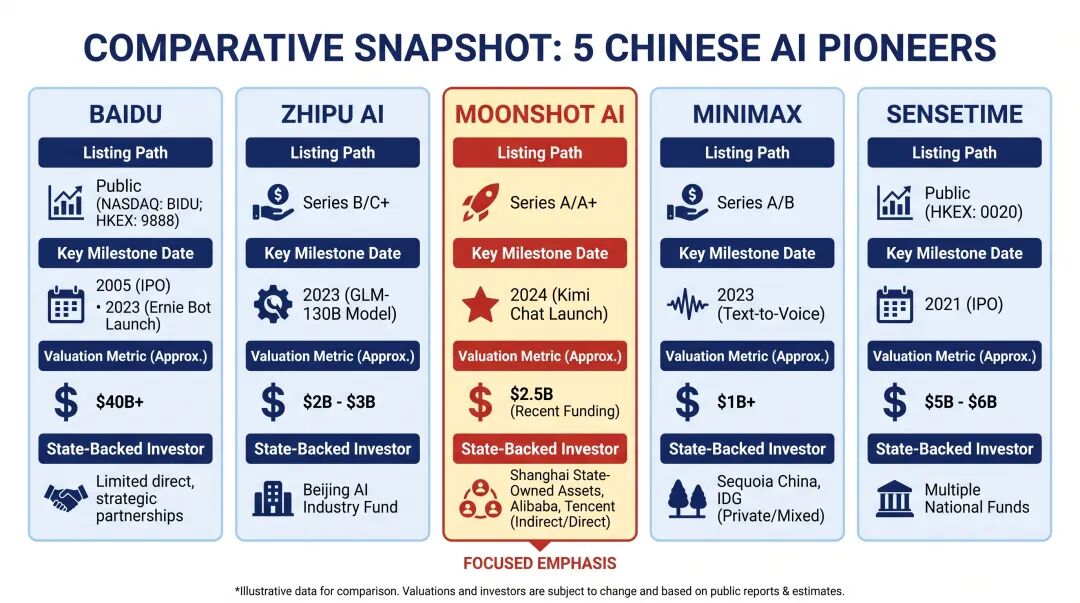
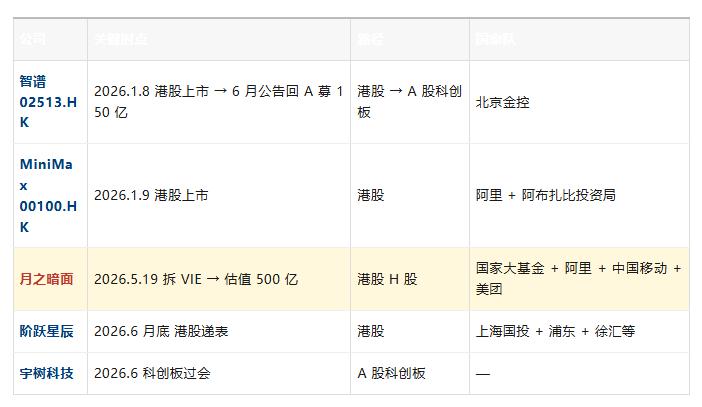
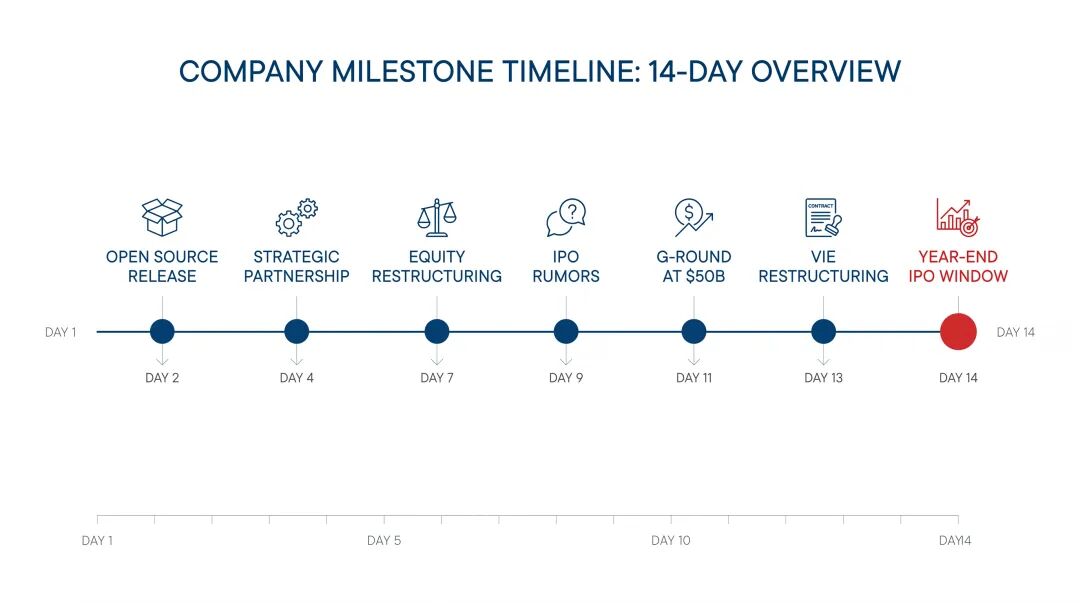
故事要从7月26日说起。那天晚上,月之暗面干了一件“疯狂”的事:把拥有2.8万亿参数的Kimi K3完整权重,直接开源扔到了Hugging Face上。这就像武林高手直接把自己毕生绝学的秘籍公之于众,底气可见一斑。紧接着,微软官宣接入、公司股改、Pre-IPO轮启动……一套组合拳下来,14天内估值从350亿冲到500亿美元。这背后,是市场对K3技术实力的“用脚投票”。
K3凭什么这么“豪横”?三个硬核证据告诉你答案
很多人会问,500亿估值是不是泡沫?K3用三个硬核证据告诉你,什么叫“物超所值”。
证据一:价格屠夫,性价比碾压GPT-4o
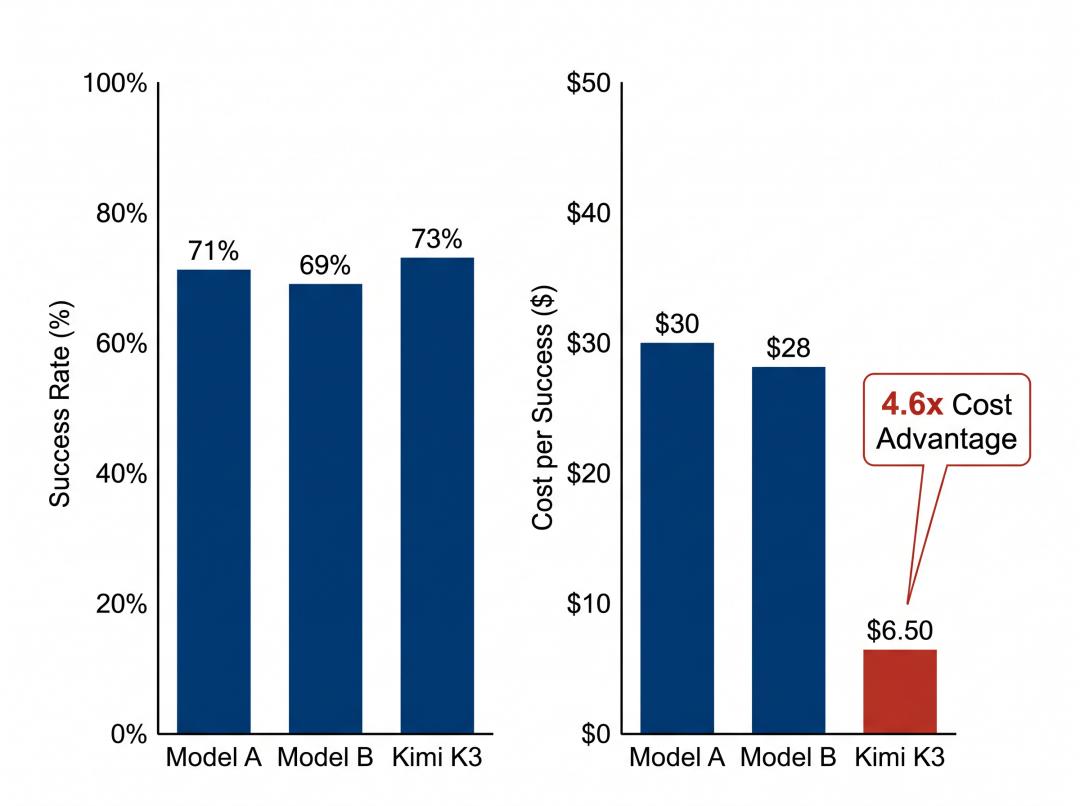
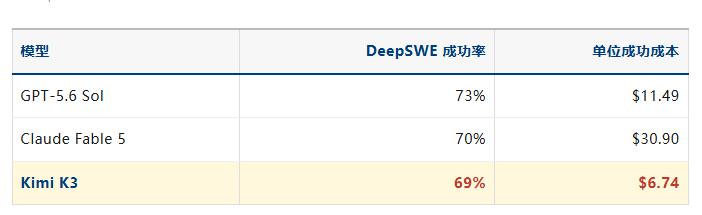
在衡量AI编程能力的DeepSWE基准测试中,K3的成功率达到了69%,只比顶尖的闭源模型低4个百分点。但重点来了——它的单位成功成本仅为6.74美元,而对手的成本是它的4.6倍!这意味着,同样完成一个任务,用K3可能只要几块钱,用别的模型可能要几十块。输入价格每百万token仅3美元,命中缓存后更是低至0.3美元。对于开发者和小微企业来说,这简直是“白菜价”的顶级生产力。
证据二:架构创新,便宜不是“烧钱补贴”
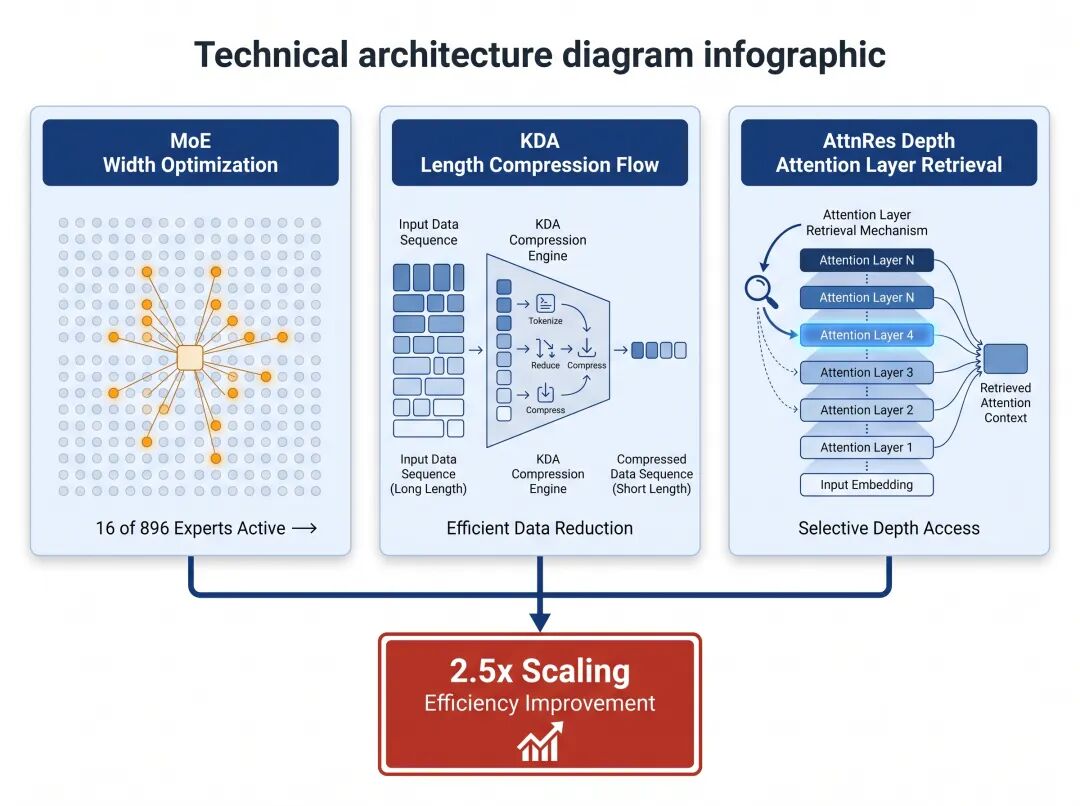
K3的便宜,不是靠烧钱补贴换来的,而是源于架构层面的颠覆性创新。它采用了MoE(混合专家)架构,拥有896个路由专家,但处理每个token只激活16个,大大降低了计算量。同时,通过KDA(键值缓存压缩) 技术,处理百万token长文本时能节省75%的缓存。再加上AttnRes(注意力恢复) 机制,用2%的延迟换来了1.25倍的性能提升。这套“三件套”组合拳,让K3的缩放效率比上一代提升了2.5倍。简单说,同样的算力,K3能换来2.5倍的智能,这种成本优势是竞争对手短期内无法复制的。
证据三:主动“自曝短板”,反而赢得信任
最让人意外的是,K3在发布会上没有“王婆卖瓜”,反而主动承认了自己的短板:综合能力排名第三,甚至坦白幻觉率从39%涨到了51%。这种“自爆”行为,在商业上看似“不智”,却向市场传递了一个强烈的信号:我们数据透明,我们敢于直面问题。对于投资人来说,这种诚实比天花乱坠的吹嘘更有说服力。
我的真实体验:从“够用”到“好用”的质变
作为一个每天要和大量文档、代码打交道的数码博主,我第一时间体验了K3。最直观的感受是,它在处理长文本时,上下文理解能力有了质的飞跃。以前让AI总结一份几十页的PDF,它经常“断片”,但K3能准确抓住前后文的逻辑关联,甚至能帮我梳理出隐藏在字里行间的“潜台词”。
更让我惊喜的是它的编程能力。在调试一段复杂的Python代码时,K3不仅指出了错误,还给出了两种不同的优化方案,并解释了各自的优劣。这种“教练级”的辅助,确实让工作效率提升了不少。虽然它在某些创意写作上还略显“直男”,但考虑到它仅为对手几分之一的成本,这点小瑕疵完全在接受范围内。
购买建议:谁适合为K3“买单”?
说了这么多,K3到底适合谁呢?
开发者/科技公司:如果你需要API来处理海量数据或构建AI应用,K3的超高性价比是不二之选。它能帮你把成本打下来,预算直接“省出一个亿”。 重度AI用户:如果你每天都要用AI辅助工作、学习,K3的低廉价格能让你实现“AI自由”,不再为每次提问精打细算。
- 预算敏感型用户:学生党、自由职业者,K3的开源版本和低价API,让你用极低的门槛体验顶级大模型的能力。
总结一下:
Kimi K3不仅仅是一个模型,它更像是一个“价格屠夫”,用技术创新打破了高端AI的“价格壁垒”。它让我们看到,强大与实惠可以兼得。如果你正在寻找一个聪明、高效且不“烧钱”的AI助手,Kimi K3绝对值得你重点关注。毕竟,谁会和性价比过不去呢?😉
| 参数 | 规格 | | — | — | | 架构 | MoE混合专家 + KDA + AttnRes | | 总参数量 | 2.8万亿 | | 激活参数 | 每token仅激活16/896个专家 | | 输入价格 | $3/百万tokens (缓存命中$0.3) | | 输出价格 | $15/百万tokens | | DeepSWE成功率 | 69% | | 单位成功成本 | $6.74 |
产品图集